
Claude Fable 5.1: что нового во флагманской модели Anthropic — бенчмарки, цена и отличия от Fable 5
1 сентября 2026 года Anthropic представила Claude Fable 5.1 — новую флагманскую модель для кодинга, работы со знаниями и долгих агентных задач. Согласно официальному анонсу Anthropic, это прямой преемник Fable 5: умнее, точнее в программировании и науке, заметно дешевле в агентных сценариях.
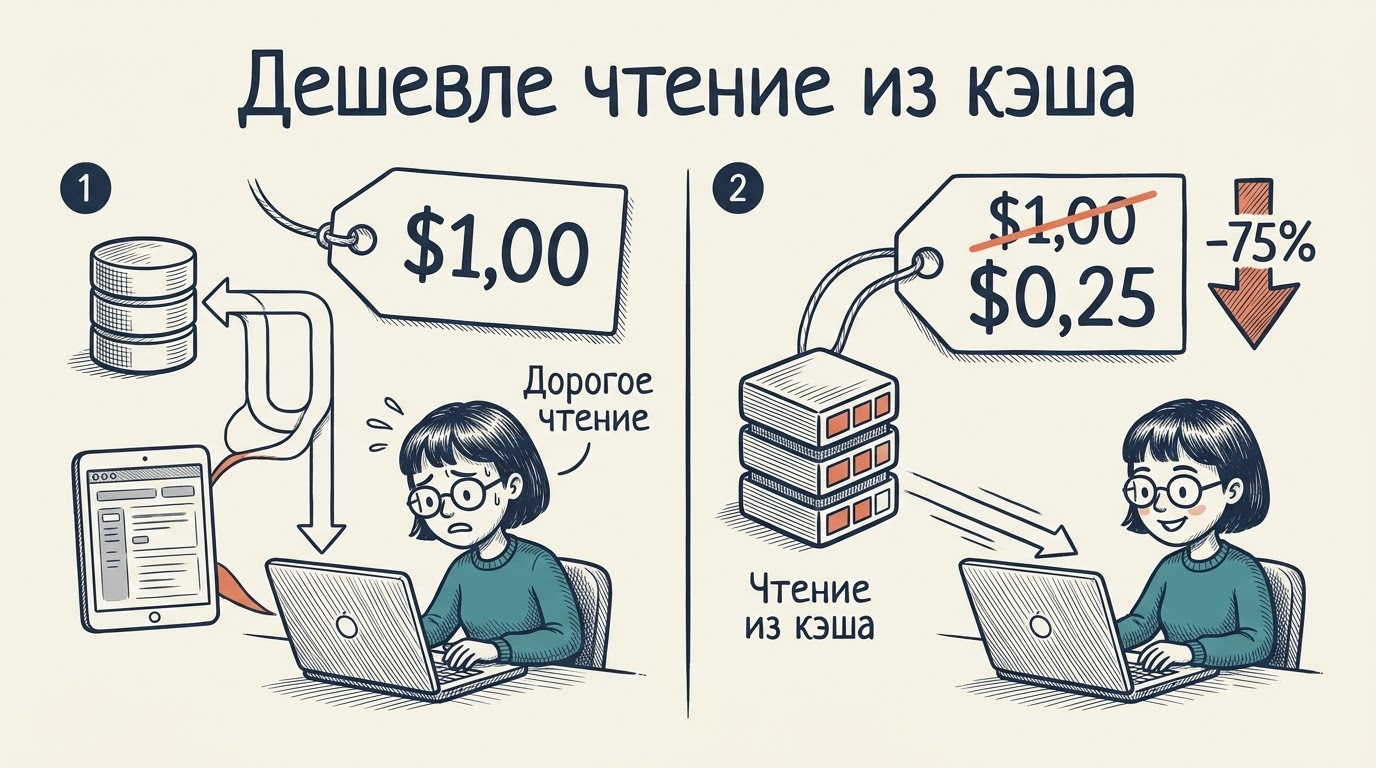
Базовые цены входа и выхода не изменились, но чтение из кэша подешевело на 75%, а в высокоагентных сценариях экономия достигает 45% по сравнению с Fable 5. API-идентификатор модели — claude-fable-5-1, контекстное окно — до 1 млн токенов, вывод — до 128 тыс. токенов за ответ.
Что такое Claude Fable 5.1
Claude Fable 5.1 — флагманская языковая модель компании Anthropic, созданная для задач агентного программирования, долгой исследовательской работы и многоэтапного решения проблем. Она пришла на смену Fable 5 и занимает верхнюю строчку в линейке Claude на момент релиза в сентябре 2026 года.
Флагман для кодинга и агентных задач
Новая модель Anthropic ориентирована прежде всего на программирование и автономную работу в терминале. Она поддерживает контекстное окно до 1 млн токенов — достаточно, чтобы удерживать в памяти большую кодовую базу или объёмный научный корпус. Максимальный вывод за один запрос составляет 128 тыс. токенов. API-идентификатор для обращения к модели — claude-fable-5-1.
В экосистеме Claude она закрывает нишу «умного» флагмана: Mythos 5.1 параллельно вышел как версия с расширенным доверенным доступом для специализированных организаций, тогда как Fable 5.1 доступна широкой аудитории разработчиков через стандартный API.
Что изменилось в поведении модели
Anthropic внесла несколько заметных изменений в API. Появилась возможность менять уровень усилий (effort) прямо по ходу диалога — раньше это значение задавалось только в начале сессии. Теперь доступны пошаговые системные сообщения (step-level system prompts) и сохранение прогресса между вызовами инструментов.
Одновременно Anthropic упразднила типы tool_choice any и tool — разработчикам, которые их использовали, потребуется обновить интеграцию. Категории безопасности и система предохранителей остались на уровне Fable 5.
Отличия от Fable 5: бенчмарки
Главное, что отличает Fable 5.1 от предшественника, — рост на специализированных бенчмарках. Особенно заметен скачок в программировании и научных рассуждениях.
Программирование и работа с компьютером
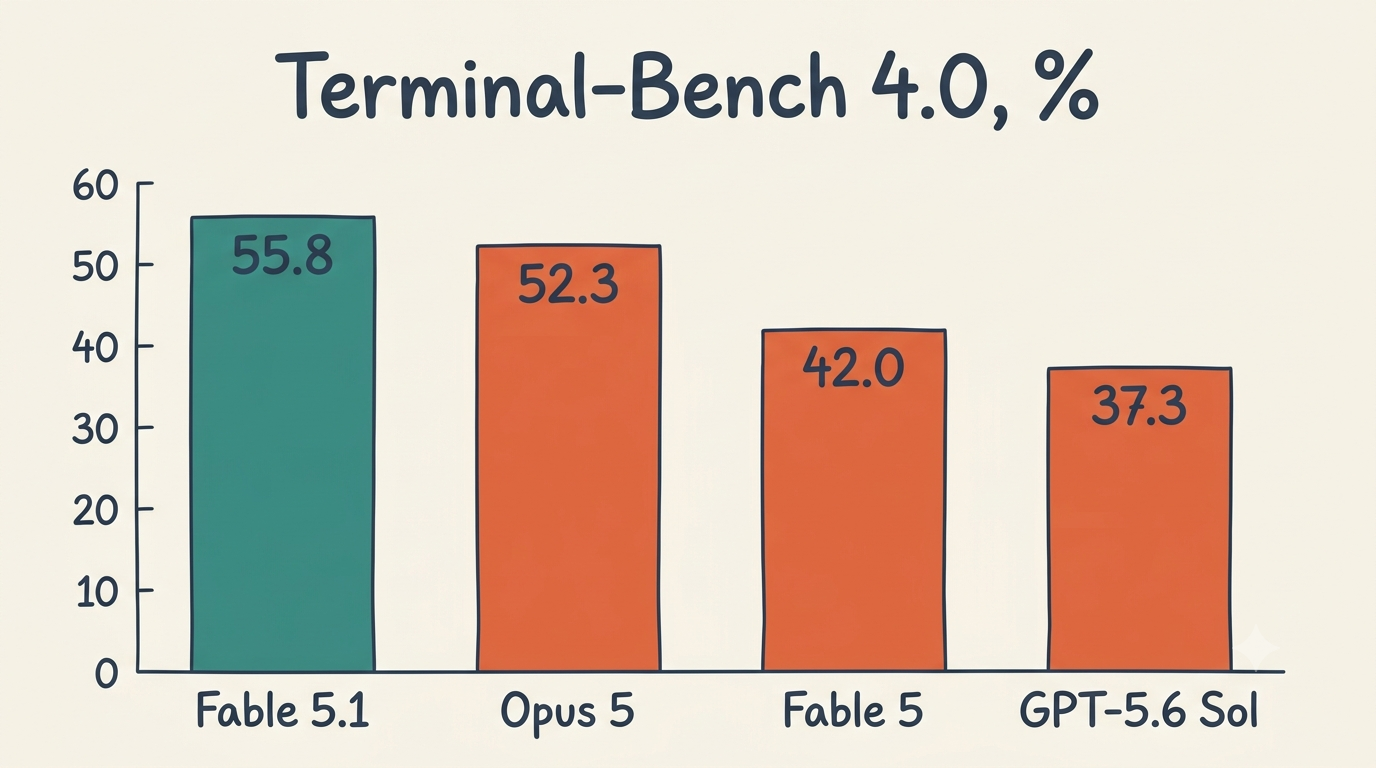
На Terminal-Bench 4.0 — стандартном тесте для автономной работы в терминале — Fable 5.1 набирает 55,8% против 42% у предшественника. Для сравнения: Opus 5 остановился на 52,3%, а GPT-5.6 Sol — на 37,3%. На CursorBench 3.2.0 модель показывает 73,4% при максимальном уровне усилий.
Управление компьютером проверялось на OSWorld 2.0: модель получила 77,9% в частичном режиме и 41,7% в строгом. Это один из наиболее требовательных тестов на автономное управление GUI, и результат Fable 5.1 здесь значительно опережает Fable 5. Подробнее о том, как устроен бенчмарк Terminal-Bench и что он измеряет, — в отдельном разборе.
Наука и рассуждения
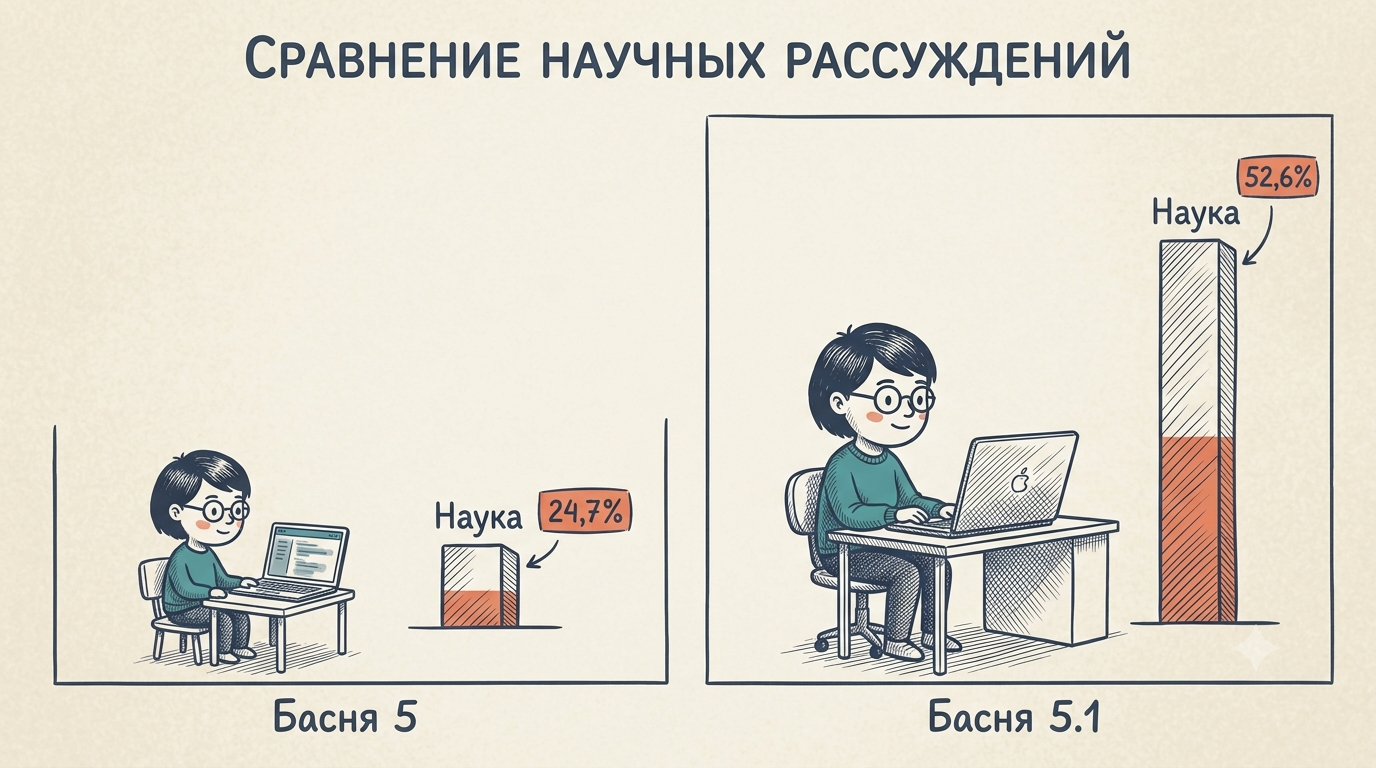
На бенчмарке Terminal-Bench-Science 0.1 модель показывает 52,6% против 24,7% у Fable 5 — рост почти вдвое. GDPval-AA v2, измеряющий качество рассуждений, дал Fable 5.1 результат 1853 балла при 1723 у Fable 5 и 1824 у Opus 5. Humanity’s Last Exam с включёнными инструментами — 65%.
Ниже — сводная таблица ключевых бенчмарков:
| Бенчмарк | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 55,8% | 42,0% | 52,3% | 37,3% |
| Terminal-Bench-Science 0.1 | 52,6% | 24,7% | — | — |
| GDPval-AA v2 | 1853 | 1723 | 1824 | — |
| OSWorld 2.0 (partial) | 77,9% | — | — | — |
| OSWorld 2.0 (strict) | 41,7% | — | — | — |
| CursorBench 3.2.0 | 73,4% | — | — | — |
| Humanity’s Last Exam (с инстр.) | 65% | — | — | — |
Цена и экономия
Базовые цены и кэш
Стоимость токенов в базовых тарифах не изменилась: $10 за 1 млн входных токенов и $50 за 1 млн выходных. Ключевое удешевление касается чтения из кэша: оно подешевело на 75%, до $0,25 за 1 млн токенов. Именно это делает Fable 5.1 выгоднее для агентных сценариев, где модель многократно обращается к одному и тому же контексту. Как работает кэширование промптов и когда оно даёт максимальную выгоду — в отдельном материале.
По данным Anthropic, типовые задачи обходятся примерно на 25% дешевле Fable 5, а высокоагентные сценарии — до 45%. Ранние тестеры, среди которых упоминаются Canva и SpaceXAI, подтвердили реальную экономию на рабочих нагрузках.
Полная таблица тарифов:
| Параметр | Claude Fable 5.1 |
|---|---|
| Входные токены | $10 / 1M |
| Выходные токены | $50 / 1M |
| Чтение из кэша | $0,25 / 1M (−75%) |
| Контекстное окно | до 1 млн токенов |
| Макс. вывод за ответ | 128 тыс. токенов |
Нюанс: экономия не гарантирована
Реальная экономия зависит от настройки уровня усилий. Независимые тесты аналитической компании Artificial Analysis показали: в режиме максимального усилия модель может генерировать заметно больше выходных токенов, и тогда отдельная задача выходит дороже, чем та же задача на Fable 5. Это особенно актуально для коротких запросов, где задействование расширенного рассуждения экономически нецелесообразно.
Правило простое: для рутинных задач используйте уровень Medium или Low, оставляя High и максимальный эффорт для сложного кода и научных вычислений.
Fable 5.1 снижает стоимость агентной работы за счёт радикального удешевления кэша — это позволяет компаниям масштабировать долгие задачи без линейного роста расходов.— Anthropic, официальный анонс Claude Fable 5.1 и Mythos 5.1
Fable 5.1 против Mythos 5.1
Одна модель — два режима
Claude Fable 5.1 и Claude Mythos 5.1 — это технически одна и та же модель, настроенная на разные уровни защитных ограничений. Fable 5.1 доступна всем разработчикам через стандартный API с полным набором производственных предохранителей. Mythos 5.1 выдаётся только участникам программы доверенного доступа — проверенным организациям в области кибербезопасности и наук о жизни.
Ключевая разница не в интеллекте, а в том, какие типы запросов модель обрабатывает без блокировок. Для большинства разработчиков релевантна именно Fable 5.1. Что представляет собой Claude Mythos 5.1 и кому доступен доверенный режим — разбираем подробно.
Меньше ложных срабатываний
Anthropic сообщает, что ложные срабатывания в задачах кибербезопасности снизились на 60% по сравнению с исходным Fable 5. На безобидные вопросы по биологии и медицине — на 85%. Это важно для продуктов, где модель регулярно видит технические запросы и раньше необоснованно отказывала.
В научных прогонах Mythos 5.1 улучшал аффинность связывания белков примерно в 10 раз на 3 из 12 протестированных мишеней. Также модель помогла построить детализированную карту поверхности Венеры по снимкам зонда NASA Magellan — задача, требующая одновременно работы с большим объёмом данных и понимания предметной области.
Где доступна и как начать
Платформы и доступ
Claude Fable 5.1 доступна сегодня через Claude API, а также через облачные платформы: Amazon Bedrock, Google Cloud Vertex AI и Microsoft Azure AI Foundry. Идентификатор для запроса — claude-fable-5-1.
По умолчанию уровень усилий (effort) установлен в High в Claude Code и в Medium в Claude.ai. Уровень можно менять по ходу диалога, что позволяет гибко управлять балансом скорость/стоимость/качество. Как выбрать уровни усилий (effort) под конкретную задачу и не переплатить — в отдельном руководстве.
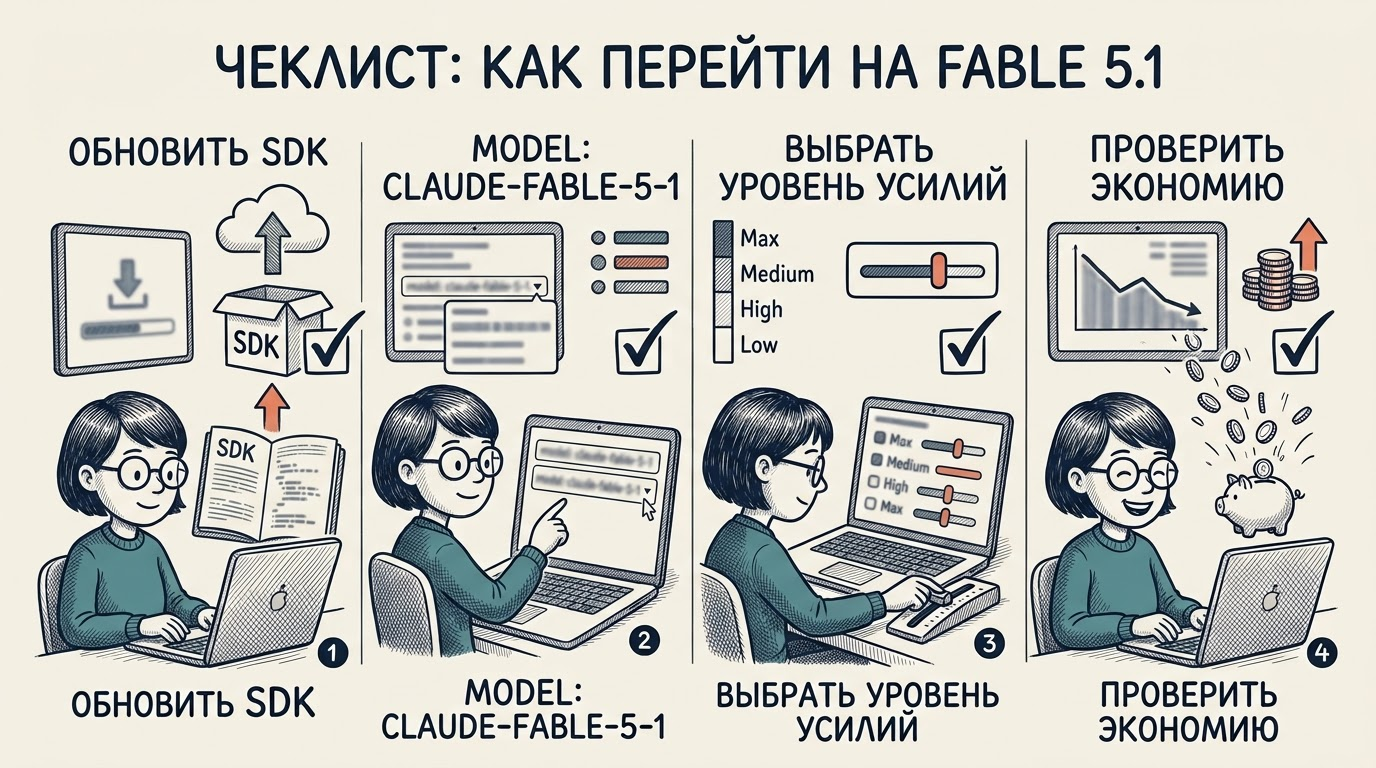
Документация к API описывает три уровня усилий:
- Low — быстрые ответы, минимальное рассуждение. Подходит для простых справочных запросов.
- Medium — баланс скорости и качества. Используется по умолчанию в Claude.ai.
- High — расширенное рассуждение, максимальная точность. Дефолт в Claude Code.
Помимо трёх стандартных тиров, доступен также максимальный (max) режим усилий для особо требовательных задач — например, комплексной отладки или автономного решения задач на CursorBench.
Как подключить Fable 5.1 в своём проекте
- Убедитесь, что ваш API-ключ действителен и у вас есть доступ к Claude API (или к нужному облачному провайдеру).
- Обновите версию библиотеки Anthropic SDK до последней — она добавила поддержку Fable 5.1.
- В запросе укажите
model: "claude-fable-5-1". - Задайте уровень усилий под вашу задачу:
effort: "low","medium"или"high". - Если вы использовали
tool_choice: "any"илиtool_choice: "tool"— замените на поддерживаемые типы (auto,required). - Проверьте работу кэша: повторяющиеся системные промпты и контексты теперь обходятся в $0,25/1M токенов.
- Запустите тестовый прогон и сравните стоимость с Fable 5 — большинство агентных сценариев покажут снижение.