
Официальная документация AI-модели Jev: как запустить, методы и вызовы
Официальная документация ai модели Jev описывает инструмент, который не генерирует прозу, а быстро принимает структурированные решения. Изучить возможности jev ai можно через специальный HTTP-эндпоинт с Bearer-авторизацией. Актуальная версия модели имеет идентификатор jev-1.13.0 с псевдонимами jev-latest и jev-preview, что подтверждает документация.
Jev создан компанией TypeSafe AI и относится к классу System One моделей. Нейросеть не тратит вычислительные мощности на формирование текста по токенам, а мгновенно оценивает переданное состояние. Чтобы начать интеграцию, достаточно получить API-ключ в панели управления, экспортировать его в переменную TYPESAFE_API_KEY и установить официальный пакет разработки для Python или JavaScript.
В этом гайде собраны все официальные источники, пошаговый первый запрос, разбор методов Choice, Score и Noul, идентификаторы версий продукта, актуальные цены и лимиты. Вы узнаете о ключевых ограничениях, о которых стоит знать до начала программирования архитектуры приложения.
Что такое AI-модель Jev
Jev — это System One модель от TypeSafe AI, которая вместо генерации текста возвращает типизированные вероятностные решения, пригодные для использования софтом напрямую. Модуль Jev является System One моделью, возвращающей типизированные решения вместо текста, на которые алгоритм сможет опираться при ветвлении бизнес-логики. Продукт Jev разработан компанией TypeSafe AI специально для автоматизированных программных агентов.
System One модель против чат-LLM
Обычные языковые модели работают по принципу авторегрессии, генерируя ответ последовательно слово за словом. Такой подход отлично подходит для написания статей или диалога с человеком, но избыточен для программного кода. Модель Jev использует другой математический аппарат, где за один проход оценивается переданное состояние и формируется окончательный вердикт.
Благодаря отказу от генерации длинных цепочек слов, ответ приходит практически моментально. В зависимости от объема контекста, нейросеть делает быстрые структурированные решения за 70–500 мс. Подобный класс инструментов получил название System One по аналогии с концепцией быстрого и интуитивного мышления, описанной нейробиологами.
Зачем нужен Jev
Программные продукты постоянно сталкиваются с необходимостью классифицировать входящие данные. Если раньше для этого приходилось писать сложные парсеры регулярных выражений или дообучать узкоспециализированные классификаторы, то теперь достаточно отправить текстовое описание в API, получив калиброванные вероятностные решения.
Разработчики выделяют несколько типовых сценариев применения:
- Интеллектуальная маршрутизация запросов между разными агентами.
- Гейтинг и блокировка опасных вызовов системных инструментов.
- Быстрая классификация обращений пользователей.
- Оценка тональности диалога в реальном времени.
- Скоринг лидов и определение приоритета задач в очереди.
Кто разработал Jev: TypeSafe AI
Jev разработан компанией TypeSafe AI, которую основал бывший исследователь OpenAI Диого Алмейда, и запущен 15 сентября 2026 года. Инструмент Jev разработан компанией TypeSafe AI с прицелом на строгую интеграцию в корпоративные программные продукты, где недопустимы случайные галлюцинации искусственного интеллекта. Больше подробностей о создателе модели TypeSafe AI можно прочитать в отдельном материале.
Основатель и происхождение названия
Стартап TypeSafe AI основал Diogo Almeida, который ранее принимал активное участие в создании базовой версии ChatGPT и был соавтором методологии обучения с подкреплением на основе отзывов людей. Опираясь на опыт работы с нестабильным машинным выводом, он собрал команду инженеров для создания детерминированного нейросетевого ядра. Коммерческий запуск платформы состоялся 15 сентября 2026 года.
Название продукта является прямой отсылкой к известному английскому экономисту Уильяму Стэнли Джевонсу. В науке существует парадокс Джевонса, который гласит, что повышение эффективности использования ресурса ведет не к снижению, а к увеличению спроса на него. Создатели закладывают мысль, что сверхдешевый искусственный интеллект приведет к экспоненциальному росту количества фоновых вызовов API.
Как обучалась модель
Архитектура фундаментально отличается от подходов к тренировке разговорных чат-ботов. Разработчики применили собственный пайплайн обучение RLCD, что расшифровывается как Reinforcement Learning for Calibrated Decisions.
Обучение RLCD позволило добиться уникального свойства платформы: возвращаемые вероятности являются математически калиброванными. Основные принципы тренировки:
- Вознаграждение за точный выбор категории, а не за генерацию токенов.
- Использование датасетов с жестко размеченными правильными ответами.
- Математическая калибровка выдаваемых вероятностей для использования в коде в качестве порогов.
Официальные источники и документация Jev
Официальная документация Jev размещена на docs.typesafe.ai, а панель управления и выпуск ключей — на console.typesafe.ai. Официальная документация Jev размещена на docs.typesafe.ai и служит главным источником правды для системных архитекторов и программистов. Ресурс постоянно обновляется и содержит исчерпывающую информацию по всем доступным функциям программного интерфейса.
Структура портала разделена на несколько логических блоков. На странице docs.typesafe.ai/models находится подробный список всех доступных версий движка и их уникальных идентификаторов. Раздел /api содержит полный HTTP-спек, детальное описание кодов ошибок и актуальные лимиты скорости.
Для автоматизированных систем предусмотрен специальный машиночитаемый обзор по адресу docs.typesafe.ai/llms.txt, который удобно скармливать другим нейросетям при написании кода. Консоль console.typesafe.ai предназначена исключительно для административных задач, управления биллингом и контроля доступа.
Разработчикам не обязательно каждый раз вручную проверять доступность новых релизов на сайте. Актуальный список моделей можно получить программно в любой момент, выполнив прямой API-запрос к основному серверу платформы.
Важно отметить, что компания придерживается строгой политики версионирования API. Основные правила поддержки:
- Стабильные релизы не изменяются задним числом.
- Экспериментальные функции помечаются соответствующими флагами.
- Устаревшие эндпоинты поддерживаются минимум полгода после выхода замены.
Как получить API-ключ и начать работу
Чтобы начать, нужно завести аккаунт в консоли, выпустить API-ключ и экспортировать его в переменную окружения TYPESAFE_API_KEY. API-ключ Jev экспортируется как переменная TYPESAFE_API_KEY, что позволяет локальным скриптам автоматически подхватывать авторизационные данные. Подробно о подключении и возможностях интерфейса рассказывается на страницах нашего портала.
Шаги получения ключа
Процесс регистрации максимально упрощен и не требует прохождения долгих проверок. Инструмент доступен всем желающим без листа ожидания. Сначала необходимо зарегистрироваться в панели управления console.typesafe.ai, используя адрес электронной почты или профиль на GitHub.
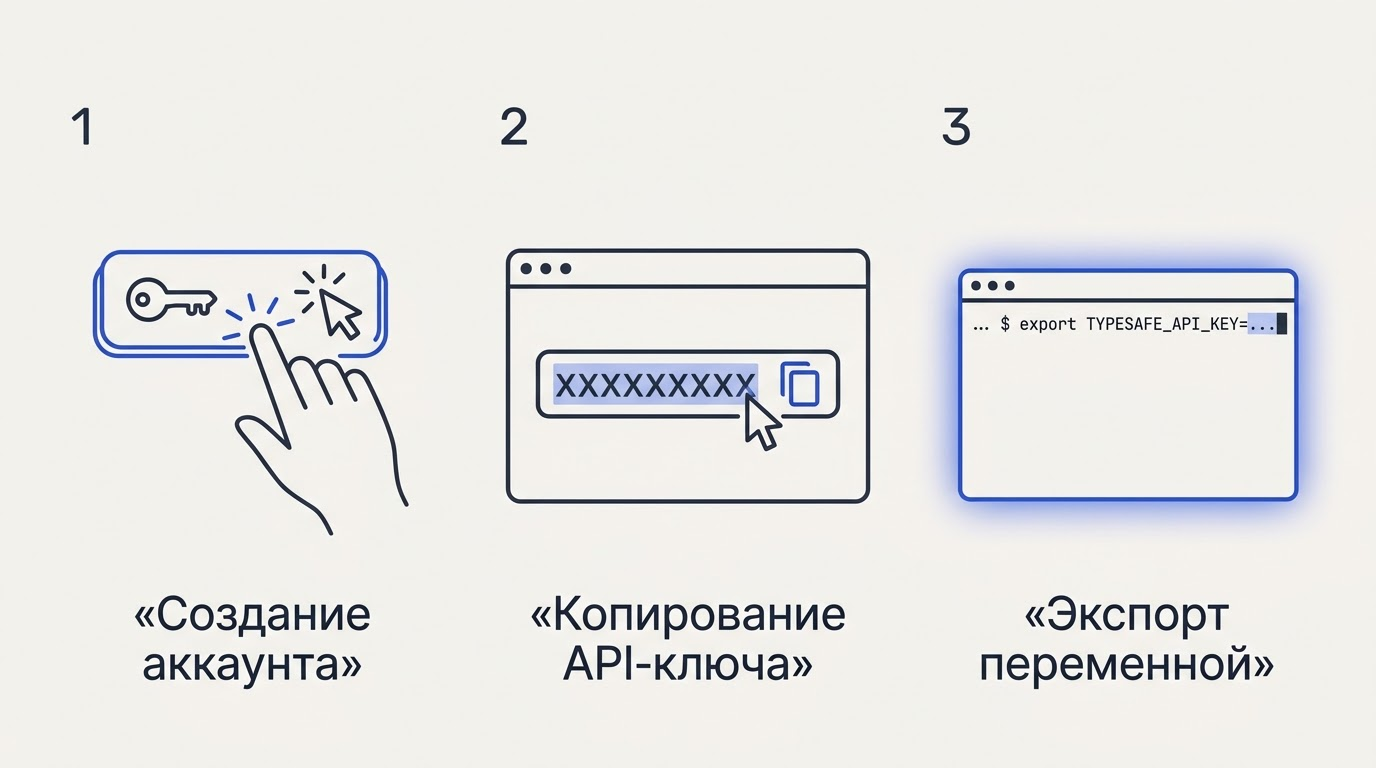
В разделе безопасности нужно создать новый секретный API-ключ TYPESAFE_API_KEY, который будет начинаться с префикса sk-. Сразу после генерации следует скопировать строку и экспортировать в систему через терминал командой export TYPESAFE_API_KEY=»sk-…». Этот секрет нельзя добавлять в системы контроля версий и публичные репозитории.
Jev is TypeSafe’s flagship model and the first System One model. Every model on this page is served by the same endpoint, `POST /v1/systemone`.
TypeSafe
Альтернативный доступ через шлюзы
Далеко не всегда удобно регистрироваться напрямую у провайдера, особенно если проект уже использует десяток других нейросетей. Платформа официально поддерживает работу через популярные проксирующие агрегаторы.
Интеграцию можно настроить через шлюзы OpenRouter, Vercel AI Gateway, Netlify AI Gateway или платформу AIMLAPI. При таком подходе используется единый баланс агрегатора, а для проверки прав применяется Bearer-авторизация с токеном выбранного провайдера, при этом структура самого запроса остается неизменной.
Как вызывать Jev: эндпоинт, запрос и ответ
Вызов Jev выполняется одним POST-запросом на /v1/systemone с заголовком Authorization: Bearer, а тело содержит поля model, state и questions. Вызов Jev выполняется через POST /v1/systemone с Bearer-авторизацией, что делает его совместимым со стандартными сетевыми библиотеками. Запрос к Jev содержит поля model, state и questions, жестко регламентирующие структуру передаваемой информации.
Структура тела запроса
Основной HTTP-эндпоинт /v1/systemone принимает данные строго в формате JSON. Заголовки должны включать Authorization: Bearer с вашим секретным ключом и Content-Type: application/json. Отсутствие любого из этих заголовков приведет к моментальной ошибке доступа.
Тело формируется из трех обязательных компонентов. Поле model указывает идентификатор нужной версии нейросети. Поле state выступает как контекст запроса — сюда передаются входные данные, текст письма, кусок кода или логи приложения. Поле questions представляет собой карту вопросов на базовых примитивах, где формулируются конкретные задачи для движка.
Формат ответа
Сервер возвращает типизированные решения по каждому заданному вопросу. В ответе содержится не сгенерированная проза, а вероятностное распределение и уровень уверенности алгоритма в сделанном выборе. Архитектура построена так, что ошибки структурированного вывода практически исключены по изначальному замыслу создателей.
Все пункты из словаря вопросов обрабатываются и оцениваются параллельно. Это означает, что отправка десятка сложных условий для проверки стоит токенов согласно объему текста, но практически не добавляет времени ожидания. Приложение получит готовый массив данных с такой же скоростью, как если бы вычисляло один единственный параметр.
Методы Jev: Choice, Score и Noul
Jev отвечает через три примитива: Choice выбирает один вариант из набора, Score ставит оценку по шкале, Noul возвращает вероятность да/нет. Jev отвечает через примитивы Choice, Score и Noul, покрывая все типовые потребности программной маршрутизации. Choice выбирает один вариант из набора до 255 опций, Score оценивает состояние по упорядоченной шкале из 2–10 уровней, а Noul возвращает вероятность да/нет от 0 до 1.
Choice — выбор из набора
Метод Choice выбирает один вариант из набора до 255 опций и возвращает итоговый выбор вместе с распределением вероятностей. Разработчик передает массив возможных значений, а нейросеть анализирует контекст и присваивает каждому пункту вес. Наивысший вес определяет победителя, а дистанция до остальных вариантов показывает степень уверенности.
Классический пример использования этого инструмента — маршрутизация входящих обращений в службу поддержки. Получив текст клиентского тикета, алгоритм безошибочно определит, куда его направить: в отдел биллинга, техническим специалистам или менеджерам по продажам.
Score — оценка по шкале
Примитив Score оценивает состояние по упорядоченной шкале из 2–10 уровней. В отличие от простого выбора, здесь важна последовательность значений. Система возвращает позицию, которая может попадать в промежуток между заданными уровнями с высокой дробной точностью, формируя плавный градиент оценки.
Отличным примером служит анализ эмоциональной окраски диалога. Если задать шкалу от спокойного тона до крайней степени недовольства, алгоритм сможет отслеживать уровень фрустрации клиента в реальном времени, передавая точное числовое значение дашбордам аналитики.
Noul — да/нет как вероятность
Инструмент Noul возвращает вероятность да/нет от 0 до 1, где само выданное число и является показателем уверенности сети в положительном ответе. Это самый быстрый и легковесный способ проверить бинарное условие на основе объемного текстового контекста.
На практике это применяется для мгновенного обнаружения конкретных триггеров. Например, можно спросить, просит ли клиент явно оформить возврат средств. Полученная уверенность позволяет строить надежную пороговую маршрутизацию по уровню риска, блокируя сомнительные транзакции до вмешательства оператора.
| Примитив | Назначение метода | Пример возвращаемого значения |
|---|---|---|
| Choice | Выбор из списка | «billing» (уверенность 0.92) |
| Score | Градиентная оценка | 3.45 (между уровнями 3 и 4) |
| Noul | Бинарная вероятность | 0.87 (вероятность «да») |
SDK и первый запрос на Python и JavaScript
Jev интегрируется через официальные SDK typesafe-sdk для Python и @typesafe-ai/sdk для JavaScript, устанавливаемые одной командой пакетного менеджера. Jev интегрируется через SDK typesafe-sdk (Python) и @typesafe-ai/sdk (JavaScript), предоставляя разработчикам типизированные обертки над сырым сетевым интерфейсом. Актуальная версия модели имеет идентификатор jev-1.13.0 с псевдонимом jev-latest, на который библиотеки ссылаются по умолчанию.
Установка SDK
Добавление пакета в проект занимает меньше минуты. Для сред на базе Python SDK typesafe-sdk устанавливается командой pip install typesafe-sdk в виртуальном окружении. Разработчикам потребуется ввести npm install @typesafe-ai/sdk в корневой директории приложения, чтобы загрузить JavaScript SDK @typesafe-ai/sdk.
После загрузки файлов необходимо убедиться, что авторизационный ключ присутствует в системной среде. Пакеты автоматически ищут переменную окружения при инициализации клиента. Далее остается собрать параметры state и questions на основе требуемых примитивов и отправить их на сервер одним вызовом функции.
Какой идентификатор модели указывать
При формировании полезной нагрузки в поле model необходимо передать правильный строковый ключ. Чаще всего инженеры указывают Псевдоним jev-latest, который гарантированно ссылается на стабильный мажорный релиз. Если требуется доступ к экспериментальным функциям, применяется тег jev-preview.
Однако для обеспечения максимальной отказоустойчивости Идентификатор модели jev-1.13.0 является предпочтительным. Главная рекомендация системных архитекторов — всегда фиксировать точную версию ядра в конфигурационных файлах продакшена. Это защитит бизнес-логику от неожиданных изменений поведения при выкате мажорных обновлений на стороне провайдера.
Стоимость, лимиты и латентность
Jev стоит $0,042 за миллион входных токенов при бесплатном выводе, отвечает за доли секунды и поддерживает внушительный объем контекста на запрос. Jev тарифицируется по $0,042 за миллион входных токенов при бесплатном выводе информации обратно клиенту. Калиброванные вероятностные решения позволяют существенно экономить бюджет проекта, а подробную информацию о тарифах и покупке доступа можно найти на соответствующих страницах.
Цены и контекст
Вычислительная мощность обходится в $0,042 за миллион переданных токенов, при этом выходные токены абсолютно бесплатны. Такая экономика стала возможной потому, что нейросеть возвращает короткие структурированные ответы. Поддерживается контекстное окно размером 64k токенов на один запрос.
Этот лимит распределяется таким образом, что 32k выделяется для совокупной длины state и самого длинного вопроса. Также существуют ограничения интенсивности: разрешено отправлять 250 000 токенов в секунду и выполнять 1200 запросов в минуту с возможностью динамической корректировки при масштабировании.
Задержка
Латентность системы, измеряемая от момента отправки пакета до получения готового JSON-ответа, варьируется от 70 до 500 мс end-to-end. Подобная скорость недостижима для классических чат-ботов, которым требуются секунды только на генерацию первого слова.
Параллельная оценка вопросов на стороне сервера означает, что добавление новых условий в карту никак не замедляет процесс. Запрос с одним простым бинарным условием и запрос с десятком сложных многоуровневых классификаторов будут обработаны процессорами одновременно, вернув результат с минимальной временной дельтой.
| Параметр тарификации | Значение лимита | Условия оплаты |
|---|---|---|
| Входные токены | 64k на запрос (32k на state) | $0,042 за 1 млн |
| Выходные данные | Не ограничено | Бесплатно |
| Скорость API | 1200 запросов/мин | 70–500 мс задержки |
Ограничения модели и типичные ошибки
Jev не генерирует текст, ненадёжен в счёте, датах и арифметике и читает инструкции буквально, поэтому эти задачи выносят в код. Jev не умеет генерировать текст, считать и работать с датами, из-за чего архитекторам приходится применять специальные паттерны проектирования. Специфическое обучение RLCD сфокусировало нейросеть на классификации, полностью отрезав способности к творчеству.
Модель категорически не подходит для написания текстов. Инструмент Jev не генерирует программный код, не пишет письма и не делает краткие резюме длинных статей. Любые попытки заставить этот алгоритм разговаривать как человек приведут к сбою валидации схемы ответа или возврату бессмысленных вероятностных весов.
Вычислительные и арифметические операции вызывают сбои. Нейросеть крайне ненадёжна со счётом, сравнением дат и сложной арифметикой. Инженеры настоятельно рекомендуют выносить абсолютно все вычисления в классический программный код, передавая в API только готовые факты для оценки.
Буквальное чтение инструкций требует явных формулировок. Алгоритм не пытается додумать скрытый смысл или проигнорировать отрицания. Границы охвата и запрещающие правила нужно формулировать предельно ясно. В документации указано, чего следует избегать:
- Использования расплывчатых метафор в описании категорий.
- Добавления длинного нерелевантного контекста-паддинга, из-за которого точность резко падает.
- Построения сложных цепочек отрицаний в одном условии.
Паттерны интеграции помогают строить системы без ошибок. Чтобы обойти фундаментальные ограничения, разработчики создали проверенные архитектурные паттерны. Следуйте базовому процессу сборки надежного агента:
- Сначала отфильтруйте данные методами базы данных (паттерн Retrieve-Then-Judge).
- Вызовите System One модель для быстрой оценки отфильтрованного текста.
- Настройте пороги по уверенности (Confidence-Gated Routing) для сомнительных случаев.
- Направьте простые задачи в программный код.
- Отдайте самые сложные запросы во фронтир-LLM, используя Jev только как центральный маршрутизатор (паттерн The Cascade).