
Что такое ИИ-модель Jev от TypeSafe AI: System One, устройство, цена и применение
Модель ai jev — первая публичная разработка класса System One от лаборатории TypeSafe AI, которая вместо генерации текста возвращает коду типизированные решения с вероятностями. Нейросеть не выводит слова токен за токеном, а действует как инструмент быстрой маршрутизации и оценки для программных алгоритмов, что напоминает общие сведения о System 1 из когнитивной психологии.
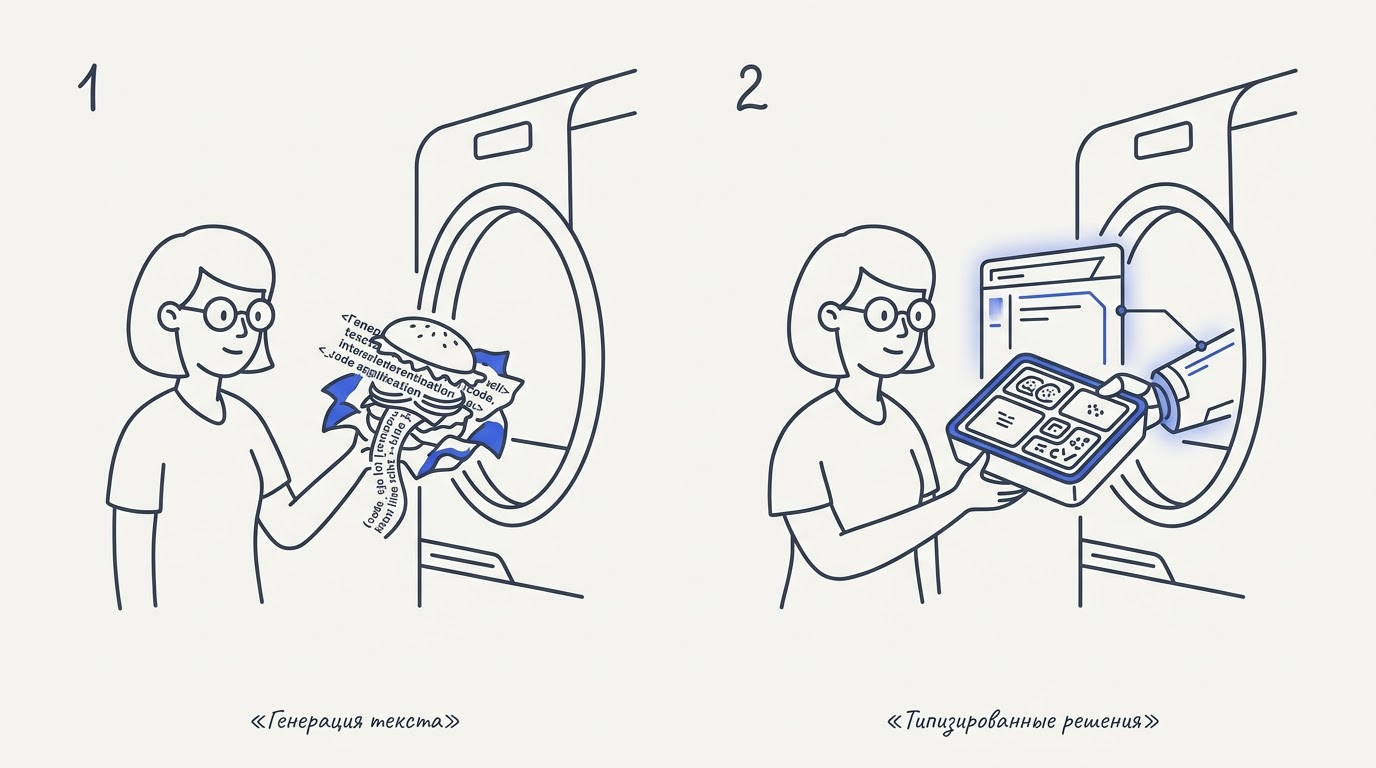
Презентация модели состоялась осенью под руководством создателя Диого Алмейды, соавтора ранних версий ChatGPT и метода RLHF. Прямой запрос к API стоит считанные центы за огромное количество токенов, выход полностью бесплатен, а ответ возвращается за доли секунды. Разбираем, чем архитектура Jev отличается от традиционных LLM, как использовать типы вывода Choice, Score и Noul, где нейросеть применяют разработчики агентов и что показывают независимые бенчмарки.
Что такое Jev и модели System One
Jev — первая публичная модель класса System One от TypeSafe AI, которая вместо генерации текста возвращает коду типизированные решения с вероятностями. Являясь альтернативой классической большой языковой модели, этот ИИ интегрируется прямо в логику приложений как детерминированный слой. TypeSafe AI вышла из стелс-режима и анонсировала фундаментную модель осенью. Инструментарий лаборатории и исследования команды TypeSafe изначально были направлены на создание надёжного связующего звена между нейросетями и традиционным кодом.
Организация TypeSafe AI была основана в 2024 году в Сан-Франциско, а создателем Jev является Диего Алмейда, бывший исследователь OpenAI и соавтор ChatGPT и RLHF. Продукт создавался для интеграции в программную среду без необходимости парсить сложный текстовый вывод. При этом существуют и другие значения имени Jev, связанные с экономическими концепциями.
System One: быстрые интуитивные решения для кода
Название класса System One model является прямой отсылкой к концепции «Системы 1», которую описал Даниэль Канеман: это аппарат, отвечающий за быстрые интуитивные суждения. Если традиционные LLM рассуждают долго (Система 2), то Jev выносит моментальные суждения не для человека, а для программы. На входе probabilistic decision model получает текст на естественном языке, а на выходе формирует вероятность, вариант из списка или оценку по шкале.
Разработчики называют foundation model аббревиатурой smart if-statement (умный if-statement). Полученные от decision layer типизированные значения сразу ложатся в математическое условие или пороговый фильтр в коде, не требуя дополнительной валидации синтаксиса или применения регулярных выражений.
Откуда взялась Jev и её название
Имя Джев дано в честь британского экономиста Уильяма Стэнли Джевонса и сформулированного им парадокса: чем эффективнее используется ресурс, тем больше растет его общее потребление. Разработчики намекают, что удешевление и ускорение inference-слоя приведет к взрывному росту числа обращений к ИИ-агентам в фоновых процессах.
Текущая рабочая версия постоянно обновляется, и для удобства интеграции на неё указывает постоянный алиас jev-latest. Выйдя из скрытого режима в сентябре 2026 года, команда показала, что ии-модель Jev способна радикально снизить задержки в высоконагруженных программных комплексах.
Кто создал Jev: TypeSafe AI и Диого Алмейда
Jev разработала TypeSafe AI — основанная в 2024 году в Сан-Франциско лаборатория Диого Алмейды, бывшего исследователя OpenAI и соавтора ChatGPT и RLHF. Запуск проекта состоялся после нескольких лет работы в стелс-режиме: создатели вышли в публичное поле осенью, представив рынку альтернативный подход к машинному обучению и опубликовав технические параметры, а также официальную документацию Jev для разработчиков.
Компания TypeSafe AI привлекла десятки млн долларов посевных инвестиций в раунде под руководством фонда DCVC. Эти средства пошли на масштабирование вычислительных кластеров и формирование команды инженеров, специализирующихся на неавторегрессионных архитектурах.
CEO Диого Алмейда известен индустрии как соавтор ChatGPT, один из ключевых разработчиков метода RLHF и создатель InstructGPT в OpenAI. До перехода в OpenAI он занимался исследованиями в Google Brain. Собранная им в Тайпсейф команда также состоит из опытных инженеров — это выходцы из OpenAI, Google Brain, лаборатории Meta/FAIR, а также Stripe и Docker, что объясняет сильный фокус продукта на инфраструктурную надежность и бесшовный developer experience (typesafe-ai/jev).
Чем Jev отличается от ChatGPT, Claude и других LLM
Jev отличается от LLM тем, что не генерирует текст токен за токеном, а за один параллельный проход возвращает типизированные значения с вероятностями, оплачивая только входные токены. Эта ИИ-модель выступает как non-autoregressive System-1 model, проектировавшаяся специально как AI-powered decision function for software.
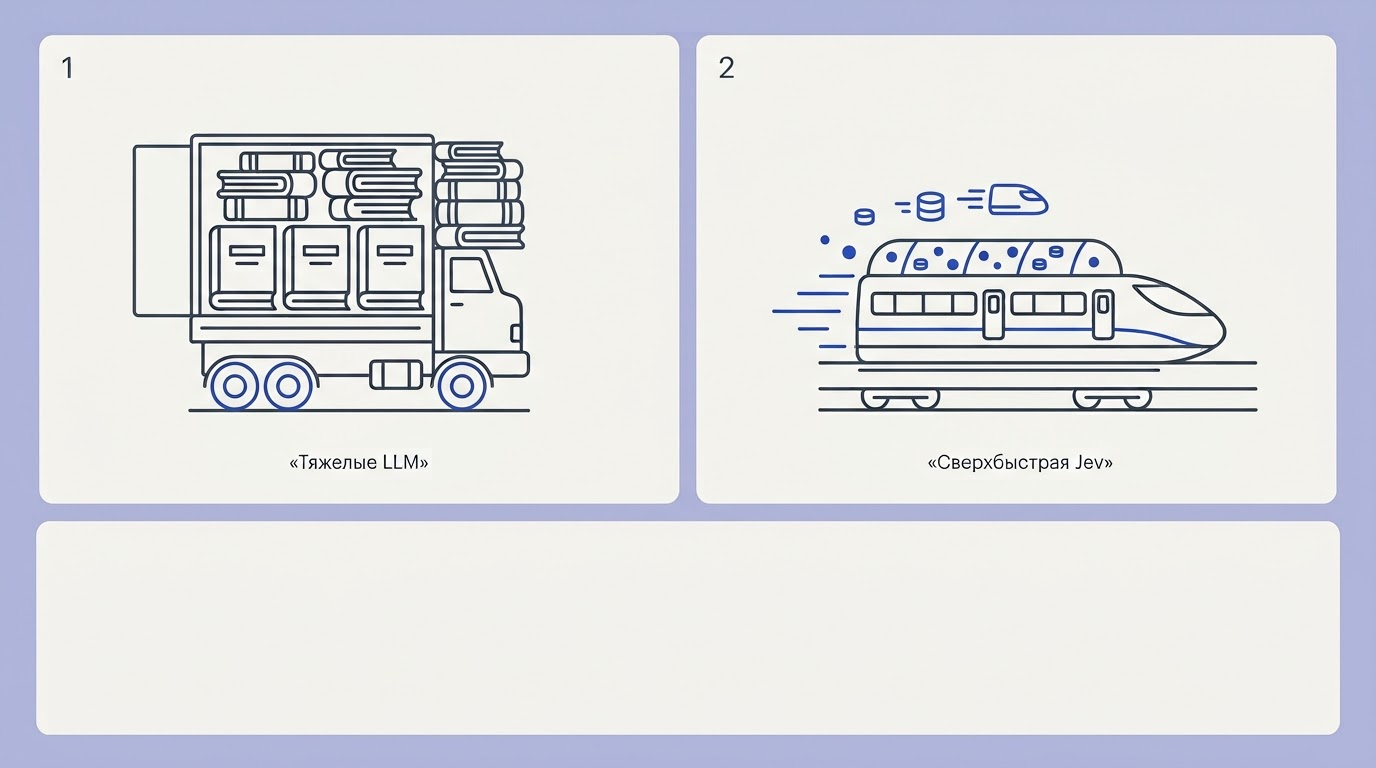
Согласно заявлениям TypeSafe, Jev работает в сотни раз быстрее и обходится во много раз дешевле, чем традиционные LLM на задачах классификации и рабочих процессах. Исключение этапа последовательной генерации позволило кардинально сократить задержки на уровне железа при сопоставимом качестве маршрутизации.
Вход, выход и способ вычисления
Классические генеративные сети работают последовательно. LLM получает промпт в свободной форме и генерирует текст токен за токеном, что требует времени на каждое слово. Система Джев принимает на вход единый контекст и список типизированных вопросов, после чего параллельная выборка вычисляет все ответы одновременно и независимо друг от друга за один проход.
| Характеристика | Традиционная LLM (ChatGPT, Claude, Gemini) | ИИ-модель Jev |
|---|---|---|
| Метод работы | Авторегрессионный (генерация токен за токеном) | Параллельный сэмплер |
| Формат вывода | Свободный неструктурированный текст | Типизированные значения без ошибок типов |
| Валидация | Требуется парсинг текста и обработка исключений | Ответ готов к подстановке в код |
| Тарификация | Оплачивается вход и каждый сгенерированный токен | Выходные токены всегда бесплатны |
Скорость, цена и калибровка
Рассматривая Jev против LLM, разница в архитектурах напрямую отражается на экономической эффективности. Отличия от ChatGPT и Claude в скорости достигают сотен раз, а снижение затрат исчисляется сотнями раз. Тарифицируются исключительно входные токены, поскольку генерации на выходе нет физически.
Еще одно критическое отличие — наличие встроенной метрики уверенности. Чат-модели, обученные через RLHF, часто демонстрируют высокую уверенность даже когда гадают. Модель выдает ответ и калиброванные вероятности вместе с показателем confidence, так как обучалась методом RLCD специально для объективной оценки неопределенности.
Архитектура, скорость и технические характеристики Jev
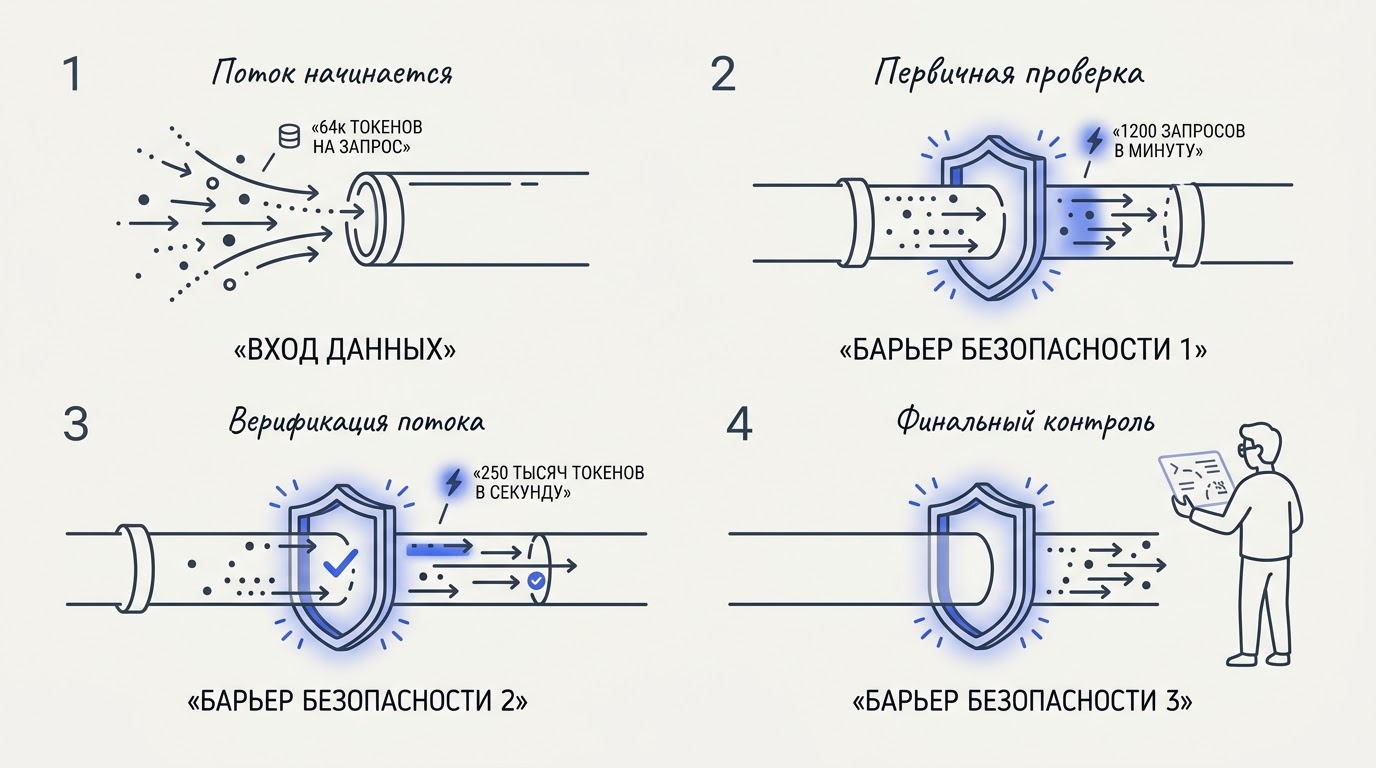
Jev построена на новой архитектуре с параллельным сэмплером и методом обучения RLCD, отвечает за доли секунды и принимает множество вопросов в одном запросе. Скоростные характеристики делают jev-1.13.0 оптимальным выбором для интеграции в realtime-контуры. Лимиты раннего доступа Jev составляли 64k токенов на запрос.
Среда Vercel AI Gateway предоставляет доступ к Jev, что упрощает маршрутизацию для веб-приложений. Технические характеристики указывают на то, что архитектура Jev ориентирована именно на задачи мгновенного сканирования больших массивов данных и точную разметку.
Что раскрыла TypeSafe об устройстве
Лаборатория держит значительную часть информации о внутреннем устройстве под NDA. На данный момент публично подтверждены три ключевых компонента нейросети:
- Новая неавторегрессионная архитектура.
- Инновационный параллельный сэмплер для обработки множества вопросов за один проход.
- Метод обучения Reinforcement Learning for Calibrated Decisions (RLCD), нацеленный на выдачу математически точных вероятностей.
Точное число параметров, веса, детальная нейроархитектура и предельная длина контекста разработчиками публично не раскрыты. На платформе Vercel AI Gateway поле размера контекста для модели явно указано как «не задано».
Скорость и лимиты запроса
Время ответа Jev составляет доли секунды, что сопоставимо с пингом сетевых сервисов. Установленные лимиты токенов в период раннего доступа были строгими: 64k токенов на запрос, 32k для совокупной длины state и самого длинного вопроса, 1200 запросов в минуту и 250 тысяч входных токенов в секунду.
В текущей версии jev-1.13.0 в одном запросе можно передать текст и до 256 вопросов одновременно. Стоит учитывать накладные расходы провайдера: к каждому обращению система добавляет около 280 служебных токенов, поэтому группировка вопросов является предпочтительным способом оптимизации.
Как это работает: типы вопросов Choice, Score и Noul
Jev работает через несколько типов вопросов: Choice выбирает вариант из обширного списка ответов, Score возвращает оценку по многоуровневой шкале, а Noul отвечает да/нет с определенной долей вероятности. Использование этих decision primitives избавляет разработчиков от написания многоэтажных промптов, требующих строгого форматирования в JSON.
Все эти typed questions передаются единым массивом, и ИИ оценивает их параллельно. В рамках одного HTTP-запроса типы вопросов Jev можно смешивать: все вопросы видят общий предоставленный state, но не видят ответов друг друга, что исключает каскадные галлюцинации.
Три примитива решений
Взаимодействие с API строится на выборе одного из доступных форматов. Чтобы получить решение, разработчик формирует объект запроса по следующему алгоритму:
- Формируется общий контекст (state и questions) — например, тело электронного письма или лог действий пользователя.
- Добавляется массив вопросов. Для многоклассовой классификации используется тип Choice: он позволяет выбрать один вариант из заранее заданного обширного набора вариантов ответа.
- Для оценки тональности или уровня угрозы применяется тип Score, который распределяет вероятность по шкале от 2 до 10 уровней и возвращает оценку, способную быть дробной (например, 7.4).
- Для бинарных проверок используется примитив Noul, который отвечает на вопрос «да/нет» вероятностью от 0 до 1.
- Модель обрабатывает запрос и возвращает типизированный объект, готовый к десериализации в код приложения без дополнительных проверок.
Вероятности и порог доверия
Каждый возвращаемый ответ сопровождается не только выбранным значением, но и распределением вероятностей вместе с показателем confidence. Важно понимать, что confidence характеризует форму распределения ответов, а не является стопроцентной гарантией фактической правоты нейросети.
TypeSafe настоятельно рекомендует разработчикам калибровать пороги отсечения на собственных размеченных данных. В критических узлах, где цена ошибки высока, порог доверия ставят выше, а все сомнительные кейсы, оказавшиеся ниже порога, отправляют на ручную проверку человеку.
Сколько стоит Jev и как считается цена
Использование Jev стоит сущие копейки за огромное количество входных токенов, а выходные токены бесплатны. Эта экономическая модель кардинально меняет подход к проектированию ИИ-агентов, позволяя многократно прогонять огромные массивы данных без риска получить непредсказуемый счет за инфраструктуру.
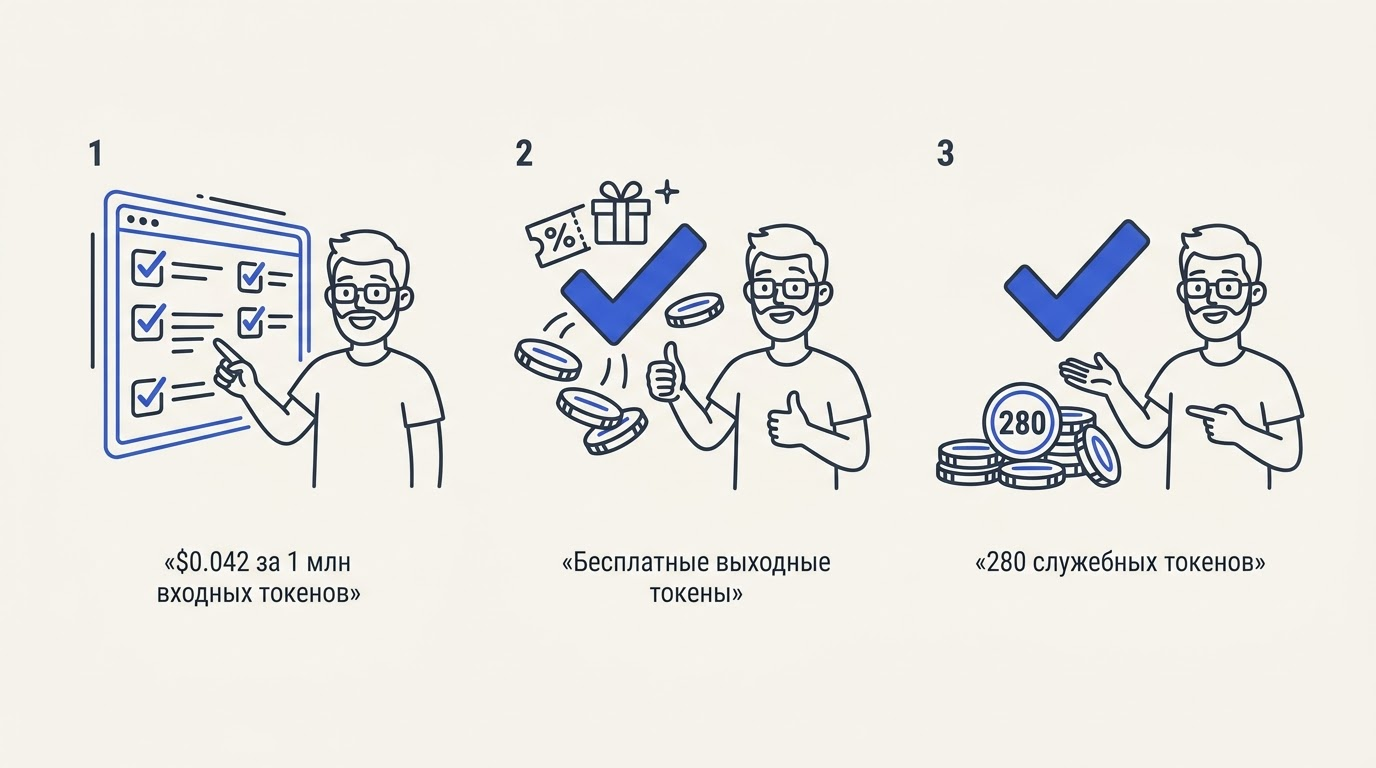
Доступ к Jev через платформу Vercel AI Gateway оценивается примерно в $0.04 за миллион токенов. Бесплатный выход связан с самой природой неавторегрессионной архитектуры: модель не тратит вычислительные мощности на последовательную генерацию символов.
Тарификация входных токенов
Официальная цена Jev составляет считанные доли цента за огромное количество входных токенов. Тарификация складывается из нескольких компонентов:
- Размер переданного контекста (state).
- Суммарная длина текста всех заданных вопросов.
- Служебная нагрузка: к каждому запросу провайдер добавляет около 280 служебных токенов.
Из-за фиксированной добавки служебных токенов стоимость токенов оптимизируется батчингом: экономически нецелесообразно отправлять каждый вопрос отдельным сетевым запросом. Выгоднее упаковать несколько проверок в один вызов к общему стейту.
Почему низкая цена не всегда означает дешёвую цепочку
В агентных сценариях, где бот выполняет многоступенчатые действия, контекст (состояние среды) заново отправляется на каждом шаге цикла. Поскольку входные токены постоянно накапливаются с каждым действием, суммарная стоимость сессии может стать заметной, несмотря на дешевизну J pricing.
Для примера, в разобранном разработчиками трейсе поиска авиабилетов 90 558 входных токенов Jev обошлись всего в $0.003803436. Однако из-за постоянной переотправки одного и того же растущего стейта на модель в итоге пришлось около 98% всех инфраструктурных расходов в этой конкретной цепочке.
Где применяют Jev: AI-агенты, сортировка и защита действий
Jev применяют для создания браузерных агентов и торговых ботов, массовой сортировки почты и блокировки опасных действий, а также как слой решений внутри агентного цикла и интеграции LangChain. Сценарии Jev включают задачи компрессии данных: ИИ успешно сократил контекст Claude Code, сделав код компактнее для дальнейшего анализа.
В связке с тяжелыми LLM нейросеть выступает как decision layer в агенте, отвечая за мгновенную оценку ситуации и принятие решения о маршрутизации. Для сложных систем, таких как флагманская модель Claude Fable, инструмент служит надежным первичным фильтром.
Агенты, боты и модерация
Модель используют для создания браузерных AI-агентов, торговых ботов, массовой сортировки почты и блокировки опасных действий в модулях безопасности (например, в AutoModeMiddleware). Быстрая реакция критически важна для симуляций в реальном времени.
- Создание демо-проектов в Minecraft, симуляциях дронов и вождения заняло у разработчиков от 15 минут до менее 1 часа.
- Короткая сессия в Minecraft потребила множество токенов за сущие копейки.
- Непродолжительная симуляция дрона обошлась в несколько центов.
- В мобильной демонстрации агент Jev выполнил заказ Uber за несколько действий менее чем за полминуты.
Обвязка других моделей и разбор потоков данных
ИИ отлично справляется с задачами фильтрации информации перед подачей в более медленные генеративные сети, работая как интеллектуальный роутер моделей.
| Название теста / Инструмента | Результат применения |
|---|---|
| Тест fast-jev-compaction | Jev многократно сократил контекст Claude Code примерно за секунду |
| Массовая сортировка контента | Jev распределил 1018 AI-статей по 24 темам за $0.08 с медианой 256 мс на статью |
| Интеграция с LangChain | Модель доступна как TypeSafeClassifier в middleware для роутинга и гейтинга рискованных вызовов инструментов |
Способность за секунды обрабатывать мегабайты текста позволяет встраивать компонент в конвейеры, где классические сети стали бы узким местом из-за лимитов и задержек.
Ограничения, точность и первые независимые тесты
Решая, стоит ли использовать Jev, нужно помнить, что она не пишет текст, слаба в арифметике и датах и совпадает с эталоном лишь в 67,8% случаев, тогда как сильнейшие модели достигают 73–74%, но первые независимые тесты подтвердили её скорость и калибровку. В сложных логических задачах модель уступает продуктам от DeepSeek и OpenAI, однако уверенно конкурирует с Gemini, Claude и Anthropic Fable 5.1 в нише структурированной классификации.
Отсутствие генерации и недостатки Jev означают, что модель не сможет переписать письмо или сгенерировать код. Кроме того, она испытывает проблемы с косвенными вопросами, демонстрируя так называемую model jaggedness — неравномерность компетенций. Использование ИИ оправдано только в специфических пайплайнах, таких как агентный бенчмарк Terminal-Bench.
Точность и слабые места
Точность на бенчмарках TypeSafe показывает, что Jev совпадает с эталоном в 67,8% случаев (в качестве референса берется среднее между GPT-6 Astra и Fable 5.1), тогда как сильнейшие модели достигают 73–74%. Ограничения Jev на реальных наборах данных также заметны:
- На 1565 деловых письмах Gemini оказался точнее Jev в классификации по 10 категориям.
- На 2000 фишинговых писем Jev уступил Claude Haiku 4.5.
- После непродолжительного обучения на множестве примеров узкоспециализированный GLiNER превзошел Jev на несколько процентных пунктов.
Что показали первые независимые проверки
Несмотря на просадки в прямом сравнении качества с флагманами, независимые тесты подтвердили колоссальное преимущество в производительности и стоимости.
- В независимом тесте издания Every Jev оказалась примерно в 25 раз быстрее и в 580 раз дешевле Claude Fable 5.1 на извлечении данных — 0,35 с против 8,83 с на фрагмент.
- Глава отдела оценок Every выполнил сотни суждений за доли секунды за мизерную сумму.
- На недавнем бенчмарке из десятков кейсов рискованности вызовов инструментов точность оказалась крайне высокой, и каждый ошибочный ответ имел низкую уверенность.
- На модерации объявлений NearHere Jev показал значительно более высокую точность по сравнению с Gemini Flash-Lite и обошёлся в десятки раз дешевле.
- На десятках тысяч спам-писем в режиме zero-shot точность оказалась почти стопроцентной.
- Использование Jev обходится в 238 раз дешевле, чем флагманская модель Anthropic Fable 5.1.
Как получить доступ к Jev, в том числе из России
Доступ к Jev открывается через ранний доступ TypeSafe по листу ожидания, а также через Vercel AI Gateway, OpenRouter, Cloudflare Workers AI и каталог Polza.AI с оплатой в рублях из России. Лимит Jev на запрос в 64k токенов распространяется на большинство этих провайдеров, однако коммерческие агрегаторы упрощают финансовую логистику для разработчиков.
У самой лаборатории TypeSafe модель typesafe-ai/jev предоставляется в раннем доступе через закрытый лист ожидания. После одобрения пользователь создает API ключ и вызывает эндпоинт POST /v1/systemone с лимитами 64k токенов на запрос и 1200 запросов в минуту. Этот путь подходит для западных компаний с корпоративными картами.
Для беспрепятственной работы Jev из России помимо прямого доступа модель typesafe/jev вызывается через международные хабы, такие как OpenRouter и Cloudflare Workers AI. Каталог Polza.AI предлагает доступ к Jev и более чем 400 моделям с единым ключом и балансом, позволяя пополнять счет в рублях без использования VPN и иностранных карт.