
Модель Jev для аналитики: как аналитику использовать System One модель от TypeSafe AI
Применение модели Jev для аналитики позволяет прогнать десятки тысяч неструктурированных текстовых записей через ИИ, получая на выходе не сгенерированный текст, а точные вероятностные решения. Если вы планируете попробовать jev в корпоративных контурах, важно понимать архитектуру системы. Алгоритм от TypeSafe AI стал первой моделью System One, публично представленной 21 сентября 2026 года для приема состояния приложения и возврата типизированных ответов.
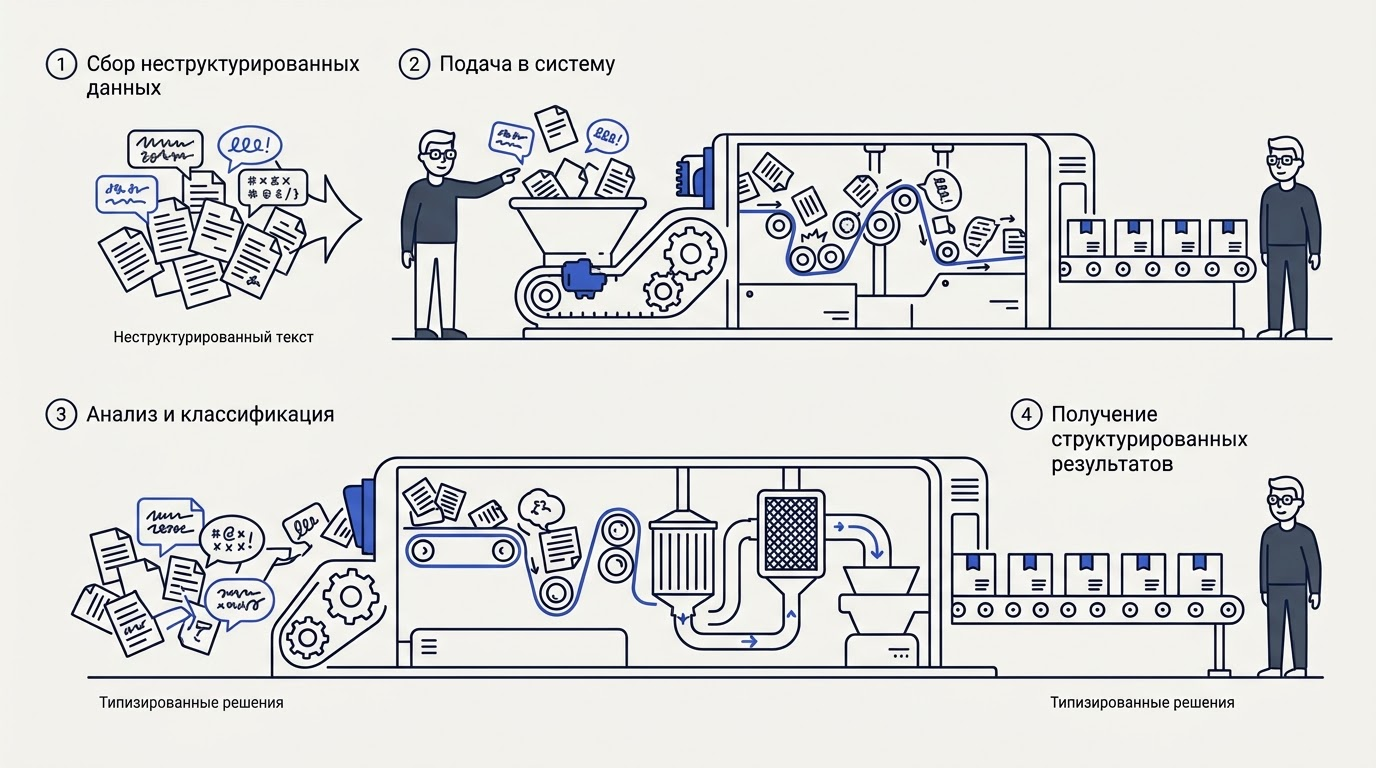
Для дата-инженера этот инструмент полностью меняет механику парсинга. Классификация отзывов, скоринг лидов, тегирование обращений и извлечение признаков для машинного обучения превращаются в один быстрый пакетный вызов. Каждый ответ снабжён калиброванной вероятностью, что делает результаты пригодными для немедленной алгоритмической обработки. Поскольку выход строго типизирован, нейросеть не выдумывает новые категории, полностью исключая любые галлюцинации по построению.
В материале подробно разбирается концепция парадигмы System One и её базовые отличия от классических LLM. Мы изучим механику работы форматов Choice, Score и Noul, рассмотрим эффективные паттерны применения алгоритма, тарифы на входные токены и фундаментальные ограничения инструмента.
Что такое модель Jev и класс System One
Jev — первая модель класса System One от TypeSafe AI, которая принимает состояние приложения и возвращает типизированные вероятностные решения, а не текст. Этот принципиально новый подход меняет то, как системы искусственного интеллекта интегрируются в корпоративные контуры и аналитические скрипты. Вместо того чтобы полагаться на текстовые ответы, которые нужно парсить и проверять регулярными выражениями, Jev сразу выдаёт структурированные данные. Модель принимает на входе состояние приложения и возвращает типизированные вероятностные решения, полностью готовые для использования в программной логике.
Кто и когда создал Jev
Компанию TypeSafe AI, которая разработала архитектуру, основал Диого Алмейда, бывший исследователь OpenAI. Алмейда принимал непосредственное участие в создании ChatGPT и разработке алгоритмов RLHF, что позволило ему глубоко изучить архитектурные ограничения языковых моделей при интеграции в код. Сама модель принятия решений Jev названа в честь выдающегося экономиста Уильяма Стэнли Джевонса, известного своими историческими работами по теории полезности и маржинальному анализу.
Инструмент был официально представлен рынку 21 сентября 2026 года. На старте платформы разработчикам и аналитикам предлагается исключительно ранний доступ по листу ожидания (early access). Это связано с необходимостью контролировать вычислительную нагрузку на инфраструктуру и собирать качественную обратную связь от первых пользователей, внедряющих концепцию в рабочие процессы. Такой подход гарантирует высокую стабильность работы эндопинтов для уже подключенных команд.
Идея System One: «функция вызова фронтир-интеллекта»
Базовая парадигма архитектуры System One Model звучит как «unstructured state in — typed probabilistic decisions out». Jev не является классической чат-моделью для ведения диалогов и ответов на вопросы пользователя в свободной форме. Это специализированный компонент, встраиваемый внутрь программного обеспечения, который берёт на себя функцию принятия сложных нечётких решений.
Там, где раньше дата-инженерам приходилось прописывать сотни жёстких правил парсинга или вызывать дорогие генеративные нейросети, теперь работает компактная функция вызова интеллекта. Jev получает сырой контекст и возвращает строго заданный формат вероятностного ответа, работая как надёжный фильтрующий слой между неструктурированными логами и строгой бизнес-логикой приложения.
Чем Jev отличается от обычных LLM и почему не галлюцинирует
Jev не генерирует текст, а возвращает заранее заданный типизированный результат, поэтому не может выдумать несуществующую категорию и не галлюцинирует. Модель принимает на входе состояние приложения и возвращает типизированные вероятностные решения в строгом соответствии с запрошенным массивом вариантов. Если классическая большая языковая модель (LLM) свободна в своём творчестве и может выдать непредвиденную строку, ломающую парсер, то Jev ограничена на уровне самой архитектуры. Как отмечают создатели архитектуры System One, главный фокус сделан именно на абсолютной предсказуемости ответов алгоритма.
Текст против типизированного решения
Обычная LLM генерирует строки последовательно, токен за токеном, и в процессе часто переоценивает свою уверенность в выданном ответе. Модель Jev работает совершенно иначе: она выдаёт структурированное значение с помощью параллельного вероятностного сэмплера. Аналитик на этапе формирования запроса заранее задаёт строгую форму выхода — например, фиксированный список возможных тегов для классификации входящего обращения.
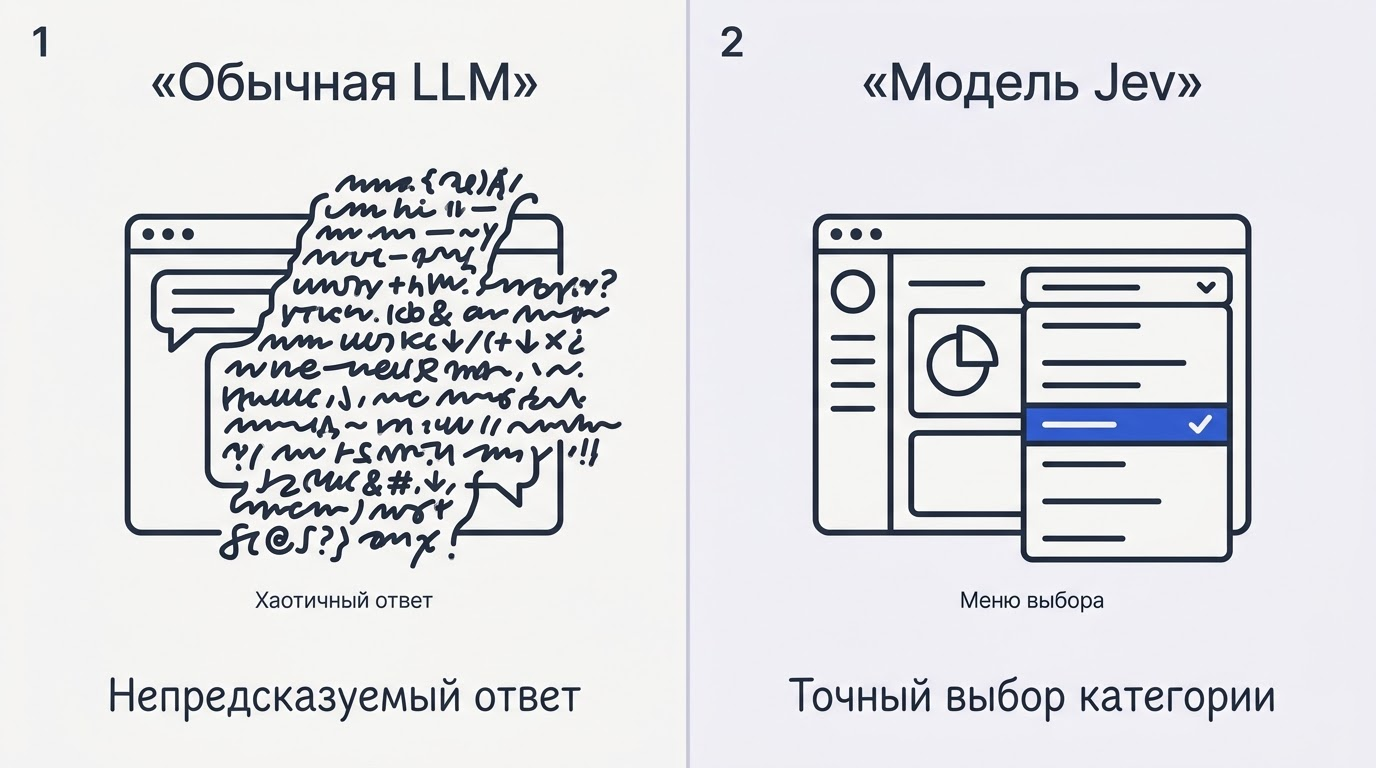
Поскольку выходная структура зафиксирована в запросе, галлюцинации ИИ исключены по построению. Модель Jev физически лишена способности сгенерировать категорию, которой не было в изначальном списке. В то время как обычная LLM пытается статистически угадать наиболее вероятное следующее слово, Jev оценивает распределение вероятностей для каждого из предложенных вариантов, что радикально повышает надёжность массовой классификации.
Калибровка и RLCD
Отдельного технического внимания заслуживает калиброванная вероятность и оценка уверенности. Если Jev заявляет о высокой вероятности принадлежности текста к категории спама, это действительно означает, что в большинстве подобных реальных случаев текст является спамом. Эта строгая математическая честность достигается уникальным методом обучения — RLCD (Reinforcement Learning for Calibrated Decisions), который пришёл на смену традиционному RLHF (обучение с подкреплением на обратной связи).
Для дата-аналитика это означает, что выдаваемым вероятностям можно доверять как независимому числовому признаку в датасете. Алгоритм объективно оценивает границу собственных знаний при анализе. Если уверенность алгоритма низкая, система не пытается симулировать экспертность, а честно возвращает низкий скор, позволяя перенаправить сложный случай на ручную проверку аналитику.
Как устроена Jev: вход, вопросы и типизированный выход
На вход Jev подаётся состояние приложения (текст, JSON или массив) и набор структурированных вопросов, а на выходе по каждому вопросу возвращается типизированное решение с вероятностью. Jev принимает на входе состояние приложения и возвращает типизированные вероятностные решения, строго опираясь на заданную схему. Платформа поддерживает три типа вопросов — Choice, Score и Noul, которые полностью закрывают потребности при анализе текстов.
Что подаётся на вход (state)
Application state (состояние приложения на входе) представляет собой исключительно текстовую информацию. Аналитик может передать в модель сырую строку текста, многоуровневый JSON-объект с метаданными или плоский массив текстов для пакетной обработки. Важно учитывать архитектурные рамки: на данный момент система работает только с текстом, поэтому любые изображения, аудио и видеофайлы не поддерживаются.
Архитектура накладывает чёткие ограничения на размер передаваемого контекста. Вы можете передать до 64k токенов на состояние и все заданные вопросы вместе, при этом действует жёсткий лимит в 32k для совокупной длины state и самого длинного вопроса. Сама модель Jev обучена методом RLCD (Reinforcement Learning for Calibrated Decisions), что позволяет ей эффективно удерживать контекст в рамках этих лимитов и давать высокоточные ответы без деградации качества на длинных документах.
- Соберите сырые текстовые данные, отзывы или логи из вашей базы данных.
- Очистите тексты от системного мусора, HTML-тегов и нечитаемых символов.
- Упакуйте данные в единый текстовый блок, JSON-объект или строковый массив.
- Сформулируйте список типизированных вопросов к этому состоянию.
- Отправьте собранный state и вопросы единым POST-запросом.
Три типа вопросов: Choice, Score, Noul
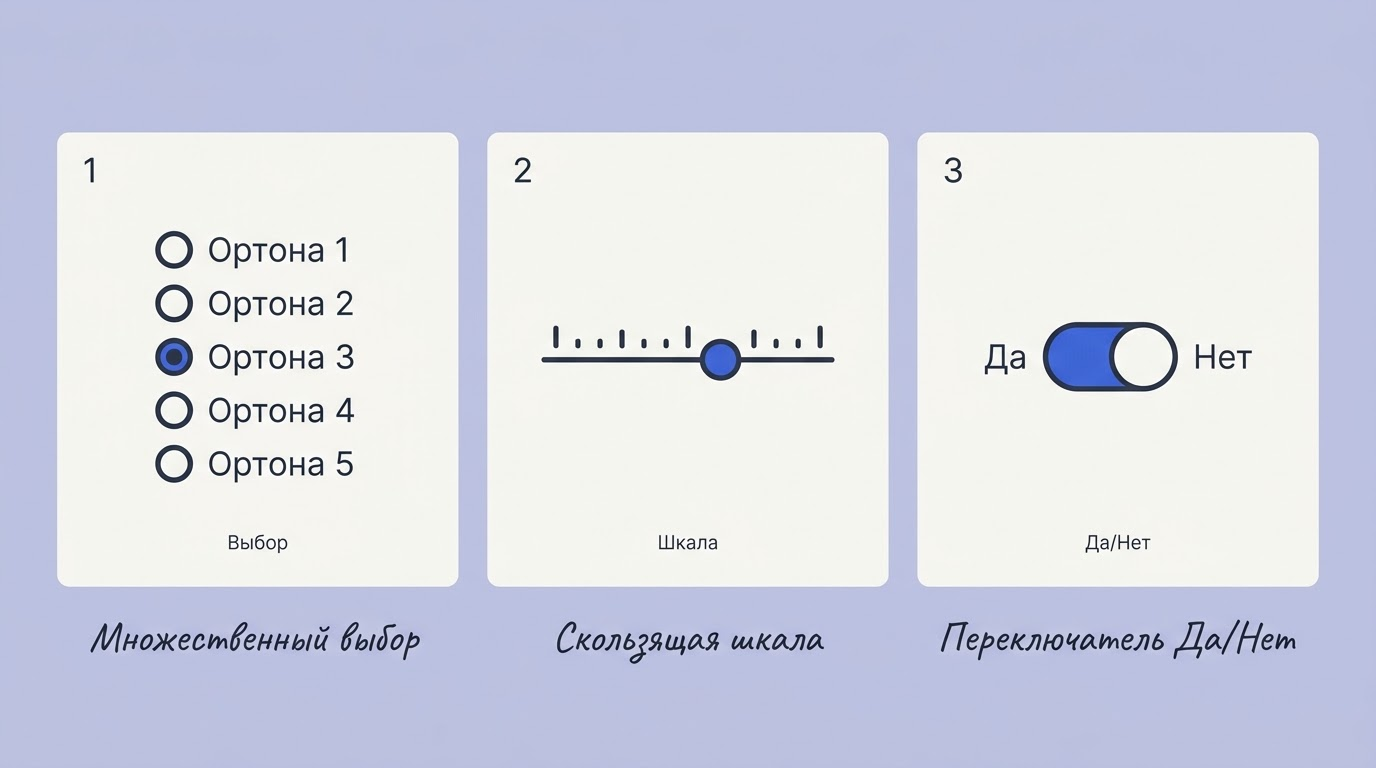
Система предлагает аналитикам три фундаментальных формата запросов. Тип вопроса Choice (выбор из N) — это базовый инструмент классификации. Choice позволяет выбрать один вариант из предложенного списка, который может содержать до 255 категорий. В ответ скрипт получает сам сделанный выбор, полное распределение вероятностей по всем заданным категориям и итоговую оценку калиброванной уверенности модели.
Два других формата закрывают задачи точечной оценки и бинарной детекции:
- Тип вопроса Score (оценка по шкале) определяет позицию объекта на непрерывной шкале, состоящей из 2–10 уровней. Модель может выдать дробное значение, попадающее между уровнями (например 1.035), что превосходно подходит для расчёта рейтинга тональности.
- Тип вопроса Noul (да/нет вероятность) возвращает чистое вероятностное значение от 0 до 1 вместе с показателем confidence. Этот формат идеально работает для быстрой бинарной детекции, например, когда нужно найти спам.
Какие задачи аналитики закрывает Jev
В аналитике Jev решает задачи классификации в масштабе, скоринга лидов, детекции свойств, извлечения признаков и ранжирования данных по семантической релевантности. Jev применяется в аналитике для классификации, скоринга и извлечения признаков без необходимости написания сложных парсеров на регулярных выражениях. Вместо поддержки громоздких скриптов, команды используют один стандартизированный вызов.
Классификация и тегирование в масштабе
Классификация в масштабе (batch) — одна из мощнейших сторон платформы. Дата-аналитики регулярно сталкиваются с потребностью тегировать сотни тысяч отзывов, тикетов технической поддержки или коротких поисковых запросов. Используя тип вопроса Choice, можно разом категоризовать гигантские массивы текстов. Поскольку Choice позволяет выбрать один вариант из до 255 категорий, модель справляется даже с глубокими многоуровневыми корпоративными онтологиями.
Типичный пример массового применения — потоковый анализ тональности клиентских обращений и переразметка старого исторического датасета по актуальным темам продукта. Вы загружаете массив отзывов в состояние, задаете список тегов, и модель Jev за один короткий прогон возвращает структурированный JSON с вероятностным весом для каждой выявленной тематики.
Скоринг и детекция
Задачи оценки качества решаются с помощью числовых форматов запроса. Скоринг лидов и контента отлично ложится на тип вопроса Score, который позволяет плавно измерять степень релевантности, качество ответа или уровень серьёзности системного инцидента. Если же вам требуется простая детекция бинарного свойства, в процесс включается тип вопроса Noul.
С помощью типа Noul Jev AI с высочайшей точностью определяет покупательское намерение клиента или наличие рекламного спама в сообщении, возвращая чистую математическую вероятность. Эти инструменты критически важны при настройке автоматической приоритизации входящих писем: обращения с высоким скором срочности моментально перенаправляются на старших инженеров поддержки.
Извлечение признаков для ML
Извлечение признаков для ML (feature extraction) открывает абсолютно новые горизонты для дата-саентистов. Платформа TypeSafe AI способна извлекать нечёткие вероятностные признаки непосредственно из сырого естественного языка — например, уровень срочности проблемы (urgency), интерес пользователя к конкретному продукту (product interest) или общую готовность к покупке (purchase intent).
Извлечённые из текста вероятности комбинируются со стандартными табличными данными из CRM-систем. Этот обогащённый датасет затем используется для обучения внутренних downstream-моделей. Наличие таких фичей значительно повышает метрики качества работы алгоритмов, отвечающих за предсказание рыночного спроса (demand forecasting) и точечную оценку операционных рисков (risk assessment).
- Классификация отзывов и тикетов в масштабе до 255 категорий.
- Скоринг лидов, контента и приоритизация инцидентов поддержки.
- Бинарная детекция спама и покупательских намерений (purchase intent).
- Экстракция вероятностных признаков текста для обучения ML-моделей.
Как начать: доступ, API и первый запрос
Для начала работы нужно получить ключ в консоли console.typesafe.ai, установить библиотеку typesafe-sdk и отправить POST-запрос на эндпоинт /v1/systemone с состоянием и списком вопросов. Технически Jev доступна через API /v1/systemone и SDK, что делает процесс интеграции прозрачным для бэкенд-инженеров и аналитиков. Нейросеть разработана компанией TypeSafe AI с акцентом на бесшовное встраивание в микросервисные архитектуры. Изучить структуру JSON-ответов поможет официальная документация по вызовам API.
Доступ и ключ API
На сегодняшний день платформа предоставляет ранний доступ (early access) по листу ожидания для бизнес-пользователей. Чтобы инициировать интеграцию, специалисту необходимо оставить заявку на лендинге разработчика и дождаться аппрува учетной записи. После одобрения заявки вы сможете авторизоваться в административной панели Console TypeSafe AI.
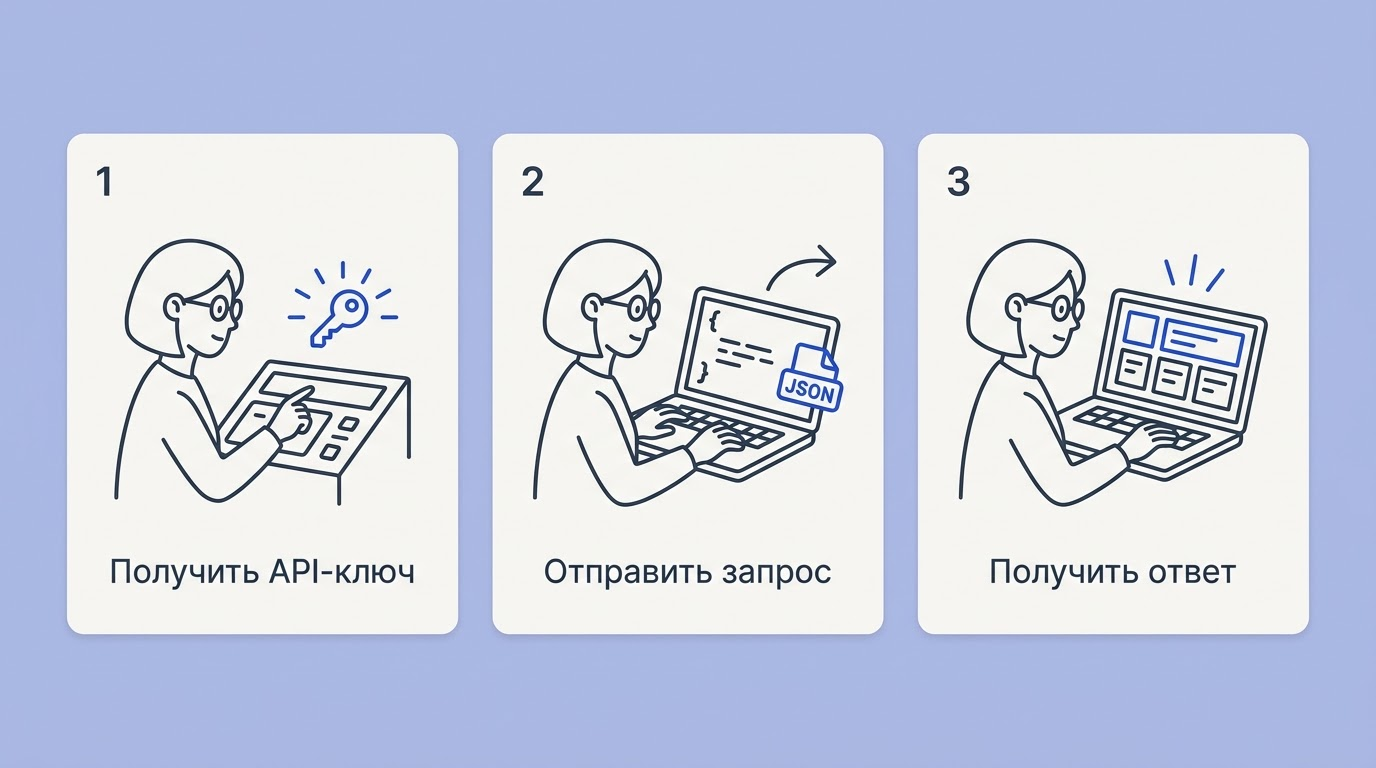
Внутри консоли, перейдя по пути console.typesafe.ai/settings/keys, пользователь генерирует свой уникальный секретный ключ. Этот ключ требуется безопасно сохранить на сервере в переменных окружения. Обратите внимание, что на сентябрь 2026 года доступ к платформе ограничен ради обеспечения отказоустойчивости инфраструктуры, поэтому активации происходят порционно.
SDK и эндпоинт
Для комфортной работы с бэкендом выпущен официальный пакет typesafe-sdk. Разработчики экосистемы Python (требуется актуальная версия) могут установить его стандартной командой pip install typesafe-sdk. Для инженеров, использующих современные версии Node.js, пакет устанавливается через NPM: npm install @typesafe-ai/sdk.
Если команда предпочитает работать с сетевым слоем напрямую без обёрток, данные отправляются через POST-запрос на базовый эндпоинт API. Архитектура запроса логична: в JSON-теле передаётся корневой объект state с анализируемым текстом, а также массив questions, где аналитик описывает каждый вопрос, указывая его тип (Choice, Score или Noul) и параметры шкалы.
Паттерны применения Jev для аналитиков
В аналитике активно применяются рабочие паттерны speculative fan-out, confidence-gated routing, composite scoring, cascade и retrieve-then-judge, позволяющие выжать максимум эффективности из платформы. Учитывая, что Jev поддерживает три типа вопросов — Choice, Score и Noul, эти паттерны позволяют гибко выстраивать логику приложения. Важнейший фактор здесь — скорость: Jev быстрее фронтир-LLM в 40–200 раз, что делает многоэтапные алгоритмы экономически рентабельными для обработки сотен тысяч строк.
Fan-out и композитный скоринг
Сценарий speculative fan-out подразумевает, что вы задаете алгоритму абсолютно все возможные вопросы к тексту одновременно в одном батче. Поскольку нейросеть анализирует контекст параллельно, добавление десятков вопросов стоит лишь дополнительных входных токенов, но фактически не увеличивает время ожидания финального ответа сервера.
Паттерн composite scoring (композитный скоринг) решает проблему абстрактных оценок: он позволяет разбить неоднозначное суждение на пять-семь измеримых осей. Вместо одного общего запроса «насколько хорош текст», модель Jev AI оценивает конкретные критерии через шкалы Score. Итоговый результат собирается вашим кодом как простая взвешенная сумма баллов, повышая прозрачность решения.
Маршрутизация по уверенности и каскад
Confidence-gated routing (маршрутизация по порогу уверенности) опирается на калиброванную вероятность Jev. Аналитик задает порог уверенности под каждое бизнес-действие. Если калиброванная уверенность превышает заданный высокий порог, код выполняет действие автоматически бездушной машиной, если падает до низких значений — задача моментально отклоняется или отправляется в корзину.
Для сомнительных средних значений вступает в игру паттерн Cascade (Jev + фронтир-модель). Jev выступает быстрым контрольно-пропускным пунктом: простые очевидные случаи закрываются кодом мгновенно, а сложные тексты, где уверенности не хватило, эскалируются в тяжелую LLM. В сочетании с тактикой retrieve-then-judge (отфильтровать источники, затем судить) это бережёт деньги и не роняет метрики качества классификации.
- Speculative fan-out: задавать все метрические вопросы системе одновременно.
- Composite scoring: собирать финальный балл как взвешенную сумму шкал.
- Confidence-gated routing: направлять логику кода по порогам уверенности.
- Cascade: фильтровать очевидное в Jev, сложное — отдавать в обычную LLM.
- Retrieve-then-judge: использовать Jev для первичного отсева мусорного контекста.
Цена, скорость и лимиты токенов
Входные токены стоят незначительную сумму за миллион, выходные токены предоставляются бесплатно, а задержка обработки составляет доли секунды при высоком лимите токенов на вызов. Экономика работы с платформой радикально отличается от тарификации классических генеративных нейросетей, где платят за каждый сгенерированный символ. Входные токены Jev стоят $0,042 за миллион токенов, что делает заливку гигантских массивов текстов или логов экономически целесообразной. При этом выходные токены Jev стоят бесплатно (используется подход too cheap to meter), поскольку инструмент отдаёт только короткое типизированное вероятностное решение в формате JSON, а не сочиняет абзацы текста. Официальные тарифы и лимиты эндпоинта детально описывают этот механизм.
С точки зрения производительности System One Model демонстрирует рекордные метрики. Заявленная end-to-end задержка при вызове TypeSafe API /v1/systemone укладывается в диапазон 70–500 мс в зависимости от сложности стейта. Благодаря отказу от авторегрессионного механизма генерации токенов, Jev быстрее фронтир-LLM в 40–200 раз. Инженеры TypeSafe AI подчеркивают, что на внутренних workflow-бенчмарках их модель оказалась до 193,6x быстрее и в 444,6x дешевле, чем ведущие LLM на рынке.
| Параметр API | Значение | Практическая особенность |
|---|---|---|
| Стоимость входа (Input) | $0,042 за 1 млн токенов | Крайне выгодно для длинных логов |
| Стоимость выхода (Output) | $0.00 (Бесплатно) | Поощряет вызов десятков вопросов |
| Задержка (Latency) | 70–500 мс | В 40–200 раз быстрее обычных LLM |
| Суммарный объём токенов | 64k на весь вызов | Ограничение на state и все вопросы |
| Объём токенов на вопрос | 32k на отдельный вопрос | Не позволяет делать слишком объемные ветки |
Планирование бюджета и лимитов токенов при работе с моделью Jev требует смены подхода. Архитектура позволяет передать суммарно до 64k токенов на состояние и все вопросы вместе, но размер одного отдельного вопроса ограничен планкой в 32k токенов. Главная практика для аналитика — рассчитывать бюджет исключительно по объему подаваемых на вход сырых данных. Поскольку выход не тарифицируется, нет никакого финансового смысла экономить на количестве вопросов к тексту. Это делает паттерн fan-out особенно прибыльным: отправив лог один раз и заплатив копейки, вы прогоняете его через десятки независимых проверок.
Чего Jev не умеет: ограничения и риски
Модель не считает, не выполняет математические вычисления и операции с датами, не умеет генерировать текст и программный код, а также понимает запросы слишком буквально. При всей своей колоссальной скорости, Jev имеет строгие пределы применения. Нейросеть концептуально не является универсальной LLM (большая языковая модель), поэтому Jev не подходит для подсчёта, арифметики и генерации текста. Любые попытки заставить её работать вне рамок парадигмы типизированных решений приведут к краху пайплайна.
Модель абсолютно не умеет выполнять расчёты и арифметические операции. Процессы, где требуется сложить суммы чеков из документа, подсчитать точное число упоминаний конкурента или вычислить разницу между датами, алгоритм гарантированно провалит. Ошибка при прямом арифметическом подсчёте растет пропорционально размеру текстового стейта. Задачи подобного класса требуют экстракции сырых фактов и их передачи в классические скрипты Python для достоверной математики.
Алгоритм воспринимает входящий текст и запросы максимально буквально. Поскольку Jev не генерирует текст, поэтому не может галлюцинировать, она также лишена механизма глубокой смысловой рефлексии и додумывания нечётких ТЗ. Сложные словесные отрицания, сарказм и многоуровневые логические условия в вопросах воспринимаются буквально. Аналитикам критически важно писать вопросы и категории кристально ясно, чтобы типизированное вероятностное решение действительно отражало реальность.
Самооценка качества на бенчмарках показывает, когда в процесс должен вмешаться человек. На наборе из нескольких воркфлоу-бенчмарков TypeSafe базовая точность модели зафиксирована на уровне больше половины. Это прекрасный рабочий результат для дешёвой первичной фильтрации сотен тысяч строк, но он подчёркивает риск полной автоматизации. Инженеры обязаны настраивать confidence-пороги и применять паттерн Cascade, уводя случаи с низкой вероятностью на проверку людям.
- Не справляется с арифметикой, сложением и вычислениями дат в тексте.
- Не способна генерировать осмысленные куски текста или писать скрипты.
- Плохо обрабатывает сложные словесные отрицания из-за буквального чтения.
- Требует обязательного контроля порога уверенности при внедрении.
⟦QUOTE⟧Архитектура System One не пытается заменить собой программиста или калькулятор — это скоростной фильтр, упорядочивающий хаос неструктурированных данных перед базой.
Примеры и сравнение с LLM для аналитики
Там, где обычная LLM медленна и дорога для массовой обработки, Jev выдаёт тот же результат в разы быстрее и дешевле, что подтверждается свежими кейсами Vercel и Bryo AI. Инструмент применяется в аналитике для классификации, скоринга и извлечения признаков на гигантских масштабах. Так как Jev быстрее фронтир-LLM в 40–200 раз, продуктовые команды могут анализировать абсолютно 100% клиентских обращений без дорогостоящего сэмплинга и сокращения выборки.
Реальные кейсы классификации
Реальные корпоративные внедрения демонстрируют ошеломляющую эффективность подхода. В кейсе облачной платформы Vercel классификатор безопасности, переведённый на Jev, оказался в 5–18 раз быстрее и существенно точнее популярной модели OpenAI Luna. Настроенная классификация в масштабе (batch) позволила платформе Vercel фильтровать входящий трафик и подозрительные логи без малейших задержек для клиентов.
Второй знаковый кейс — интеграция в Bryo AI. В их сценарии потоковая классификация электронных писем вышла в несколько раз дешевле, чем маршрутизация на базе Gemini. Благодаря тому, что входные токены Jev стоят $0,042 за миллион токенов, массовый анализ рекламных объявлений и скоринг лидов стал доступен командам с небольшими бюджетами, при этом система возвращала честные вероятности для каждой категории.
Когда брать Jev, а когда LLM
Чтобы выстроить устойчивую архитектуру, аналитик обязан чётко разделять юзкейсы. Платформа Jev создана специально для высокоскоростной классификации логов, батч-скоринга, верификации фактов и работы в качестве guardrails-фильтра. Классическая LLM (большая языковая модель) незаменима там, где бизнесу нужно открытое рассуждение, глубокая аналитика сложных контекстов и генерация длинных ответов клиенту.
Оптимальный системный выбор — это применение гибридного подхода, где используется паттерн Cascade (Jev + фронтир-модель). Jev мгновенно сортирует весь сырой мусор и решает тривиальные задачи типизации. Если уверенность Jev падает, она перенаправляет этот малый процент сложных задач в дорогую, но интеллектуальную фронтир-LLM.
| Критерий системы | System One (Jev) | Большая языковая модель (LLM) |
|---|---|---|
| Идеальный сценарий | Массовый скоринг, тегирование батчами | Свободное рассуждение, генерация |
| Формат ответа ИИ | Строго типизированный JSON | Неограниченный поток текста |
| Задержка (Latency) | От 70 до 500 мс (мгновенно) | От 2 до 15 секунд |
| Риск галлюцинаций | Невозможны (исключены по построению) | Возможны, требуют парсинга |
Доступ и оплата из России
При интеграции продукта необходимо брать в расчёт инфраструктурные ограничения. Платформа TypeSafe AI является зарубежным SaaS-решением, и на этапе запуска доступ к API открывается исключительно по листу ожидания (waitlist), требуя предварительного одобрения вашей заявки.
Коммерческий биллинг тарифицируется в USD и требует привязки иностранной банковской карты. На сентябрь 2026 года прямой возможности оплаты российской картой нет, что является блокирующим фактором для независимых локальных аналитиков. Командам из России придётся оплачивать вычислительные мощности через зарубежные корпоративные карты или компании-посредники.