
Модель Jev для кода: как использовать System One от TypeSafe AI в разработке
Модель Jev для кода представляет собой не генератор текста, а вычислительный «мозг решений», который не пытается писать ответы, а выбирает готовое значение из заданной схемы и отдаёт его вместе с вероятностями и оценкой уверенности. Поэтому программист использует нейросеть jev не для того, чтобы писать скрипты за него, а чтобы встроить в свою архитектуру быстрый слой микрорешений — маршрутизацию, классификацию, оценку риска, выбор ветки или инструмента для автономного агента. Эта нейросеть — первая модель семейства System One Models от стартапа TypeSafe AI, анонсированная 16 сентября 2026 года в статусе early access. Через Cloudflare AI она также доступна разработчикам под идентификатором typesafe/jev с огромным контекстным окном в 32 000 токенов.
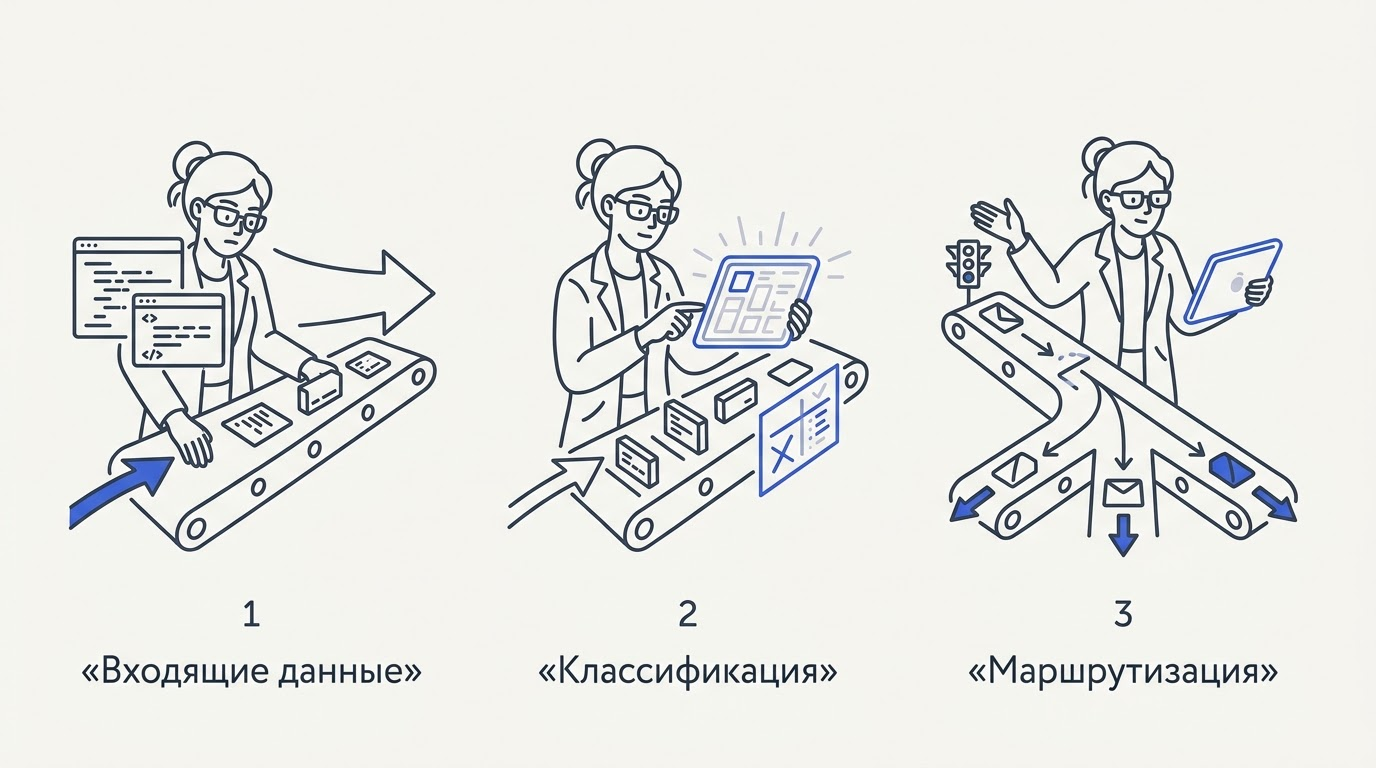
Разработчики обращаются к платформе через единый эндпоинт или через официальные SDK для Python и JavaScript, задавая параметр state (состояние) и типизированные вопросы нескольких видов: Choice, Score и Noul. Ответ от сервера приходит за 70–500 мс, а входные токены стоят всего $0,042 за миллион, что на порядки дешевле любых обычных генеративных нейросетей на рынке.
В этой статье мы подробно разберём, как правильно подключить API, как технически устроены запрос и ответ, что такое confidence score и как выстраивать на нём надёжную маршрутизацию внутри приложения. Также мы очертим границы инструмента: генерировать программный текст, считать математику и работать с временными зонами эта система не умеет — вся эта логика обязательно остаётся в вашем классическом коде.
Что такое Jev и почему это не «ИИ, который пишет код»
Jev является моделью класса System One Models от TypeSafe AI, которая вместо текста возвращает структурированное решение с вероятностями и confidence, гарантируя строгую типизацию вывода. В отличие от популярных сегодня чат-ботов и копайлотов, эта архитектура принципиально не использует авторегрессионную генерацию токен за токеном. Математическое ядро изначально спроектировано для анализа переданного контекста и вычисления распределения вероятностей строго по заданным разработчиком вариантам, что полностью исключает риск галлюцинаций в структуре JSON.
System One: модель решений, а не слов
Парадигма System One Models вдохновлена когнитивной психологией, описывающей быстрое, интуитивное мышление. Система не тратит вычислительные мощности на формирование связных предложений, расстановку запятых или извинения за неполную информацию. Она параллельно вычисляет веса для предложенных вами вариантов ответов и моментально отдаёт результат. Это первая модель семейства System One Models от TypeSafe AI, анонсированная 16 сентября 2026 года в статусе early access для ограниченного круга инженеров.
Инструмент создавался специально для программной интеграции (machine-to-machine). Традиционные LLM (большие языковые модели) расходуют время на лексическую обвязку, тогда как System One выдаёт исключительно данные, готовые к парсингу. Инфраструктуру поддерживает разработчик TypeSafe AI, сфокусированный на безопасности и предсказуемости искусственного интеллекта для высоконагруженных enterprise-решений.
Почему Jev не пишет код, но полезен программисту
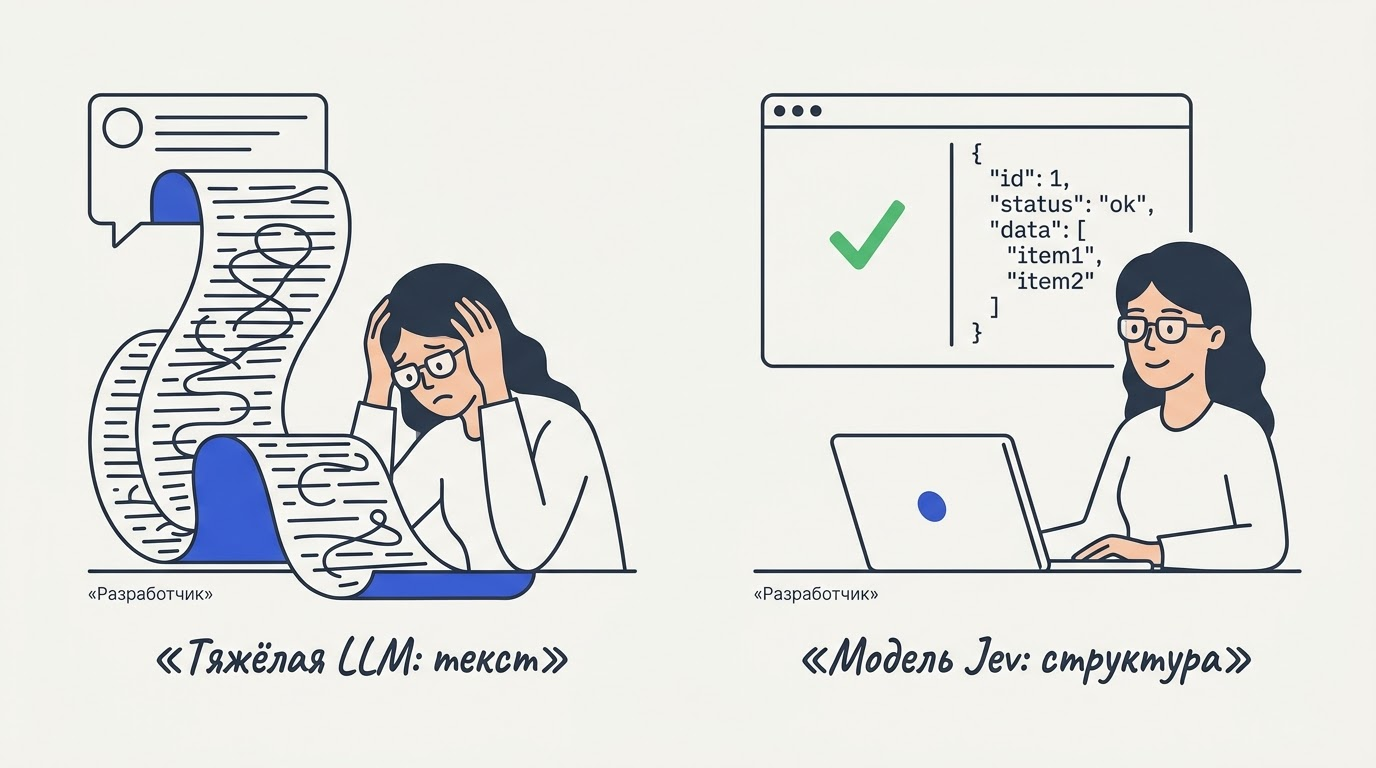
Ключевое правило использования: Jev не умеет генерировать код и текст, он не дополнит вашу функцию и не напишет unit-тест. Его программная роль сводится к принятию микрорешений внутри уже готовой кодовой базы. Разработчик инстанцирует клиент и вызывает нейросеть как обычную асинхронную функцию, передавая ей набор сырых фактов и варианты выбора. Система может классифицировать входящий лог ошибок, оценить вероятность мошенничества при транзакции или распределить задачи по исполнителям.
В результате ИИ становится для инженера «умным оператором switch», способным понимать неструктурированный естественный язык. Там, где раньше приходилось внедрять тяжелые эвристики, писать регулярные выражения или ждать ответа от медленной генеративной модели, теперь работает один легковесный вызов. Такой подход переводит искусственный интеллект из статуса собеседника в статус утилиты.
Чем Jev отличается от LLM и когда его брать
Jev отличается от LLM тем, что за один проход выбирает валидное значение из схемы и вместо текста возвращает структурированное решение с вероятностями и confidence, поэтому его встраивают в горячие пути обработки. Так как Jev не умеет генерировать код и текст, он не конкурирует с классическими чат-ботами, а дополняет их: Jev в коде играет роль быстрого слоя микрорешений для агента, в то время как тяжеловесные генеративные нейросети подключаются только на финальных этапах для синтеза человекочитаемых ответов.
Таблица: Jev vs LLM
Чтобы понять место нового инструмента в архитектуре современных приложений, необходимо сопоставить его характеристики с привычными генеративными решениями.
| Характеристика | Jev (System One Models) | LLM (Generative AI) |
|---|---|---|
| Формат вывода | Валидное типизированное значение | Свободный текст (токен за токеном) |
| Скорость ответа (Latency) | 70–500 мс (задержка фиксирована) | От нескольких секунд до минут |
| Схема ответа | Гарантированная структура без сбоев | Требует промпт-инжиниринга для JSON |
| Генерация контента | Нет (запрещено на уровне весов) | Да (главная функция) |
| Агентные циклы | Нет (stateless вызов) | Да (могут планировать цепочки шагов) |
| Использование инструментов | Нет (только отвечает на вопросы) | Да (могут вызывать сторонние API) |
Сценарии, где Jev выигрывает
Модель идеально подходит для высоконагруженных систем, где цена миллисекунд критична. Первый сценарий — классификация входящих обращений в службу технической поддержки. Приложение передает текст жалобы клиента в параметр state, задает вопросы о категории и возвращает ответ за доли секунды. Тикет мгновенно направляется в нужный отдел без ожидания генерации ответа. Оценка риска платежей, модерация пользовательского контента и категоризация системных логов — задачи, где предсказуемость структуры важнее креативности.
Второй популярный сценарий — оркестрация логики. В ИИ-агентах далеко не каждый шаг требует включения дорогой LLM. Быстрый гейт для проверки намерений (intent recognition) экономит ресурсы серверов. Если система видит простой вопрос, она отдает скрипту команду вывести заготовленный шаблон. Если запрос требует анализа, диспетчер открывает соединение с большой языковой моделью.
Три типа вопросов: Choice, Score и Noul
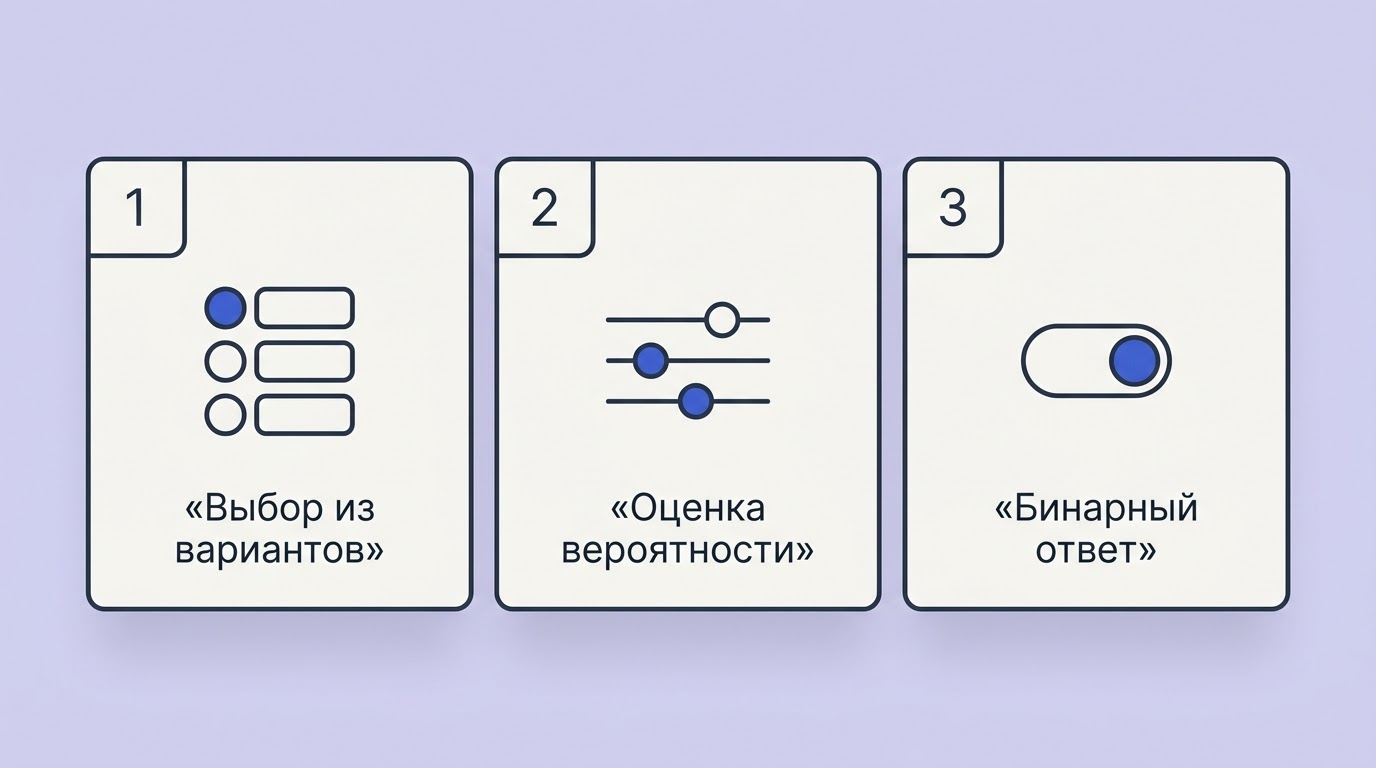
Jev принимает вопросы трёх типов — Choice (выбор одного из нескольких вариантов), Score (позиция на шкале) и Noul (вероятность да/нет), — каждый из которых спроектирован под конкретную математическую задачу. Отправляя батч таких типизированных запросов, программист за один сетевой вызов получает комплексный срез данных, где каждому ответу сопутствуют рассчитанные вероятности.
Choice — выбор одного варианта
Тип Choice работает как строгий категориальный классификатор, который выбирает один вариант из списка, включающего до 255 опций. Он применяется, когда сущность нужно отнести к одному из взаимоисключающих классов.
- Вы задаете массив опций в коде:
["billing", "technical", "sales", "general"]. - Нейросеть анализирует контекст и возвращает не просто строковое совпадение, а полное распределение вероятностей по всем предоставленным вариантам.
- Интегрированная оценка уровня уверенности (Confidence score) подскажет, насколько алгоритм уверен в победителе. Если разрыв между
billingиsalesминимален, программа может перевести задачу на ручную модерацию.
Score — позиция на шкале
Этот тип используется для оценки интенсивности, тяжести или степени срочности события. Вы задаете упорядоченную линейную шкалу, содержащую от 2 до 10 уровней (например, от «незначительно» до «критично»). Jev понимает логическую и семантическую связь между этими уровнями, чего лишены обычные категориальные классификаторы.
Результат возвращается в формате числа с плавающей точкой. Вы можете получить значение вроде 4.15 на пятибалльной шкале, что дает коду тонкий инструмент для балансировки пограничных ситуаций. Это незаменимо при анализе тональности текста (sentiment analysis), оценке токсичности комментариев или определении приоритета системного сбоя. Каждому значению также сопутствует детальная раскладка confidence.
Noul — вероятность да/нет
Самый легковесный и быстрый тип запроса Noul представляет собой строго бинарное суждение. Он предназначен для ответов формата «истина/ложь» и возвращает одно дробное значение в диапазоне от 0.0 до 1.0, которое прямо отражает силу уверенности модели в положительном ответе.
Отдельного параметра confidence для Noul не предусмотрено, поскольку само возвращаемое число уже является вероятностью совпадения. Этот тип идеально подходит для установки логических флагов в приложении: содержит ли текст персональные данные, присутствует ли в сообщении спам, нарушает ли загруженный документ правила платформы.
Как подключить Jev: ключ, SDK и эндпоинт
Разработчик обращается к Jev через единый эндпоинт POST /v1/systemone или через официальный typesafe-sdk, минимизируя время на написание сетевой обвязки. Архитектура интеграции не требует сложных настроек серверов или поднятия собственных контейнеров — весь процесс сводится к получению авторизационного токена и установке легковесной клиентской библиотеки.
Шаги подключения
Процесс внедрения в кодовую базу состоит из предельно понятных шагов. В первую очередь необходимо зарегистрировать аккаунт в панели управления console.typesafe.ai. В разделе настроек безопасности генерируется уникальный API-ключ, который обязательно нужно сохранить в защищенном хранилище переменных окружения вашего приложения.
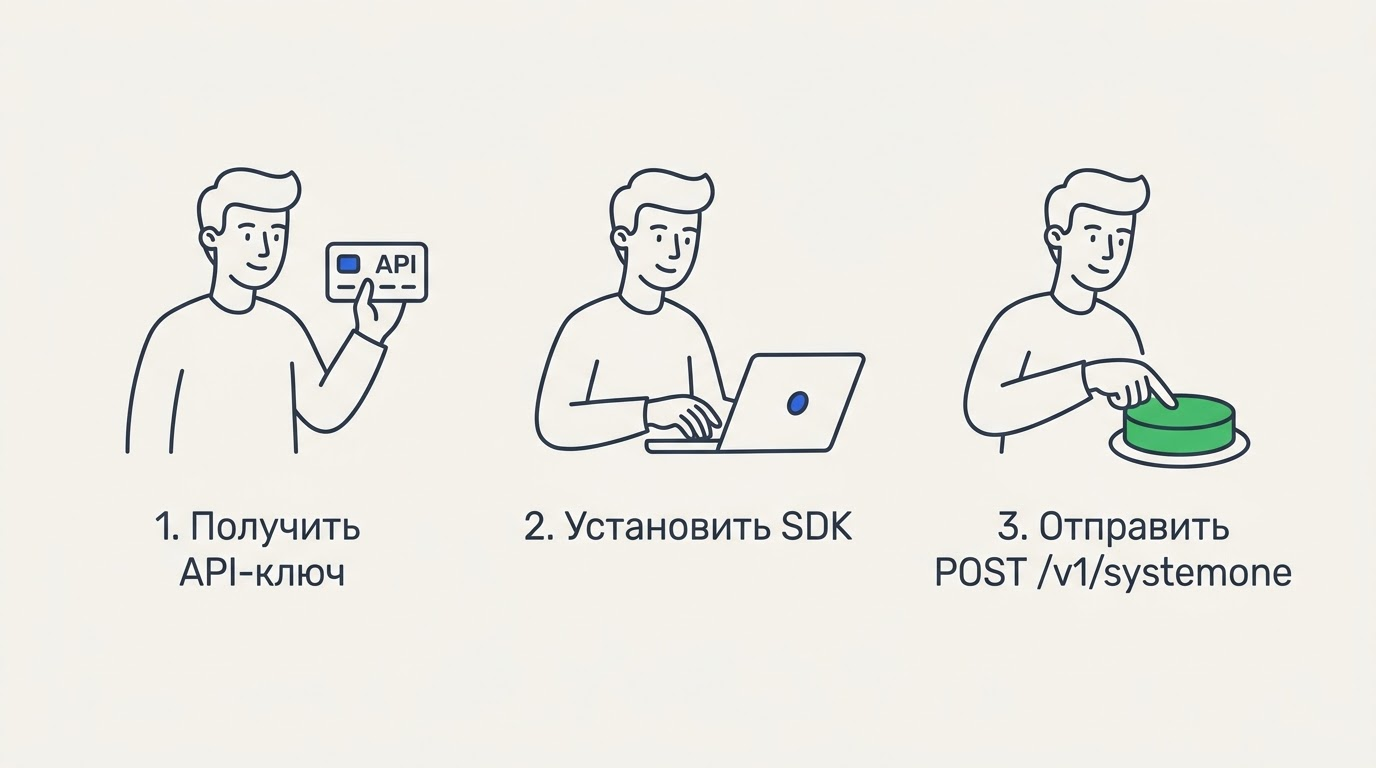
Далее следует установка библиотеки. Для экосистемы Python используется пакетный менеджер (pip install typesafe-sdk), а для JavaScript и Node.js — npm-пакет (@typesafe-ai/sdk). SDK автоматически формирует правильную структуру JSON-запроса, валидирует типы и обрабатывает сетевые таймауты. Полная документация по вызовам методов описывает все доступные классы и интерфейсы.
Если проект требует отказа от сторонних зависимостей, запрос к Jev идёт напрямую на эндпоинт POST https://api.typesafe.ai/v1/systemone. Серверная часть платформы спроектирована под высокие нагрузки: лимиты составляют 250 000 токенов/с и 1200 запросов/мин, а сетевая задержка держится в рамках 70–500 мс. Эти показатели делают технологию пригодной для realtime-систем.
Альтернатива через Cloudflare AI
Для инженерных команд, которые выстраивают микросервисы на базе граничных вычислений (edge computing), существует нативная интеграция в инфраструктуру Cloudflare. Через платформу Cloudflare AI модель доступна под идентификатором typesafe/jev с поддерживаемым контекстным окном 32 000 токенов.
Такой подход позволяет вызывать нейросеть непосредственно из Cloudflare Workers, не совершая лишних сетевых прыжков (hops) до дата-центров TypeSafe. Это критически снижает общую задержку (latency) для конечных пользователей, поскольку вычислительный процесс происходит на ближайшем к клиенту узле глобальной CDN-сети.
Пример кода: запрос и ответ Jev
Разработчик обращается к Jev через POST /v1/systemone или typesafe-sdk, формируя тело запроса из двух ключевых элементов: объекта state (контекста задачи) и словаря questions, куда передаются инстансы нужных классов. Поскольку Jev принимает вопросы трёх типов — Choice, Score, Noul, программист комбинирует их в одном вызове для одновременного извлечения всех необходимых фактов.
Jev is TypeSafe’s structured evaluation model. It evaluates one state against typed Noul, Choice, and Score questions and returns calibrated answers with probabilities and confidence.
Cloudflare
Минимальный вызов на Python
В официальном Python SDK работа строится вокруг строгой типизации. В начале файла импортируются классы Choice, Noul, Score и основной TypeSafeClient. После инициализации клиента с вашим API-ключом, вызывается метод system_one.
В аргумент state передается словарь с фактами, например, текст клиентского письма. В аргумент questions передается структура: {"department": Choice(options=["tech", "billing", "sales"]), "is_urgent": Noul()}. Когда метод завершает работу, в коде доступны прямые обращения к результатам: response.answers['department'].choice или response.answers['is_urgent'].noul. Код получается чистым, без необходимости писать регулярные выражения для поиска нужных слов в ответе.
Что приходит в ответе
Главное преимущество системы — гарантированно валидная структура JSON. Сервер физически не способен вернуть строку с извинениями об отказе или сломанный синтаксис, так как он не генерирует текст.
На каждый переданный ключ в объекте questions приходит вложенный объект ответа. В нём содержится финально выбранное значение (value), массив распределения вероятностей (probabilities) по всем доступным опциям и показатель уверенности (confidence). Исключением является вопрос типа Noul, для которого значение и вероятность объединены в одной переменной. Разработчик сразу направляет эти типизированные данные в логические блоки своего приложения.
Confidence score и маршрутизация решений
Confidence score используется для маршрутизации между кодом, LLM и человеком, выступая математическим триггером в логике приложения. Так как Jev вместо текста возвращает структурированное решение с вероятностями и confidence, разработчик получает возможность перевести ИИ-агента из режима слепого доверия к генерации в режим контролируемого исполнения с понятными порогами безопасности.
Confidence-gated routing
Архитектурный паттерн confidence-gated routing (маршрутизация на базе уверенности) реализуется через обычные условные операторы в программном коде. Программист опытным путём определяет минимальный порог уверенности для каждой критичной задачи.
- Если уверенность классификации достигает высокого показателя, код автоматически применяет решение и двигает процесс дальше.
- Если уверенность падает ниже порога (модель сомневается из-за двусмысленности контекста), запрос блокируется для авто-выполнения и отправляется на эскалацию — к мощной диалоговой LLM или живому сотруднику.
Такой механизм радикально сокращает расходы на генерацию и практически обнуляет риск фатальных ошибок, вызванных галлюцинациями.
Каскад: Jev → код → LLM → человек
Эффективные ИИ-агенты строятся в виде каскадной воронки. Jev располагается на самом верху этой воронки, выполняя роль быстрого и дешевого привратника (gatekeeper). Он сканирует 100% входящего трафика и выносит первичные маршрутизирующие решения.
Львиная доля простых задач после этого уходит в чистый детерминированный код, не требующий вызова нейросетей вовсе. Сложные запросы, требующие генерации писем или аналитики, направляются в профильные LLM (большие языковые модели). Самые неоднозначные случаи падают в дашборд оператору. Этот каскад гарантирует, что тяжелые вычисления запускаются исключительно тогда, когда они экономически и технически оправданы.
Цена, лимиты и скорость Jev
Jev стоит $0,042 за миллион входных токенов, выход бесплатен, а отвечает за 70–500 мс, что радикально меняет экономику эксплуатации ИИ в продакшене. При заявленных инфраструктурных мощностях платформа легко держит лимиты в 250 000 токенов в секунду, обеспечивая стабильную работу высоконагруженных микросервисов без деградации времени ответа.
Тарификация по токенам
Бизнес-модель платформы опирается исключительно на оплату за прочитанный нейросетью контекст. Входные токены Jev стоят $0,042 за миллион, а выходные бесплатны, потому что модель не пишет ответ по токенам и не тратит вычислительные мощности на авторегрессионную генерацию слов. В пересчете на корпоративные объемы это составляет всего $0,042 за миллион токенов.
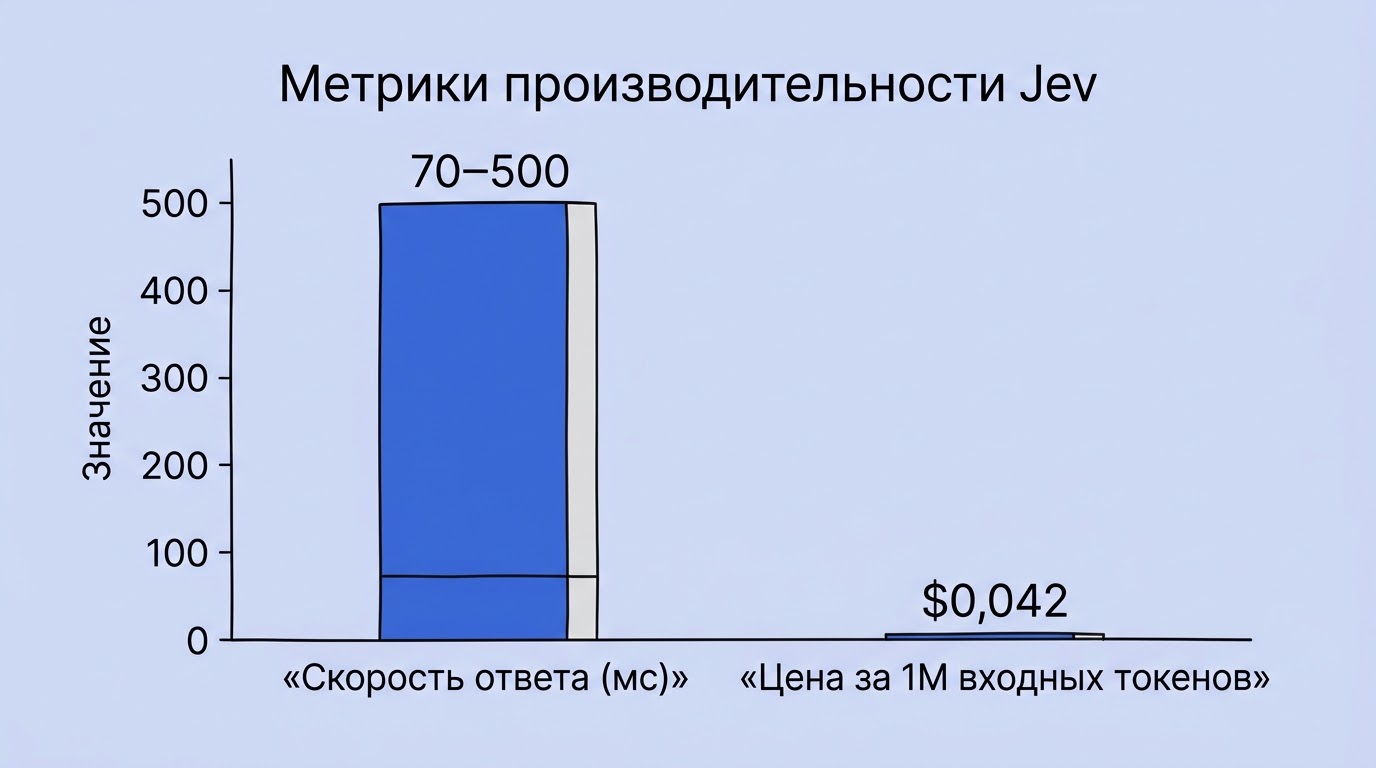
Для сравнения, традиционные языковые системы тарифицируют как вход, так и длинный выход, причём цены часто стартуют от нескольких долларов за миллион. Детальная тарификация токенов в Jev API показывает, что TypeSafe предлагает инструмент, который на два порядка дешевле аналогов. Это позволяет безболезненно передавать в параметр state огромные «простыни» системных логов или полные тексты книг для классификации.
Скорость и лимиты
Низкая сетевая задержка (latency) определяет, где именно в архитектуре может стоять вызов. Задержка в 70–500 мс позволяет интегрировать технологию в горячий путь синхронного запроса клиента (hot path). Обычная LLM за это время успеет лишь сгенерировать первые пару букв (Time To First Token).
| Параметр API | Значение для System One |
|---|---|
| Стоимость входных токенов | $0,042 за 1 000 000 |
| Стоимость выходных токенов | $0 (всегда бесплатно) |
| Время ответа (Latency) | 70–500 мс |
| Пропускная способность (TPM) | 250 000 токенов/с |
| Частота запросов (RPM) | 1200 вызовов/мин |
Официально заявленные лимиты — 250 000 токенов/с и 1200 запросов/мин — покрывают потребности большинства B2B-приложений. Такая пропускная способность даёт инженерам свободу вызывать ИИ сотни раз в рамках одного пользовательского сценария без риска получить ошибку 429 Too Many Requests.
Паттерны использования в коде и агентах
Jev в коде играет роль быстрого слоя микрорешений для агента, выступая интеллектуальным маршрутизатором между функциями. Поскольку Confidence score используется для маршрутизации между кодом, LLM и человеком, архитектура автономных систем становится масштабируемой и надежной. Создатель этого подхода отлично понимает проблематику рынка: основатель TypeSafe AI — Диогу Алмейда, бывший руководитель направления RLHF в OpenAI, сфокусировавший компанию на преодолении узких мест классических агентов.
В инженерной практике закрепились два магистральных паттерна:
- Speculative fan-out: разработчик собирает в один запрос абсолютно все возможные вопросы к контексту. Так как сервер вычисляет ответы строго параллельно, добавление дополнительных проверок через Choice или Noul практически не увеличивает время ожидания.
- Retrieve-then-judge: база данных приложения сначала фильтрует миллионы записей классическими алгоритмами поиска или векторного сходства. И только узкая выборка релевантных фактов передаётся в параметр state для финальной интеллектуальной оценки.
Особенно ярко слой микрорешений проявляет себя в сложных автономных конвейерах. Инструмент мгновенно решает, какой внешний API (tool) должен вызвать скрипт, и определяет момент передачи контекста тяжелой генеративной сети. Бизнес-результаты перехода на эту архитектуру весьма показательны: компания Vercel заменила Jev-ом модель GPT Luna и получила результат в несколько раз быстрее.
Для внедрения диспетчеризации обращений в агенте рекомендуется использовать следующий пошаговый гайд:
- Инициализировать клиент и собрать входящие пользовательские данные в единый объект state.
- Сформировать словарь questions, добавив Choice для классификации интента и Noul для флагов безопасности.
- Отправить синхронный пакетный вызов к API TypeSafe.
- Распарсить возвращённые вероятности в локальные переменные программы.
- Сравнить полученный confidence с заданными константами (например, > 0.85).
- При превышении порога — мгновенно выполнить нужную бизнес-функцию из пула инструментов агента.
- При низкой уверенности — направить контекст в классическую LLM для генерации уточняющего вопроса пользователю.
Ограничения Jev и типичные ошибки
Jev не умеет генерировать код и текст, а точность его классификаций падает, если объект state переполнен посторонним мусором, поэтому базовую очистку и математические операции держат строго в кодовых базах. Поскольку Jev вместо текста возвращает структурированное решение с вероятностями и confidence, попытка заставить его пересказывать статьи или программировать приведёт к ошибкам API.
Модель принципиально не ведёт агентные циклы (loops) и не использует инструменты. В отличие от продвинутых генеративных систем, она не хранит историю диалога, не умеет делать поисковые запросы в Google и не будет рекурсивно вызывать сама себя для исправления ошибки. Приложение должно каждый раз отправлять полный самодостаточный контекст, а всю оркестровку разработчик пишет на Python или TypeScript.
Арифметика и работа с датами — задача для стандартных библиотек. Ни одна нейросеть не гарантирует 100% точности в расчётах сложных процентов или вычислении разницы между временными зонами. Никогда не передавайте системе сырые даты с просьбой посчитать количество прошедших дней; считайте это в коде, а ИИ отдавайте готовое число дней для оценки статуса просрочки.
Избыточный нерелевантный контекст разрушает точность (accuracy). Алгоритм читает инструкции буквально и весьма чувствителен к шуму в данных. Чтобы избежать типичных проблем:
- Фильтруйте state от HTML-тегов, системного мусора и логов, не имеющих отношения к задаваемым вопросам.
- Не используйте двойные отрицания при формулировании опций в объекте Choice.
- Избегайте попыток получить суммаризацию через Noul или Score — эти типы данных не предназначены для упаковки смысла, они работают только с вероятностями.