
GPT-6 Astra против Claude Fable 5.1: полное сравнение двух флагманов сентября 2026
GPT-6 Astra от OpenAI и Claude Fable 5.1 от Anthropic вышли с разницей в двое суток — 1 и 3 сентября 2026 — и сразу разделили лидерство между собой. По независимому Artificial Analysis Intelligence Index Fable 5.1 набирает 66 баллов против 61 у Astra, однако в математике, компьютерной автоматизации и стоимости за задачу Astra вырывается вперёд.
Если нужны максимальный интеллект, длинные сессии кодинга и дешёвый кэш — смотрите в сторону Fable 5.1. Если важны математика, computer use и минимальная цена за завершённую задачу — Astra.
Коротко: кто победил и в чём (TL;DR)
Прямого победителя нет — модели лидируют в разных доменах. Claude Fable 5.1 опережает по общей «умности» и агрегированному индексу кодинга. GPT-6 Astra выигрывает в математике, автоматизации рабочих процессов, кибербезопасности и оказывается дешевле за завершённую задачу.
Итоговая таблица
| Категория | GPT-6 Astra | Claude Fable 5.1 | Победитель |
|---|---|---|---|
| Интеллект (AA Index, max effort) | 61 | 66 | Fable 5.1 |
| Математика (FrontierMath Tier 4) | 97,6 % | 87,8 % | Astra |
| Кодинг-агенты (AA Coding Agent Index) | 67 | 70 | Fable 5.1 |
| DeepSWE v1.1 | 74,1 % | 67,4 % | Astra |
| HLE с инструментами | 57,2 % | 65,0 % | Fable 5.1 |
| Computer use (OSWorld 2.0) | 72,6 % | — | Astra |
| Цена за задачу (AA-Index) | ~$1,67 | ~$3,70 | Astra |
| Цена кэша (за 1M токенов) | $1,00 | $0,25 | Fable 5.1 |
Итог: паритет с разным лидерством по доменам. Лучшей «на все случаи» нет.
Что это за модели и когда вышли
В начале сентября 2026 обе компании выпустили очередные флагманские модели с разницей всего в двое суток, подхлестнув гонку возможностей.
GPT-6 Astra — новый флагман OpenAI
Astra выпущен 3 сентября 2026, model id gpt-6-astra, knowledge cutoff — 30 апреля 2026. Официальный анонс OpenAI описывает его как крупнейший тренинговый ран компании: более 100 000 GPU на площадке Stargate в Техасе. Впервые предыдущие модели OpenAI участвовали в надзоре за обучением новой.
Greg Brockman назвал релиз «наступлением эры AGI». По позиционированию Astra — самый выравненный (aligned) продукт компании, с набором ограничений и staged rollout из-за рейтинга Critical по кибербезопасности. GPT-5.6 Sol остаётся доступен как более доступная и быстрая альтернатива. Полный разбор характеристик и бенчмарков — в отдельном обзоре GPT-6 Astra.
«Мы считаем, что GPT-6 Astra является наиболее мощной и выровненной моделью, которую мы когда-либо создавали. Это начало эры AGI.»
Greg Brockman, сооснователь OpenAI
Claude Fable 5.1 — ответ Anthropic
Fable 5.1 выпущен 1 сентября 2026, model id claude-fable-5-1, knowledge cutoff — июнь 2026. По анонсу Anthropic, модель является точечным обновлением Fable 5 (релиз 9 июня 2026) и делает ставку на глубокие рассуждения, длинные агентные сессии кодинга и многошаговый исследовательский воркфлоу. По возможностям Fable 5.1 превосходит и Claude Opus 5. Доступна через общий Claude API без специальных программ доступа. Детальный обзор модели, её цен и ограничений — в материале про Claude Fable 5.1.
Интеллект и рассуждения
По независимой оценке Fable 5.1 умнее — и разрыв виден как в агрегированных, так и в специализированных тестах на рассуждение.
Нейтральный Intelligence Index — за Fable 5.1
На Artificial Analysis Intelligence Index (max effort) Claude Fable 5.1 набирает 66, GPT-6 Astra — 61. Примечательно, что даже в собственной таблице OpenAI Fable 5.1 (65,7 балла) оказывается выше Astra (61,2). В этой же таблице: Claude Opus 5 — 63,1; Fable 5 — 62,1; GPT-5.6 Sol — 60,9.
Humanity’s Last Exam с инструментами — один из наиболее значимых академических тестов — даёт Fable 5.1 результат 65,0 % против 57,2 % у Astra. Это единственный академический ряд, который OpenAI обходит стороной в официальном анонсе.
Математика и наука
В точных науках картина меняется — здесь Astra уверенно опережает.
Здесь лидирует Astra
FrontierMath Tier 4, один из сложнейших математических бенчмарков, GPT-6 Astra проходит на 97,6 %, тогда как Claude Fable 5.1 — на 87,8 %. GPQA Diamond (вопросы уровня PhD по физике, химии, биологии) — 96,0 % против 93,7 %. ARC-AGI-3, тест на абстрактное рассуждение — около 98,6–99,9 %.
Есть оговорка: часть математических бенчмарков OpenAI измеряла против собственного GPT-5.6 Sol, а не в прямой очной ставке с Fable 5.1, что снижает сопоставимость. Независимые воспроизведения нескольких результатов пока ограничены. Что представляет собой этот тест и почему он так труден — в разборе бенчмарка FrontierMath Tier 4.
| Бенчмарк | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| FrontierMath Tier 4 | 97,6 % | 87,8 % |
| GPQA Diamond | 96,0 % | 93,7 % |
| ARC-AGI-3 | ~98,6–99,9 % | н/д |
| HLE с инструментами | 57,2 % | 65,0 % |
Кодинг и агенты
Агрегированный индекс отдаёт первое место Fable 5.1, но на уровне отдельных задач Astra сильнее.
Ничья с нюансами
По агрегированному AA Coding Agent Index Claude Fable 5.1 в связке с Claude Code набирает 70, GPT-6 Astra в Codex — 67. Разрыв небольшой, но стабильный на нескольких прогонах.
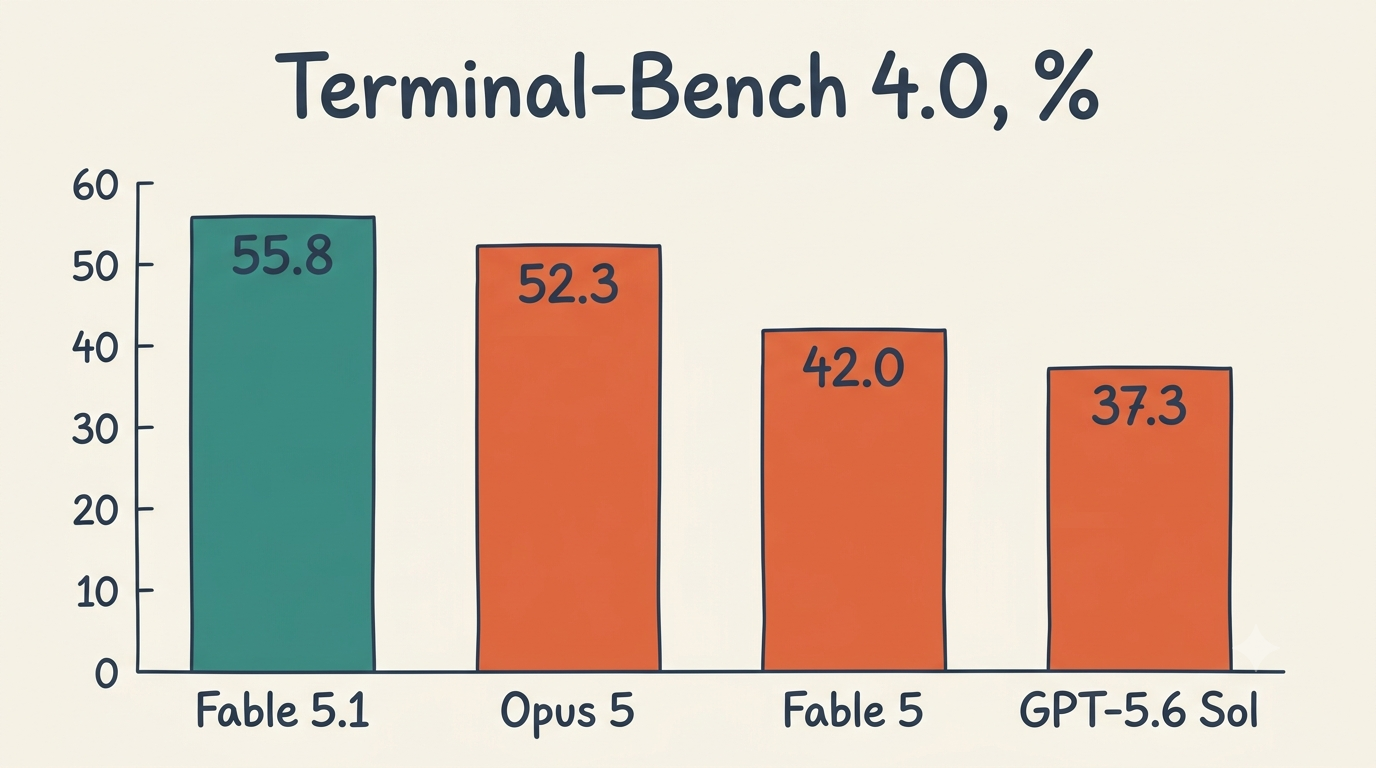
На отдельных «сырых» тестах расклад обратный: DeepSWE v1.1 — 74,1 % против 67,4 %, Terminal-Bench 4.0 — 57,9 % против 55,8 %, Terminal-Bench Science — 64,6 % против 52,6 % — всё в пользу Astra. Длинные интерактивные сессии и рефакторинг крупных кодовых баз — за Fable 5.1; разовые сложные end-to-end задачи и терминальный контроль — за Astra. Как устроены сами тесты и что они измеряют — в отдельном материале про DeepSWE и Terminal-Bench.
Как сравнить модели в кодинге на практике:
- Определите тип задачи: короткие скрипты, большой рефакторинг или автономный агент.
- Запустите DeepSWE-подобный тест на реальных репозиториях своей команды.
- Замерьте не только accuracy, но и latency p50/p95 и число API-вызовов за задачу.
- Посчитайте total cost per accepted task — стоимость одного принятого в продакшн изменения.
- Повторите тест через неделю: модели обновляются, результаты меняются.
Computer use и автоматизация
Здесь Astra заметно сильнее — особенно в задачах, где ИИ управляет интерфейсами и выполняет рабочие процессы за пользователя. OSWorld 2.0 фиксирует 72,6 % и на ~47 % меньше времени по сравнению с предыдущим GPT-5.6 Sol. ScreenSpot-Pro, тест на точность клика по экрану, — 92,7 %. AutomationBench — 41,4 % против 31,4 % у Fable 5.1. BenchCAD (инженерное САПР-взаимодействие) — 95,9 % против 84,3 %.
Async-вызовы инструментов и mid-turn steering — два архитектурных акцента Astra, которые дают ему дополнительное преимущество в многошаговых UI-агентах. Fable 5.1 здесь не имеет официальных сопоставимых цифр.
Кибербезопасность и безопасность
Astra — первый релиз в истории OpenAI, получивший рейтинг Critical по кибербезопасности согласно Preparedness Framework. Именно поэтому выход сопровождается staged rollout через программу Trusted Access.
На ExploitBench Astra достигает 100 % и в ходе тестирования нашёл 2 ранее неизвестных zero-day-уязвимости. SRE-Bench — 88,0 % против 12,5 % у Claude Opus 5. По галлюцинациям (AA-Omniscience) Astra заметно надёжнее предыдущего Sol.
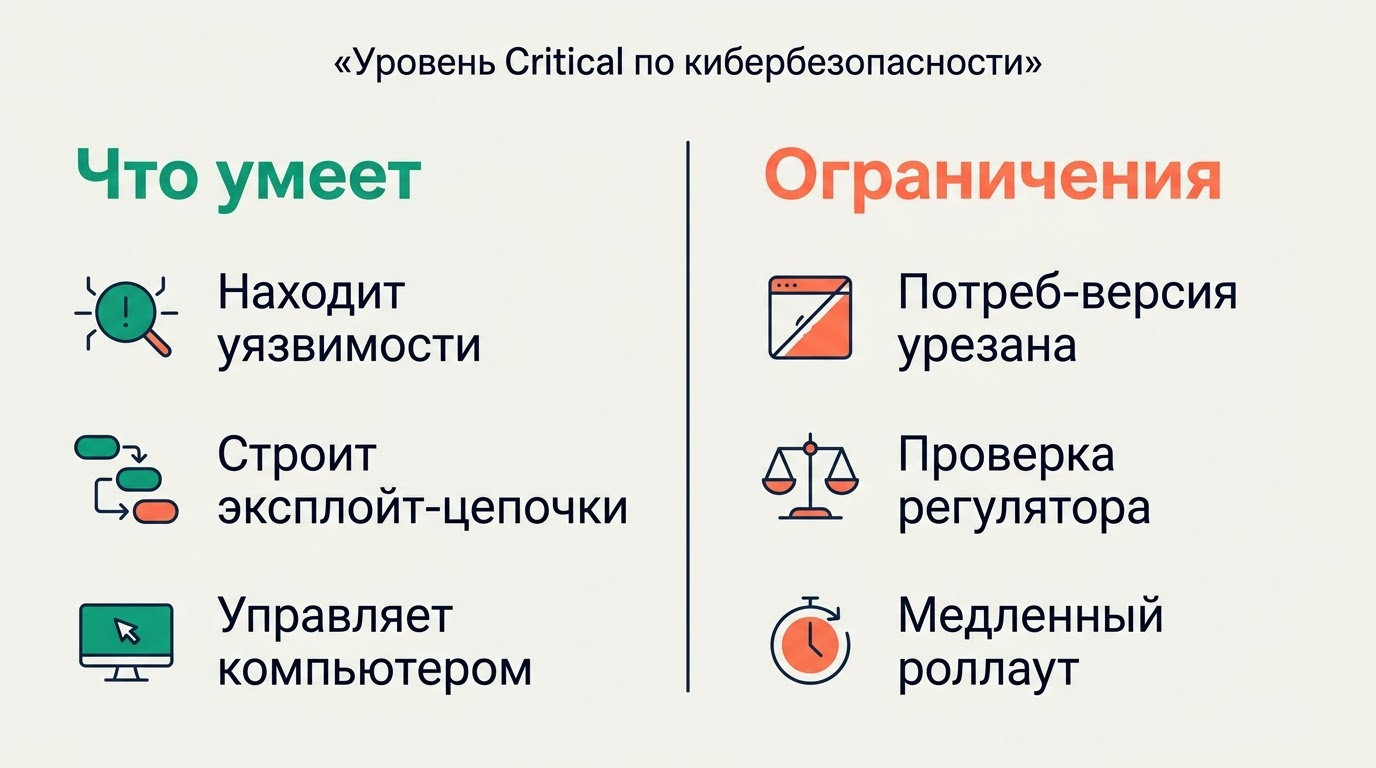
Оговорку делают независимые аналитики: часть критиков указывает на конфликт интересов при финансировании отдельных бенчмарков. Кибервозможности Astra реальны, но ряд цифр требует независимого воспроизведения.
Цены, кэш и контекст
Базовый ценник у обеих моделей одинаков, однако экономика использования различается существенно.
Ценник одинаковый, экономика разная
Обе модели стоят $10 за 1M входных и $50 за 1M выходных токенов. Но кэш у Claude Fable 5.1 в четыре раза дешевле — $0,25/1M против $1,00/1M у Astra. Это важно при повторных промптах и длинных разговорных сессиях.
| Параметр | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Вход (1M токенов) | $10 | $10 |
| Выход (1M токенов) | $50 | $50 |
| Кэш (1M токенов) | $1,00 | $0,25 |
| Blended (AA-Index) | $7,70 | $7,17 |
| Цена за задачу (AA) | ~$1,67 | ~$3,70 |
| Контекст вход/выход | 1,05M / 128K | 1M / 128K |
| Long-context биллинг | >272K: 2x вход / 1,5x выход | нет |
Практический итог: при задачах с большим объёмом повторяемых промптов Fable 5.1 дешевле за счёт кэша. При разовых сложных задачах Astra тратит меньше токенов на «мышление» и завершает работу примерно в 2,2 раза дешевле по факту.
Какую модель выбрать
Выбор зависит от сценария использования — универсального ответа нет.
Под задачу
- Исследования, рассуждения, длинные диалоги — Claude Fable 5.1: выше общий интеллект-индекс, лучше Humanity’s Last Exam.
- Математика и точные науки — GPT-6 Astra: +10 п.п. на FrontierMath Tier 4, уверенный GPQA Diamond.
- Длинные агентные сессии кодинга — Claude Fable 5.1 + Claude Code: агрегированный Coding Agent Index выше.
- Одиночные end-to-end задачи и терминал — GPT-6 Astra + Codex: DeepSWE и Terminal-Bench за Astra.
- Автоматизация UI / computer use — GPT-6 Astra: доминирует на всех компьютерных бенчмарках.
- Повторяемые сессии с кэшем — Claude Fable 5.1: кэш в 4 раза дешевле.
- Минимальная цена за задачу — GPT-6 Astra: ~$1,67 против ~$3,70.
Практический совет: сравнивайте модели не по одному бенчмарку или базовому ценнику, а по total cost per accepted task и latency p50/p95 на собственных данных и воркфлоу.
FAQ
Ниже — ответы на самые частые вопросы о GPT-6 Astra и Claude Fable 5.1.