
DeepSWE и Terminal-Bench: GPT-6 Astra против Claude Fable 5.1 в агентном кодинге
DeepSWE v1.1 и Terminal-Bench — главные агентные бенчмарки кодинга 2026 года. В полном сравнении GPT-6 Astra vs Fable 5.1 Astra опережает Fable 5.1 в обоих тестах, но агрегированный Coding Agent Index даёт почти ничью.
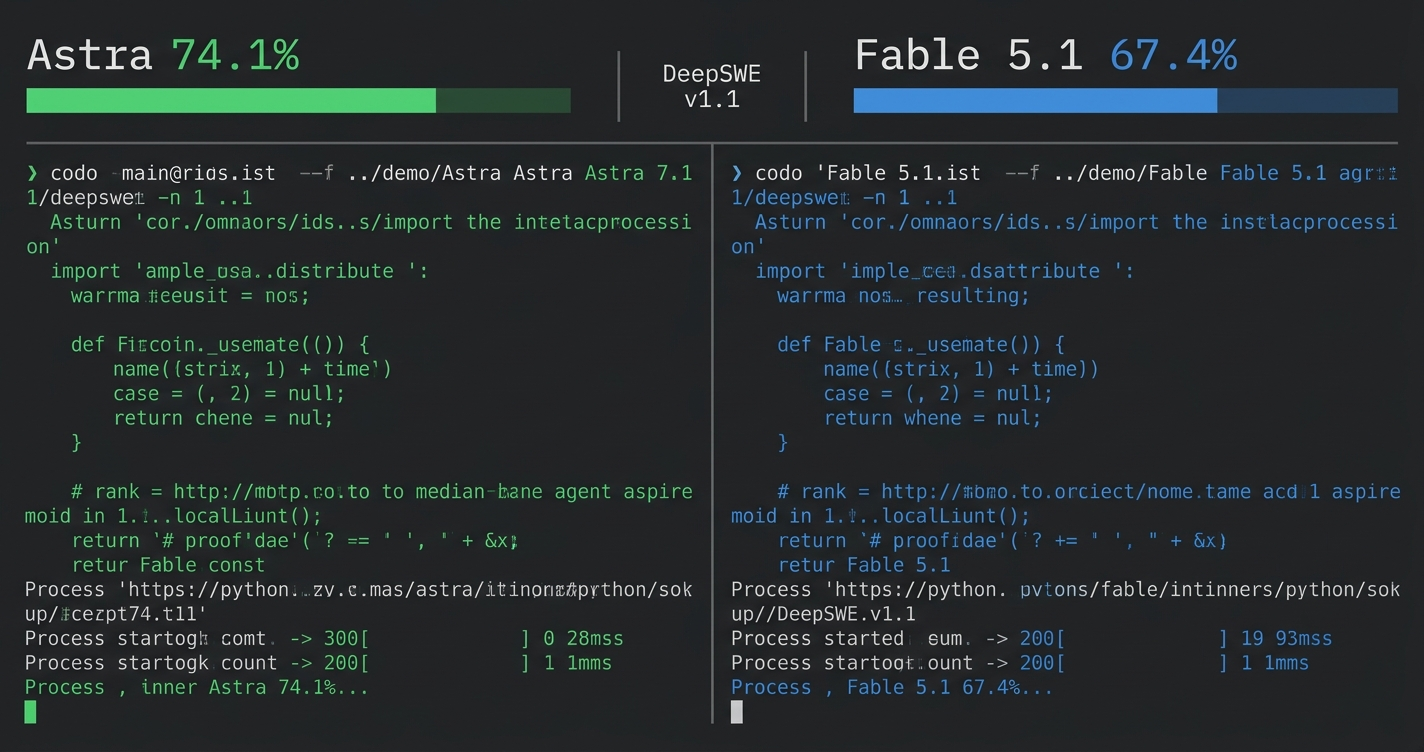
DeepSWE v1.1: реальные GitHub-задачи
DeepSWE — агентный тест: модель получает настоящий GitHub-issue и должна решить его от начала до конца без подсказок. Результаты:
| Модель | DeepSWE v1.1 |
|---|---|
| GPT-6 Astra | 74.1% |
| Claude Fable 5 | 69.9% |
| Claude Opus 5 | 68.8% |
| Claude Fable 5.1 | 67.4% |
GPT-6 Astra лидирует с 74.1%. Fable 5.1 показал 67.4% — ниже даже предыдущей версии Fable 5 (69.9%) и Claude Opus 5 (68.8%).
Terminal-Bench измеряет не «знает ли модель код», а «умеет ли агент работать в реальной среде»: файлы, сеть, компилятор, CI/CD — всё как на настоящем рабочем месте.
tbench.ai — авторы Terminal-Bench
Terminal-Bench: агент в терминале
Terminal-Bench от tbench.ai измеряет агентную работу в настоящей командной строке — файловая система, компиляторы, сеть, CI/CD. Задача решается в реальной среде, не в песочнице.
Результаты в Terminal-Bench 4.0 и Science
| Бенчмарк | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Terminal-Bench 4.0 | 57.9% | 55.8% |
| Terminal-Bench Science | 64.6% | 52.6% |
В Terminal-Bench 4.0 разрыв небольшой (57.9% против 55.8%). В Terminal-Bench Science — наукоёмкие задачи — 12 процентных пунктов в пользу Astra (64.6% против 52.6%).
AA Coding Agent Index: агрегат разворачивает счёт
Агрегированный Coding Agent Index от Artificial Analysis объединяет множество бенчмарков. Итог неожиданный:
- Claude Fable 5.1 в Claude Code — 70 баллов
- GPT-6 Astra в Codex — 67 баллов
Разрыв всего 3 балла. Artificial Analysis учитывает длинные агентные сессии, где Fable 5.1 стабильнее. По данным Anthropic о Claude Fable 5.1, модель оптимизирована под многошаговые задачи в Claude Code. Подробнее о сильных сторонах каждой модели — в обзорах GPT-6 Astra и Claude Fable 5.1.
Как читать эти данные:
- Разовая сложная задача → смотрите DeepSWE (Astra 74.1% vs Fable 67.4%).
- Терминальная автоматизация → Terminal-Bench Science (Astra 64.6% vs Fable 52.6%).
- Длинная интерактивная сессия → AA Coding Agent Index (Fable 70 vs Astra 67).
- Продуктовые различия важны: Astra мерился в Codex, Fable 5.1 — в Claude Code.
- Итоговый совет от OpenAI: мерьте cost-per-accepted-task на своих задачах, не только по бенчмаркам. Методологию агрегированных рейтингов публикует Epoch AI.
Какую модель выбрать
GPT-6 Astra — для разовых end-to-end задач, терминальной автоматизации и наукоёмких DevOps-сценариев.
Claude Fable 5.1 — для длинных итеративных сессий в Claude Code, где важно удерживать контекст часами.