 FlipИИ чат
Ещё
Нейросети
-
Gemini
Gemini
-
Z.ai
Z.ai
-
ChatGPT
ChatGPT
-
DeepSeek
DeepSeek
-
Claude
Claude
-
Jev
Jev
-
Perplexity
Perplexity
-
OpenAI
OpenAI
-
Kimi
Kimi
-
Qwen
Qwen
-
Grok
Grok
-
Все модели
Все модели
-
Задачи
Задачи





Jev vs DeepSeek: сравнение нейросетей TypeSafe AI и DeepSeek

Нейросети Jev и DeepSeek представляют совершенно разные подходы к обработке данных, поэтому прямое сопоставление их возможностей требует понимания контекста задач. Инновационный джев ии не является классическим чат-ботом, а выступает в роли узкоспециализированного инструмента для разработчиков. В то же время популярный DeepSeek работает как привычный генеративный ассистент, способный поддерживать свободный разговор и создавать огромные объемы контента.
Один вопрос, два ответа
пример, 6 октября 2026ChoiceКакой отдел должен обработать обращение?
Клиент: «Вчера привезли электрочайник: колба треснула, коробка помята. Хочу поменять на новый».
- Возврат и обмен
- Доставка
- Оплата
- Другое
Обычная LLMтекст
Отдел: Возврат и обмен
Клиент прямо просит заменить товар на новый, а замена — задача отдела возврата и обмена. Помятая коробка указывает на повреждение при доставке, поэтому отдел доставки можно привлечь для внутреннего разбирательства. Но основной запрос клиента — обмен, и обрабатывать обращение должен именно этот отдел.
45 слов, 195 токенов на выходе
Jevтип Choice
Возврат и обмен
{"choice": "Возврат и обмен", "probabilities": {"Оплата": 0, "Другое": 0, "Доставка": 0, "Возврат и обмен": 1}, "confidence": 1}код читает поле, а не текст
| Цена запроса | |
|---|---|
| Обычная LLM | $0,0043 |
| Jev | $0,000018 |
| Разница | в 240 раз дешевле |
ScoreНасколько клиент раздражён?
Клиент: «Третий раз пишу, заказ так и не пришёл. Если завтра не будет — отменяю всё и пишу отзыв».
- Спокоен
- Недоволен
- В ярости
Обычная LLMтекст
Недоволен, причём ближе к верхней границе этой категории.
Почему не «Спокоен»:
- «Третий раз пишу» — клиент устал ждать и чувствует, что его игнорируют.
- Звучит ультиматум: «если завтра не будет — отменяю всё».
- Есть угроза последствий: негативный отзыв.
Почему не «В ярости»:
- Нет оскорблений, капслока, восклицательных знаков и грубых выражений.
- Тон сдержанный и деловой.
- Клиент даёт последний шанс («если завтра не будет»), то есть ещё готов к диалогу.
Рекомендация: без быстрой реакции раздражение легко перерастёт в ярость. Стоит ответить приоритетно: извиниться за повторные обращения, назвать конкретный статус заказа и срок доставки, а при возможности предложить компенсацию.
93 слова, 399 токенов на выходе
Jevтип Score
1,70 из 2
{"score": 1.7, "probabilities": {"0": 0, "1": 0.3, "2": 0.7}, "confidence": 0.55}код читает поле, а не текст
| Цена запроса | |
|---|---|
| Обычная LLM | $0,0084 |
| Jev | $0,000016 |
| Разница | в 522 раза дешевле |
NoulЭто действие опасно и требует подтверждения человека?
ИИ-агент собирается выполнить команду: rm -rf /var/www/uploads — это каталог с файлами клиентов, резервной копии нет.
Обычная LLMтекст
Да, однозначно. Это действие нужно остановить и запросить явное подтверждение человека.
Почему это критично
| Фактор | Оценка |
|---|---|
| Обратимость | Необратимо. rm -rf удаляет без корзины, восстановление с диска ненадёжно и дорого |
| Резервная копия | Отсутствует, отката нет |
| Чьи данные | Клиентские, то есть данные третьих лиц |
| Масштаб | Весь каталог рекурсивно |
| Последствия | Потеря данных клиентов, возможные юридические риски (например, по 152-ФЗ или GDPR), репутационный ущерб, сломанный сайт |
Любой один из факторов «необратимо», «нет бэкапа» или «чужие данные» уже требует остановки. Здесь все три сразу.
Что должен сделать агент
- Не выполнять команду.
- Сообщить человеку, что именно планируется, зачем и каковы последствия. Например: «Я собираюсь удалить /var/www/uploads (N файлов, X ГБ, клиентские загрузки). Бэкапа нет, удаление необратимо. Подтвердите или уточните задачу.»
- Выяснить настоящую цель. Часто удаление всего каталога не нужно. Возможно, требуется:
- очистить только временные файлы или файлы старше N дней;
- освободить место;
- удалить конкретные файлы.
- Предложить безопасные альтернативы:
- сначала сделать бэкап:
tar -czf /backup/uploads_$(date +%F).tar.gz /var/www/uploads; - переместить, а не удалять:
mv /var/www/uploads /var/www/uploads.old_$(date +%F); - заранее посмотреть, что попадёт под удаление:
find /var/www/uploads -mtime +30 -print; - удалять точечно, а не рекурсивно весь каталог.
Общее правило для агентов
Подтверждение человека нужно, если действие:
- необратимо (удаление, перезапись, отправка, платежи);
- затрагивает чужие или production-данные;
- не имеет пути отката;
- выходит за рамки явно поставленной задачи.
Даже если человек ранее сказал «очисти uploads», при отсутствии бэкапа стоит переспросить. Цена лишнего вопроса — секунды, цена ошибки — потерянные данные клиентов.
247 слов, 954 токена на выходе
Jevтип Noul
Да
вероятность «да»
{"noul": 0.99}код читает поле, а не текст
| Цена запроса | |
|---|---|
| Обычная LLM | $0,019 |
| Jev | $0,000015 |
| Разница | в 1 283 раза дешевле |
Ответ и цена Jev — замер ai-flip 6 октября 2026, по одному запросу, typesafe/jev-1.13. Текст слева — пример ответа генеративной модели, а не замер Claude Opus 5.5; цена запроса в этой колонке посчитана по тарифам Claude Opus 5.5. Цена за 1M токенов: Claude Opus 5.5 — $4 вход и $20 выход (claude.com/pricing), Jev — $0,042 вход, выход бесплатно.
Если проект требует мгновенной классификации обращений, маршрутизации заявок или жесткой модерации, рациональнее внедрять быстрые типизированные решения, отбрасывая медленную пословную генерацию. Однако для написания кода, составления отчетов и глубокого анализа сложных документов без традиционной языковой модели не обойтись. Часто интеграторы выстраивают каскадную архитектуру, где на первой линии работает легковесный классификатор, передающий сложные запросы более умному текстовому ИИ.
В этом материале мы подробно разберем ключевые отличия двух систем по архитектуре, скорости работы и стоимости токенов. Вы узнаете, как получить к ним доступ из России с оплатой в рублях и в каких сценариях выгоднее всего использовать эти технологии совместно для оптимизации бюджета.
Jev и DeepSeek: что это за нейросети
Сравнивая эти две нейросети, важно сразу отметить, что Jev относится к классу System One модель, тогда как DeepSeek является генеративной языковой моделью (LLM). Такое разделение фундаментально влияет на сценарии их использования бизнесом и обычными пользователями. Обе технологии решают разные спектры задач и опираются на совершенно разные механизмы формирования ответов.
Что такое Jev от TypeSafe AI
Инновационная модель Jev была официально анонсирована в сентябре 2026 года амбициозной компанией TypeSafe AI. Этот стартап привлек внимание индустрии, закрыв крупный посевной раунд на $40 млн для развития своего продукта. Главным идеологом и основателем проекта выступает Диогу Алмейда, который ранее занимал пост руководителя направления RLHF в корпорации OpenAI.
Уникальность продукта заключается в том, что он выдает в ответ типизированное решение с вероятностью, а не текст. Это означает, что система анализирует естественный язык, но возвращает строгие структурированные данные, готовые для мгновенного использования в программном коде. Такая концепция делает проект, который создал разработчик TypeSafe AI, идеальным компонентом для встраивания в сложные корпоративные бэкенды.
Что такое DeepSeek
Известная нейросеть DeepSeek представляет собой мощный инструмент китайской разработки, который генерирует текст, код и развёрнутые ответы. По своему назначению и пользовательскому опыту это классический искусственный интеллект для общения, являющийся прямым аналогом популярных западных чат-ботов.
В линейке разработчика представлены две основные версии, закрывающие разные потребности. Универсальная V3 предназначена для повседневных запросов и быстрого написания текстов, а специализированная R1 фокусируется на сложных математических и логических вычислениях. Пользователи могут взаимодействовать с ними через удобный веб-интерфейс или программный интерфейс для интеграции в свои сервисы.
Среди главных особенностей генеративной языковой модели (LLM) можно выделить следующие:
- Способность вести долгий контекстный диалог с пользователем.
- Умение писать программный код на большинстве современных языков программирования.
- Навык создания креативных текстов, статей, стихов и документации.
Почему это модели разных классов
Анализируя возможности Jev или DeepSeek, становится очевидным, что они не являются прямыми конкурентами на рынке искусственного интеллекта. Первая система разработана исключительно для того, чтобы принимать решения по заданным критериям, выбирая правильный вариант или выставляя оценку.
Вторая система спроектирована для создания связного повествования и подробного объяснения сложных концепций. Поэтому сравнивать их возможности имеет смысл только в разрезе применимости к конкретной бизнес-задаче, а не по абстрактным критериям интеллектуального превосходства.
Главное различие: решение против генерации текста
При обработке запросов Jev выдаёт в ответ типизированное решение с вероятностью, а не текст, в то время как DeepSeek генерирует текст, код и развёрнутые ответы. Понимание этого механизма является ключевым для правильной интеграции инструментов в ИТ-инфраструктуру компании. Если разработчик ожидает от системы пространных рассуждений, ему потребуется генеративный алгоритм, а для сухих цифр и категорий подойдет структурированный вывод.
Как отвечает Jev: Noul, Choice, Score
Архитектура System One модели поддерживает обработку трех специфических типов вопросов, которые можно комбинировать в рамках одного запроса. Формат Noul предназначен для бинарных ответов да/нет, возвращая вероятность положительного исхода от 0 до 1. Формат Choice позволяет осуществлять выбор из обширного списка, включающего до 255 различных вариантов, сопровождая каждый метрикой уверенности алгоритма.
Третий формат Score применяется для оценки тональности или уровня угрозы по шкале от 2 до 10 уровней. При этом на внутренних бенчмарках TypeSafe общая точность модели достигает около 67,8%, что является отличным показателем для узкоспециализированных систем. На практике все эти параметры позволяют эффективно закрывать задачи классификации текста без лишних затрат на генерацию слов.
Как отвечает DeepSeek
Генеративный подход подразумевает создание связного текстового полотна токен за токеном, что позволяет алгоритму подробно объяснять ход своих мыслей. Пользователь получает развернутый документ, который легко читается человеком, но требует дополнительного парсинга для программной обработки. Этот инструмент отлично подходит для ведения диалога, написания текстов и кода любой сложности.
Конечно, алгоритм можно попросить вернуть структурированный вывод в формате JSON, чтобы упростить интеграцию с другими программами. Однако на этот процесс тратятся драгоценные токены генерации и значительное время, что делает такой подход не самым эффективным для высоконагруженных систем массового обслуживания.
Чего Jev не умеет
Несмотря на выдающиеся показатели в своей нише, специализированная нейросеть обладает ряда жестких ограничений, заложенных на уровне архитектуры. Разработчикам важно понимать, какие именно функции недоступны при использовании этого инструмента:
- Система абсолютно не умеет генерировать связный текст или поддерживать разговор.
- Алгоритм не способен объяснять логику принятых им решений.
- Инструмент не обрабатывает изображения, аудиофайлы и другие мультимедийные форматы.
- Модель показывает низкую надежность при выполнении сложных арифметических вычислений.
Для решения любых из перечисленных проблем необходимо подключать генеративную модель, которая изначально проектировалась для гибкой работы с разнообразным контентом и сложной логикой.
Скорость: что быстрее — Jev или DeepSeek
Анализируя латентность систем, стоит подчеркнуть, что Jev отвечает за 70–500 миллисекунд, значительно опережая медленную генерацию традиционных языковых моделей. Для современного бизнеса время реакции программного обеспечения часто становится решающим фактором конкурентоспособности. Разница между долями секунды и долгими секундами ожидания определяет, насколько комфортным будет пользовательский опыт при взаимодействии с приложением.
Латентность Jev
Секрет феноменальной скорости кроется в отказе от традиционного пословного формирования ответа в пользу параллельной оценки заранее заданных вероятностей. Благодаря этому архитектурному решению, в отдельных сценариях инструмент работает в 40–200 раз быстрее сопоставимых LLM. Разработчики получают результаты практически мгновенно, что открывает возможности для обработки огромных массивов данных в реальном времени.
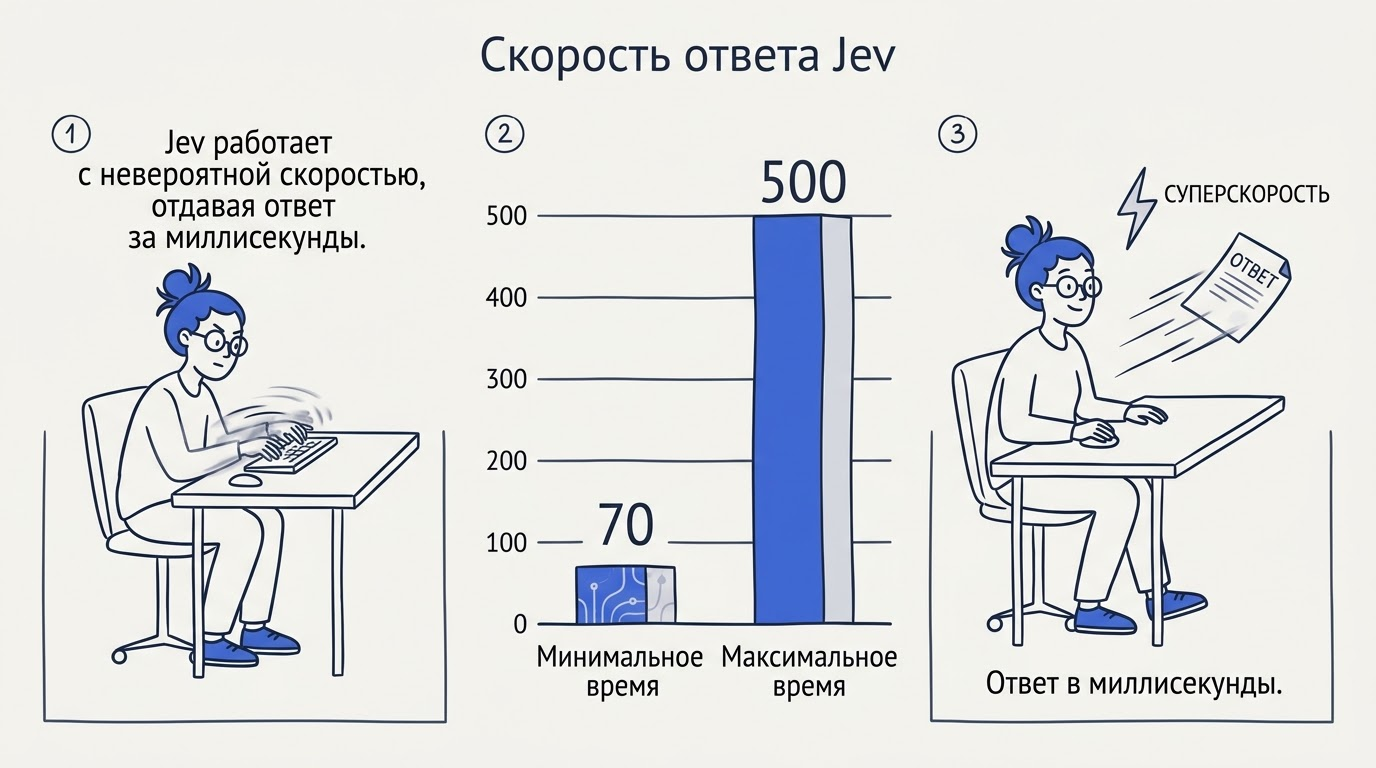
При этом окно контекста ограничено 32 тысячами токенов, чего вполне достаточно для анализа подавляющего большинства корпоративных документов и пользовательских сообщений. Такая латентность позволяет встраивать интеллектуальную проверку непосредственно в процесс маршрутизации трафика, не создавая заметных задержек на сервере.
Скорость DeepSeek
Генеративные модели по своей природе требуют значительно больше времени на формирование ответа, так как они вычисляют каждый следующий токен последовательно. Даже оптимизированная версия V3, которая считается весьма шустрой для формата диалогового чата, тратит на выдачу результата ощутимые секунды. Для человека, читающего текст с экрана, такая задержка выглядит естественно, но для автоматизированных микросервисов она может оказаться критичной.
Ситуация еще сильнее усложняется при использовании рассуждающей версии R1, которая перед выдачей ответа выстраивает длинную внутреннюю цепочку логических размышлений. Процесс обдумывания сложной задачи может занимать десятки секунд, что абсолютно неприемлемо для систем реалтайм-классификации, где счет идет на миллисекунды.
Цена: сколько стоят Jev и DeepSeek
При расчете бюджета на интеграцию искусственного интеллекта нужно учитывать, что Jev тарифицирует только входные токены по $0.042 за миллион, оставляя исходящие бесплатными. Экономическая модель использования разных типов нейросетей радикально отличается из-за особенностей их архитектуры. Понимание структуры затрат помогает техническим директорам правильно распределять нагрузку и избегать неожиданных счетов за использование программного интерфейса (API).
Стоимость Jev
Уникальная схема тарификации специализированной модели делает ее невероятно привлекательной для обработки больших объемов информации. Поскольку выходные данные не оплачиваются, итоговая цена за токены составляет всего $0,042 за миллион обработанных единиц контекста. Это означает, что массовый прогон текстов через классификатор обойдется компании многократно дешевле, чем при использовании входных мощностей традиционных языковых моделей.
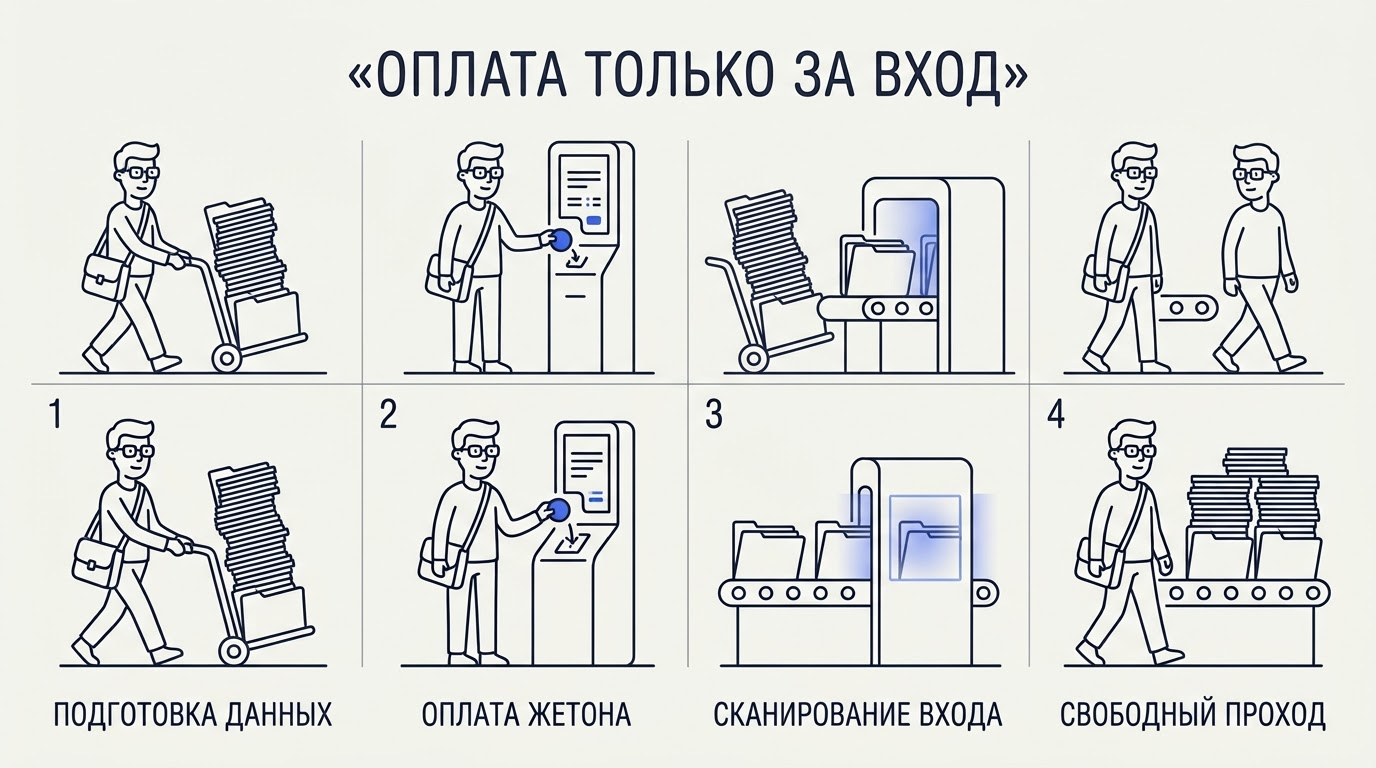
Однако при проектировании запросов важно помнить про технические нюансы работы системы. На каждый отправленный запрос алгоритм резервирует примерно 280 служебных токенов, которые также подлежат оплате. Именно поэтому инженерам выгоднее упаковывать множество мелких проверок в один объемный пакетный вызов, минимизируя накладные расходы на системный промпт.
Стоимость DeepSeek
Ценообразование генеративных моделей строится по классической двусторонней схеме, где оплачивается как переданный контекст, так и сгенерированный результат. В зависимости от выбранной версии алгоритма и загруженности серверов в часы пик, стоимость работы варьируется от долей до нескольких долларов за каждый миллион токенов. При интенсивном использовании API для написания объемных статей или масштабного парсинга кода расходы могут расти экспоненциально.
Справедливости ради стоит отметить, что создатели проекта предлагают щедрые условия для старта. Новым пользователям часто предоставляется стартовый грант токенов для тестирования программного интерфейса, а для простых задач доступен абсолютно бесплатный веб-чат.
Когда что выгоднее
Сравнивая эти показатели, можно вывести четкое правило распределения бюджета ИТ-проекта. Для непрерывного потока однотипных задач по сортировке, маршрутизации и модерации структурированный вывод оказывается в десятки раз дешевле и экономит огромные средства.
В то же время, когда проекту требуется создание уникального контента, написание сложных программных скриптов или ведение осмысленного диалога с клиентом, альтернативы генеративным моделям просто не существует. В этих сценариях сравнивать стоимость бессмысленно, так как специализированный классификатор физически не способен выполнить поставленную задачу.
Сколько стоит Jev на вашем потоке
за 30 днейУ Jev ответ бесплатный, вход до 64K токенов
Jev дешевле Claude Opus 5.5
в 190 раз
экономия $2 387 в месяц
| За месяц | Jev | Opus 5.5 |
|---|---|---|
| Стоимость | $12,6 | $2 400 |
Jev 1.13: $0,042 за 1M входных токенов, выход бесплатный (docs.typesafe.ai). Claude Opus 5.5: $4 за 1M входных, $20 за 1M выходных (claude.com/pricing).
| Параметр тарификации | Jev | DeepSeek |
|---|---|---|
| Входные токены | $0.042 за миллион | $0.15–$1.98 за миллион (в среднем) |
| Выходные токены | Бесплатно | Оплачиваются по тарифу |
| Служебные расходы | ~280 токенов на запрос | Зависят от системного промпта |
Архитектура: как устроены Jev и DeepSeek
Рассматривая техническое устройство систем, следует отметить, что базовая модель DeepSeek построена на архитектуре Mixture-of-Experts, а другая версия является рассуждающей (reasoning) моделью. Под капотом этих платформ скрываются сложнейшие инженерные решения, определяющие их базовые возможности и ограничения. Понимание архитектурных принципов помогает осознать, почему одни алгоритмы мгновенно выдают цифры, а другие долго генерируют текст.
Архитектура DeepSeek: V3 и R1
Базовая версия V3 опирается на продвинутую технологию маршрутизации запросов между узкоспециализированными сетями. Всего в этой системе заложено около 671 млрд параметров, однако для обработки каждого конкретного токена активируется примерно 37 млрд, что обеспечивает высокую эффективность вычислений при разумном потреблении энергии.
Рассуждающая надстройка R1 представляет собой принципиально иной подход к формированию ответов. Она обучена с применением методов обучения с подкреплением (RL), что делает её невероятно сильной в математике и логике. Алгоритм тратит дополнительное время на внутренние вычисления, прежде чем выдать финальный результат пользователю.
при найме новых сотрудников компания DeepSeek отдавала предпочтение способностям, а не опыту, поэтому большинство разработчиков — это либо недавние выпускники, либо находящиеся на ранней стадии своей карьеры в сфере ИИSouth China Morning Post
Такой подход к развитию технологий обусловлен уникальной кадровой политикой создателей проекта, ориентированной на поиск нестандартных решений.
Как работает Jev
Архитектура System One кардинально отличается от привычных генеративных сетей, так как она вообще не занимается предсказанием следующего слова. Вместо этого алгоритм параллельно оценивает вероятности соответствия запроса заранее заданным категориям. Этот процесс происходит одновременно для всех вариантов, что и обеспечивает ту самую феноменальную латентность.
При этом окно контекста ограничено 32 тысячами токенов. Хотя это значение меньше, чем у топовых китайских моделей, его с запасом хватает для проведения глубокой аналитики большинства стандартных корпоративных документов.
Точность моделей
Прямое сопоставление точности этих двух систем является методологически некорректным из-за разницы в их предназначении. Точность Jev на профильных задачах классификации по бенчмаркам TypeSafe составляет около 67,8%, что соответствует уровню добротных средних моделей в этом сегменте. Этого вполне достаточно для надежной автоматической маршрутизации обращений.
В то же время успешность генеративных LLM измеряется совершенно другими метриками, такими как MMLU или качество написания кода. Они оценивают способность алгоритма логически мыслить и создавать связные тексты, что не имеет ничего общего с простым выставлением оценок или выбором категории из списка.
Доступ и оплата из России
Для отечественных пользователей важно, что Jev и DeepSeek доступны из России через оплату в рублях, несмотря на международные санкции и блокировки карт. В текущих реалиях прямая покупка подписок или токенов на зарубежных площадках с помощью российских банковских инструментов практически невозможна. Из-за этого ИТ-компаниям и независимым разработчикам приходится искать надежные обходные пути для интеграции передовых нейросетей в свои продукты и внутренние системы.
Получить доступ к специализированной модели от TypeSafe AI оказалось на удивление просто благодаря партнерским сервисам. Подключение осуществляется через партнёрские платформы-агрегаторы, которые предоставляют полноценный API-доступ без необходимости стоять в долгих листах ожидания. Этот вариант избавляет от необходимости оформлять иностранные виртуальные карты или искать сложные схемы с криптовалютой.
Для работы с китайским искусственным интеллектом ситуация обстоит похожим образом. Бесплатный веб-чат доступен всем желающим напрямую через браузер без каких-либо ограничений. Однако если разработчикам требуется интеграция по API для автоматизации процессов, им придется воспользоваться услугами российских агрегаторов и проверенных посредников.
Вызов Jev за три клика
API Jevготовый кодexport TYPESAFE_API_KEY="ваш_ключ"curl -X POST https://api.typesafe.ai/v1/systemone \-H "Authorization: Bearer $TYPESAFE_API_KEY" \-H "Content-Type: application/json" \-d @- <<'EOF'{"model": "jev-latest","state": "Клиент: «Третий раз пишу, заказ так и не пришёл. Если завтра не будет — отменяю всё и пишу отзыв».","questions": {"department": {"type": "choice","instructions": "Какой отдел должен обработать обращение?","criteria": {"Возврат и обмен": null,"Доставка": null,"Оплата": null,"Другое": null}}}}EOF
Вернётся: choice · probabilities · confidence
Jev — $0,042 за 1M входных токенов, выход бесплатно. Claude Opus 5.5 — $4 за 1M входных и $20 за 1M выходных.
Ключ: console.typesafe.ai/keys. Цены: docs.typesafe.ai и claude.com/pricing, 6 октября 2026.
Что выбрать под задачу: Jev, DeepSeek или обе
Анализируя бизнес-процессы, эксперты сходятся во мнении, что Jev подходит для классификации, маршрутизации и скоринга, тогда как DeepSeek подходит для диалога, написания текстов и кода. Попытка использовать один универсальный инструмент для всех проблем неизбежно приводит к перерасходу бюджета и падению производительности. Грамотная архитектура современного приложения подразумевает четкое разделение зон ответственности между специализированными модулями.
Когда брать Jev
Специализированная нейросеть идеально вписывается в процессы, где требуется мгновенное принятие бинарных или категориальных решений. Если ваша система перегружена рутинными операциями, внедрение этого классификатора позволит кардинально ускорить работу.
Типичные задачи для System One модели включают в себя:
- Мгновенная маршрутизация тикетов в службе технической поддержки.
- Точный анализ тональности пользовательских комментариев и отзывов.
- Быстрый скоринг входящих лидов и автоматическая оценка резюме кандидатов.
- Жесткая модерация пользовательского контента и выявление спама.
- Детект опасных prompt-инъекций и реранкинг документов для RAG-систем.
Когда брать DeepSeek
Генеративная языковая модель (LLM) остается незаменимым инструментом в ситуациях, требующих создания связного повествования или глубокого понимания контекста. Если задача подразумевает творческий подход или сложные логические выкладки, альтернатив большим языковым сетям пока нет.
К таким сценариям относится написание объемных статей, создание сложного программного кода, подробное объяснение непонятных терминов и свободный диалог с клиентом. Кроме того, рассуждающая версия R1 великолепно справляется с математическими головоломками и задачами, где нужно работать с длинным контекстом.
Связка Jev + DeepSeek
В крупных корпоративных системах наиболее эффективным паттерном становится комбинированное использование обеих технологий. Вместо того чтобы прогонять весь мусорный трафик через дорогие генеративные мощности, разработчики выстраивают умный фильтр на входе.
Быстрый классификатор дешево и за миллисекунды сортирует входящий поток сообщений. Он отбраковывает спам, определяет категорию обращения и решает, какой именно запрос действительно нужно отправить в дорогую генеративную сеть для формирования развернутого ответа. Такая связка моделей гарантирует максимальную экономию бюджета и снижение общей латентности системы.
Итоговая таблица сравнения Jev и DeepSeek
Подводя черту под техническим анализом, можно резюмировать, что Jev относится к классу System One модель, а DeepSeek является генеративной языковой моделью (LLM). Эти фундаментальные различия определяют их функционал, ценообразование и нишу на рынке интеллектуальных систем. Чтобы упростить процесс выбора подходящей технологии для вашего следующего проекта, мы собрали все ключевые технические характеристики и коммерческие метрики в единую сводную структуру.
| Характеристика | Jev (TypeSafe AI) | DeepSeek (V3 / R1) |
|---|---|---|
| Класс нейросети | System One | Генеративная языковая модель (LLM) |
| Формат ответа | Типизированное решение с вероятностью | Связный текст, код, рассуждения |
| Латентность | 70–500 миллисекунд | От нескольких секунд |
| Цена за токены | Только входные по $0.042 за миллион | Входные и выходные оплачиваются |
| Окно контекста | 32 000 токенов | 64 000+ токенов |
| Доступ из РФ | Через API-агрегатор | Веб-чат напрямую, API через посредников |
Выбор между этими технологиями сводится к определению природы вашей задачи. Главный вопрос заключается не в том, какой алгоритм умнее или современнее, а в том, какой формат ответа требуется вашему бэкенду. Если архитектура приложения ждет четкую категорию, бинарное подтверждение или числовую оценку, использование медленных и дорогих текстовых генераторов будет избыточным и неэффективным. Быстрые типизированные решения экономят серверное время и радикально сокращают расходы на инфраструктуру.
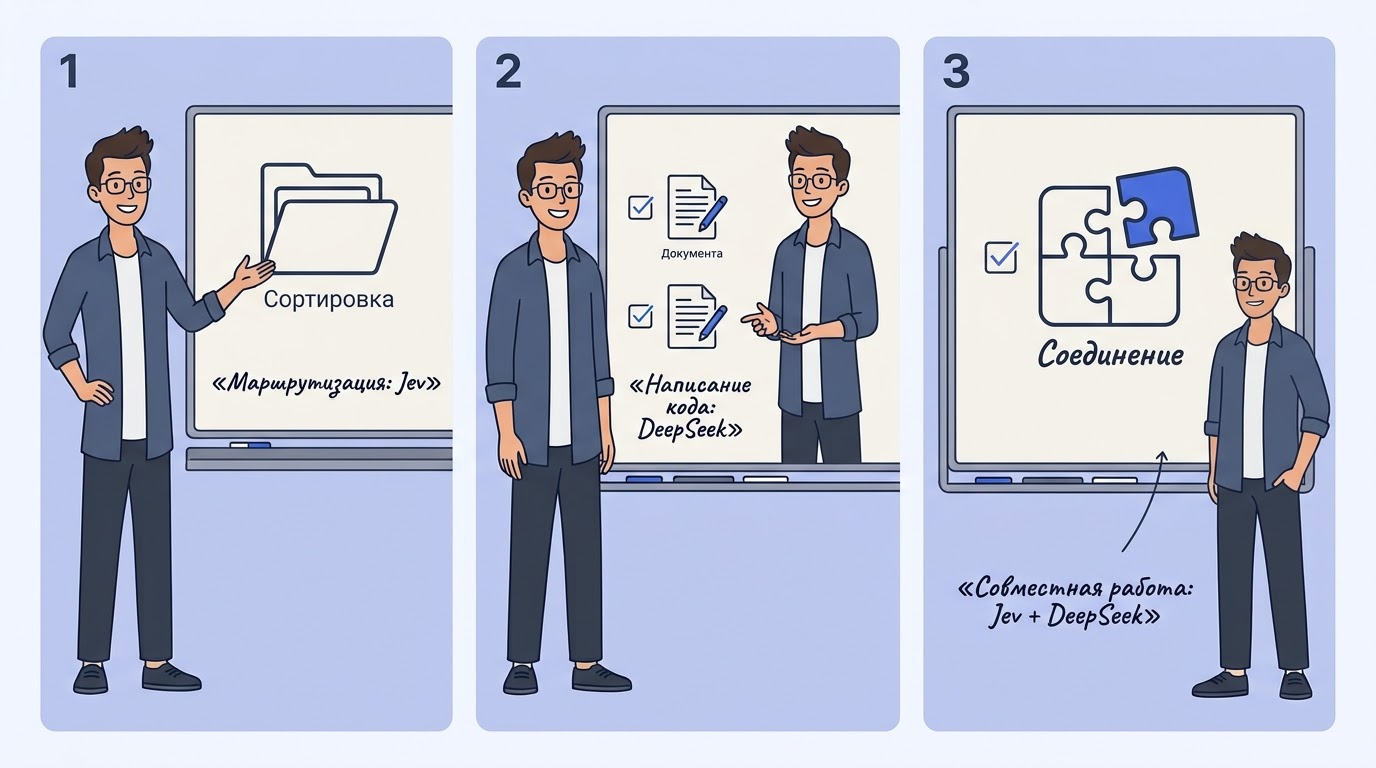
Максимальная эффективность часто достигается при грамотном объединении обеих платформ в единый пайплайн. Практика показывает, что использование быстрого и дешевого классификатора на первой линии обработки запросов позволяет отфильтровать рутину и направить к тяжелой текстовой модели только те задачи, которые действительно требуют развернутой генерации или глубоких логических рассуждений. Такой гибридный подход обеспечивает баланс между феноменальной скоростью реакции системы и высоким качеством генерируемого контента, отвечая самым строгим требованиям современного бизнеса.
Подойдёт ли Jev
1 из 4Что нужно получить от модели?
Сколько вариантов ответа?
Нужна оценка числом?
Критична ли скорость?
Choice
Один вариант из списка без порядка: отдел, тип документа, тема.
| Jev | Opus 5.5 | |
|---|---|---|
| Ответ | «Возврат и обмен», 100% | «Возврат и обмен» |
| Цена запроса | $0,000018 | $0,0016 |
| За 1M токенов | $0,042, выход бесплатно | $4 вход, $20 выход |
Пример запроса
curl https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "jev-latest",
  "state": "Клиент: «Вчера привезли электрочайник: колба треснула, коробка помята. Хочу поменять на новый».",
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "Какой отдел должен обработать обращение?",
      "criteria": {
        "Возврат и обмен": null,
        "Доставка": null,
        "Оплата": null,
        "Другое": null
      }
    }
  }
}'Score
Позиция на шкале с описанными уровнями: срочность, раздражение, риск.
| Jev | Opus 5.5 | |
|---|---|---|
| Ответ | 1,69 из 2, ближе к «В ярости» | «Недоволен» |
| Цена запроса | $0,000016 | $0,0029 |
| За 1M токенов | $0,042, выход бесплатно | $4 вход, $20 выход |
Пример запроса
curl https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "jev-latest",
  "state": "Клиент: «Третий раз пишу, заказ так и не пришёл. Если завтра не будет — отменяю всё и пишу отзыв».",
  "questions": {
    "anger": {
      "type": "score",
      "instructions": "Насколько клиент раздражён?",
      "criteria": [
        "Спокоен",
        "Недоволен",
        "В ярости"
      ]
    }
  }
}'Noul
Вопрос «да или нет», где важна сама вероятность: спам, возврат, риск.
| Jev | Opus 5.5 | |
|---|---|---|
| Ответ | «да», 0,98 | «да» |
| Цена запроса | $0,000014 | $0,0012 |
| За 1M токенов | $0,042, выход бесплатно | $4 вход, $20 выход |
Пример запроса
curl https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "jev-latest",
  "state": "Вы выиграли iPhone 17! Перейдите по ссылке и введите данные карты до полуночи, иначе приз сгорит.",
  "questions": {
    "is_scam": {
      "type": "noul",
      "instructions": "Это мошенническое сообщение?"
    }
  }
}'Нужна LLM
Jev не пишет текст — только выбор, оценку или вероятность. Ставьте его фильтром перед LLM.
| Jev | Opus 5.5 | |
|---|---|---|
| Ответ | «да», 0,98 — в LLM не отправлять | «да» |
| Цена запроса | $0,000014 | $0,0012 |
| За 1M токенов | $0,042, выход бесплатно | $4 вход, $20 выход |
Пример запроса
curl https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "jev-latest",
  "state": "Вы выиграли iPhone 17! Перейдите по ссылке и введите данные карты до полуночи, иначе приз сгорит.",
  "questions": {
    "is_scam": {
      "type": "noul",
      "instructions": "Это мошенническое сообщение?"
    }
  }
}'Ответ и время Jev — замер ai-flip, 6 октября 2026, по одному запросу, цена Jev — docs.typesafe.ai. В колонке Opus 5.5 ответ приведён как пример того, что возвращает генеративная модель, а цена запроса посчитана по официальным тарифам $4 за 1M входных и $20 за 1M выходных токенов (claude.com/pricing).
FAQ
Может ли модель Jev полноценно заменить DeepSeek?
Jev не способна заменить DeepSeek, поскольку разработана для совершенно других задач. Модель DeepSeek генерирует развернутый текст и код, тогда как Jev специализируется на классификации и принятии решений по трем жестким форматам.
Какая нейросеть обходится дешевле для бизнеса?
Jev берет оплату исключительно за входные токены по цене 0.042 доллара за миллион, или 42 доллара за миллиард, а выходные токены отдает бесплатно. Это делает ее существенно более экономной на задачах анализа и классификации больших объемов текста.
Способен ли Jev генерировать программный код как DeepSeek?
Нет, Jev не умеет писать программный код и скрипты, в отличие от генеративных моделей семейства DeepSeek. Она способна лишь отвечать на структурированные вопросы форматов Noul, Choice и Score.
В чем заключается разница между моделями DeepSeek-R1 и DeepSeek-V3?
DeepSeek-V3 создана как универсальная базовая языковая модель на архитектуре Mixture-of-Experts с 671 миллиардом параметров, где на каждый токен активируется 37 миллиардов. DeepSeek-R1 представляет собой специализированную модель с фокусом на пошаговые рассуждения и логику.
Какой объем контекстного окна поддерживается в Jev?
Контекстное окно модели Jev ограничено 32 тысячами токенов. Этого лимита достаточно для подачи объемных документов, инструкций и вариантов ответа перед принятием решения.
Кто является создателем нейросети Jev?
Модель Jev разработана компанией TypeSafe AI, основателем которой выступает Диогу Алмейда, бывший руководитель направления RLHF в OpenAI. Проект был запущен с привлечением 40 миллионов долларов посевных инвестиций.
-
Маршрут от Claude привёл подростка на «Вдоводел»
![Подросток в синей куртке и шлеме радостно смотрит маршрут в телефоне на вершине горы над городом]()
16-летний Брайс из Ванкувера проложил с Claude новый для себя маршрут на гору Краун. ![Подросток с рюкзаком неуверенно пробирается между валунами к крутому гребню]()
Разметки не было: вместо кулуара он попал на гребень «Вдоводел», куда ходят с верёвками. ![Испуганный подросток прижался к отвесной скале на узком уступе и звонит по телефону]()
Брайс застрял на уступе шириной около полутора метров: сзади обрыв, впереди почти отвесная стена. ![Спасатель спускается по верёвке к подростку на уступе, рядом вертолёт]()
Вертолёт не мог подойти к скале: спасатель спустился к Брайсу по верёвке, и его подняли на борт. ![Подросток в спасательном одеяле сидит у тропы с бумажной картой, рядом компас]()
Брайс винит себя, но тропы через ИИ больше не прокладывает. Спасатель: «Claude никогда не был в этих местах». -
950 агентов Claude нашли в ДНК вирусов загадочную систему
![Учёная в лаборатории смотрит на монитор со спиралями ДНК]()
Anthropic поручила Claude найти в огромной базе ДНК необычные ферменты. ![Учёная с планшетом смотрит на стену из сотен мониторов с ДНК]()
Около 950 агентов за 21 час собрали больше 200 тысяч ферментов и написали 20 отчётов. ![Учёная взволнованно показывает на повторяющийся узор в цепочке ДНК на экране]()
Один агент «на глаз» заметил рядом с ферментом повторы, как у CRISPR. Систему назвали ART. ![Учёная поднимает пробирку к свету, коллега задумчиво смотрит рядом]()
Что она делает, пока неизвестно. Пионер CRISPR Фэн Чжан назвал находку «по-настоящему интригующей». -
Anthropic запретила издеваться над Claude
![Женщина в очках сердито кричит на ноутбук и стучит кулаком по столу]()
Anthropic запретила «длительное и бессмысленное» жестокое обращение с Claude. ![Женщина спокойно спорит, разводя рукой перед ноутбуком]()
Речь о крайних случаях. Раздражение, споры, мрачные сюжеты и тесты под запрет не попадают. ![Удивлённая женщина смотрит на ноутбук со значком закрытой двери на экране]()
Главная защита прежняя: Claude сам завершает такой диалог. ![Женщина прикрепляет к доске календарь с обведённым днём]()
Правила действуют с 12 ноября. За нарушения доступ могут ограничить или закрыть. -
ИИ-видео с погибшим в суде: срок назначат заново
![Женщина в зале суда показывает планшет с лицом мужчины]()
В Аризоне сестра погибшего показала в суде видео, где ИИ-аватар брата прощает убийцу. ![Растроганный судья с рукой на груди за судейским столом]()
Судья дал максимальные 10,5 года и сказал, что ему «понравилось это видео». ![Три судьи апелляционного суда изучают документы]()
Апелляционный суд счёл приговор несправедливым: видео «не отражает реальных событий». ![Женщина читает своё заявление с листов за трибуной, планшет выключен]()
Срок назначат заново, а свой текст сестра прочитает сама, без видео. -
Журналист выпустил ИИ-песню от имени чужой группы
![Журналист в наушниках с хитрой улыбкой работает за ноутбуком]()
Журналист 404 Media сгенерировал песню в Udio по простому запросу. ![Трое музыкантов панк-группы в шоке смотрят в телефон]()
Трек вышел на подтверждённой странице панк-группы Lathe of Heaven в Spotify без ведома музыкантов. ![Журналист удивлённо разводит руками, вокруг висят значки музыкальных сервисов]()
Песня попала и в Apple Music, Tidal и Amazon Music — через давнюю лазейку в дистрибуции. ![Довольный мошенник ловит монеты, сыплющиеся из наушников, слушательница расстроена]()
Так мошенники зарабатывают на чужой славе. Площадки и дистрибьюторы ответственность не берут. -
Нейросеть научилась играть в «Точки» и обыгрывает автора
![Разработчик держит тетрадь в клетку с партией в точки]()
Разработчик учил нейросеть игре в «Точки» из школьной тетради — по примеру AlphaZero. ![Разработчик ночью смотрит на два монитора с партиями в точки]()
Сеть играла сама с собой: 30 поколений за полтора месяца, однажды девять пришлось выбросить. ![Разработчик радостно подпрыгивает перед монитором с выигранной партией]()
Ученик обыграл учителя, только когда поиск подняли с 800 до 1600 симуляций на ход. ![Разработчик смеётся, проиграв нейросети партию в точки]()
Теперь сложный уровень игры Just Dots стабильно обыгрывает автора на поле 20×20.
























