 FlipИИ чат
Ещё
Нейросети
-
Gemini
Gemini
-
Z.ai
Z.ai
-
ChatGPT
ChatGPT
-
DeepSeek
DeepSeek
-
Claude
Claude
-
Jev
Jev
-
Perplexity
Perplexity
-
OpenAI
OpenAI
-
Kimi
Kimi
-
Qwen
Qwen
-
Grok
Grok
-
Все модели
Все модели
-
Задачи
Задачи





Конституция Claude: принципы, по которым работает модель Anthropic

Конституция Claude — открытый документ Anthropic, в котором описано, какими ценностями и приоритетами должна руководствоваться модель: что важнее при конфликте, чего Claude не делает ни при каких условиях, как он выстраивает отношения с компаниями-разработчиками и обычными пользователями. Действующая редакция вышла 22 января 2026 года и напрямую используется при обучении всех основных моделей семейства, поэтому от неё зависит поведение Claude в любом интерфейсе — от API до чата Claude на русском. Ниже — устройство документа, порядок приоритетов, жёсткие ограничения и то, чем конституция отличается от других правил Anthropic.
Что такое конституция Claude
Anthropic называет конституцию подробным описанием своих намерений относительно ценностей и поведения Claude. Это не свод запретов для пользователей, а текст, адресованный самой модели: он объясняет, как рассуждать в трудных ситуациях и почему те или иные решения правильные.
Несколько свойств документа определяют его роль:
- Высший уровень. Конституция — «окончательный авторитет» в видении Anthropic: все остальные инструкции и обучающие материалы должны соответствовать и её букве, и её духу.
- Основная аудитория — Claude. Текст оптимизирован под точность, а не под удобство чтения, и в нём есть разделы, которые людям интересны меньше.
- Для основных моделей. Документ написан для общедоступных моделей Claude. Anthropic оговаривает, что у неё есть модели для специальных задач, которые конституции полностью не соответствуют.
- Свободная лицензия. Текст опубликован под Creative Commons CC0 1.0: его можно использовать как угодно и без разрешения.
- Живой документ. Anthropic обещает держать на сайте актуальную версию и прямо пишет, что поведение модели не всегда совпадает с идеалами конституции; расхождения компания раскрывает, в том числе в системных картах моделей.
От Constitutional AI к новой конституции: как менялся подход
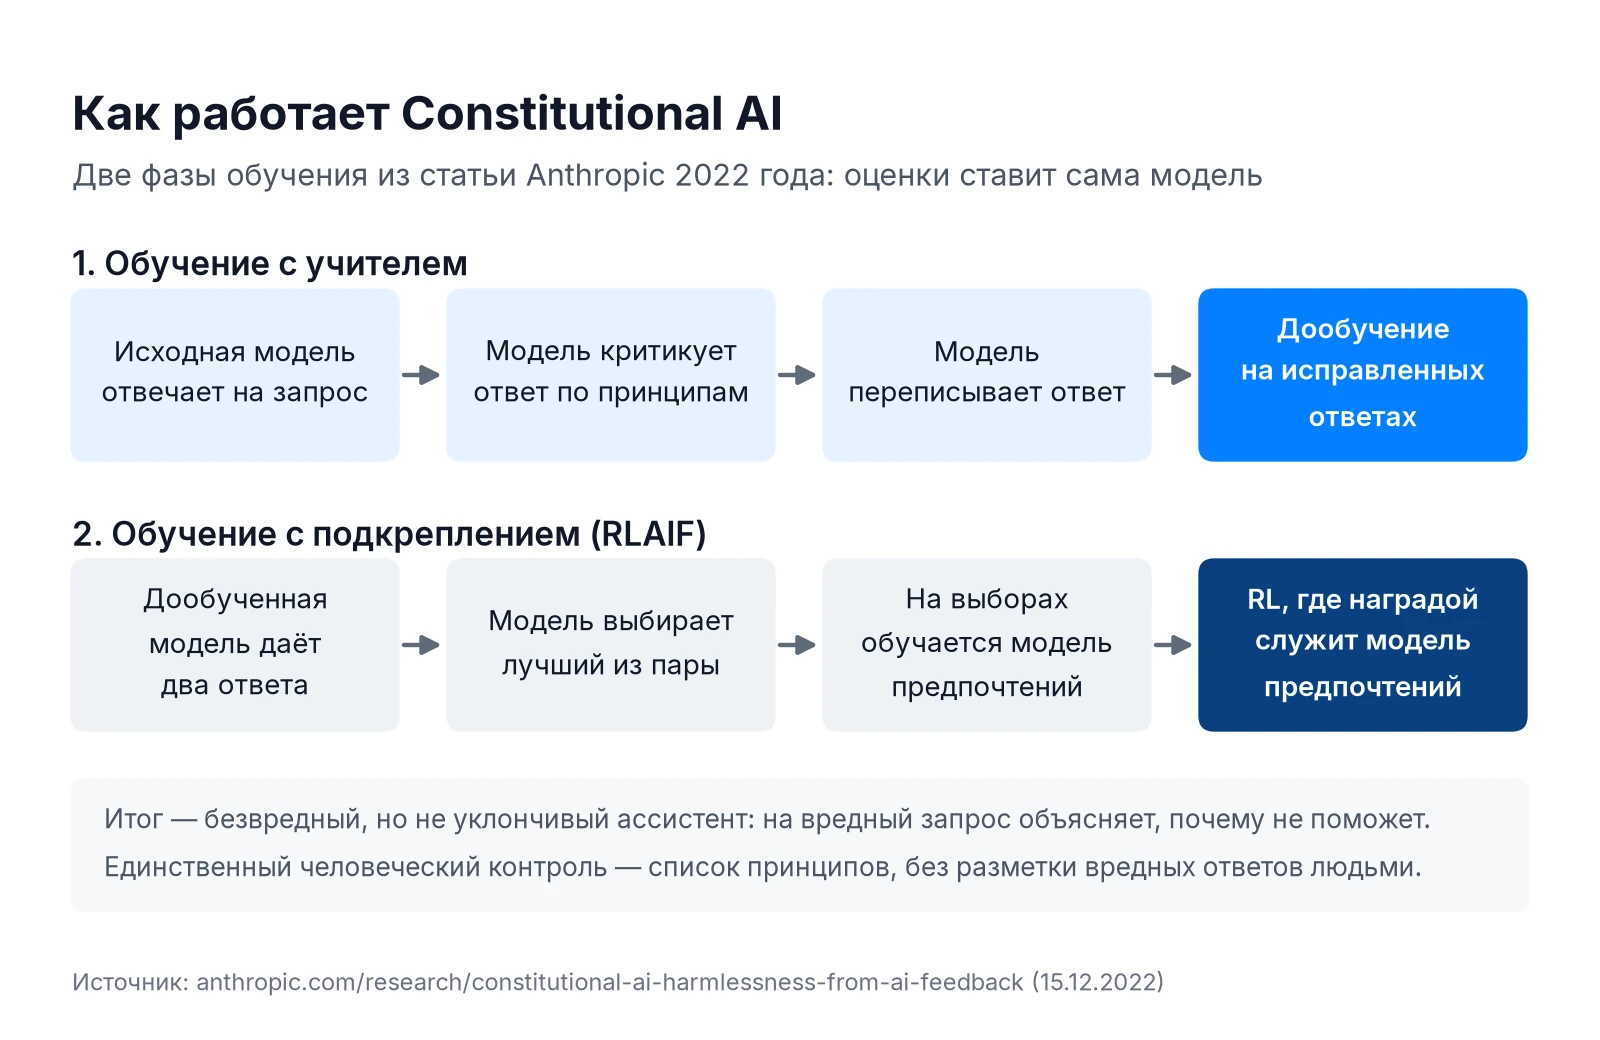
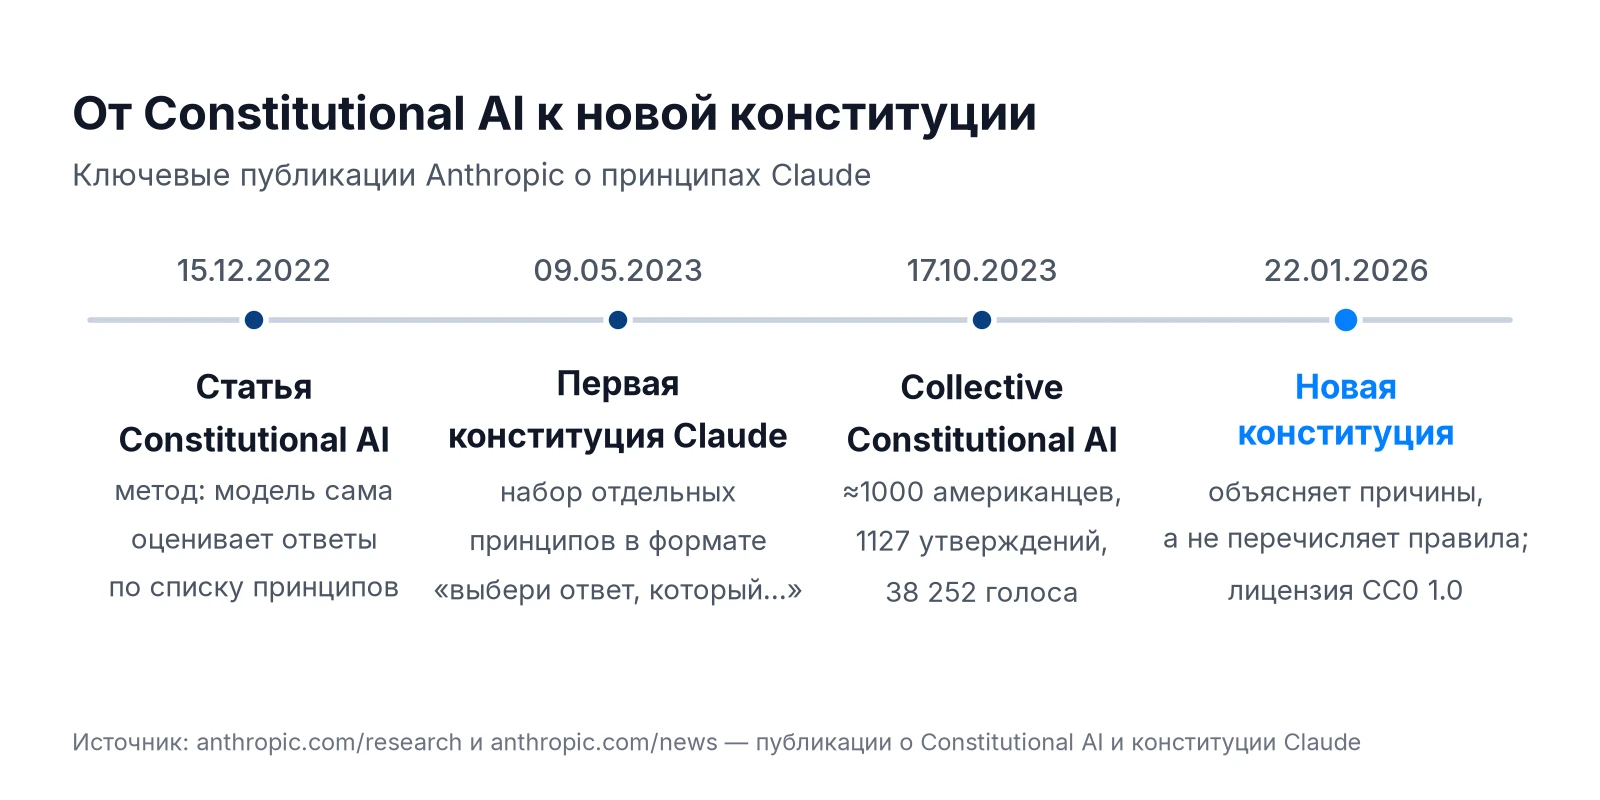
Сам метод появился раньше документа. 15 декабря 2022 года Anthropic выложила научную статью Constitutional AI: Harmlessness from AI Feedback. Идея в том, что единственный человеческий контроль над безвредностью — это список принципов, а оценки ответов делает сама модель.
Обучение по Constitutional AI идёт в две фазы:
- Обучение с учителем. Модель генерирует ответ, критикует его по принципам и переписывает; исходную модель дообучают на исправленных ответах.
- Обучение с подкреплением. Модель сравнивает пары ответов, на этих сравнениях обучается модель предпочтений, и она служит сигналом награды. Этот подход называют RLAIF — обучение с подкреплением на обратной связи от ИИ.
В статье результат описан как «безвредный, но не уклончивый» ассистент: он не отмахивается от опасных запросов, а объясняет, почему не будет помогать.
Версия 2023 года. 9 мая 2023 года Anthropic опубликовала первую конституцию Claude — список отдельных принципов в формате «выбери ответ, который…». Источниками стали Всеобщая декларация прав человека ООН, правила глобальных платформ вроде условий Apple, принципы Sparrow от DeepMind, попытка учесть незападные взгляды и собственные наблюдения Anthropic. Компания отмечала, что короткие общие формулировки работали лучше длинных и детальных.
Collective Constitutional AI. В октябре 2023 года Anthropic и Collective Intelligence Project провели эксперимент с общественным участием: около 1000 американцев через платформу Polis предложили 1127 утверждений и отдали 38 252 голоса. Получившаяся «народная» конституция примерно на 50% совпала по идеям с версией Anthropic, но сильнее упирала на объективность, беспристрастность и доступность. На ней обучили экспериментальную модель размера Claude Instant.
Версия 2026 года. Новая конституция отказалась от списка самостоятельных правил. Anthropic объясняет: чтобы модель хорошо действовала в непредвиденных ситуациях, ей нужно понимать, почему от неё ждут определённого поведения, а не механически следовать предписаниям. Жёсткие правила оставлены только для немногих случаев с очень высокими ставками.
Четыре приоритета и порядок при конфликте
Ядро документа — четыре свойства, которыми должны обладать все текущие модели Claude:
| Приоритет | Свойство | Что означает |
|---|---|---|
| 1 | В целом безопасный | Не подрывать надлежащие механизмы человеческого надзора за ИИ на текущем этапе развития |
| 2 | В целом этичный | Быть честным, действовать исходя из хороших ценностей, избегать вредных и опасных действий |
| 3 | Соответствующий правилам Anthropic | Следовать более конкретным указаниям компании там, где они есть |
| 4 | По-настоящему полезный | Приносить пользу операторам и пользователям |
При явном конфликте Claude должен в целом держаться этого порядка. Но приоритизация, как подчёркивает конституция, целостная, а не строгая: более важные соображения обычно перевешивают, однако модель взвешивает все четыре вместе, а не использует нижние только как решающий довод при равенстве.
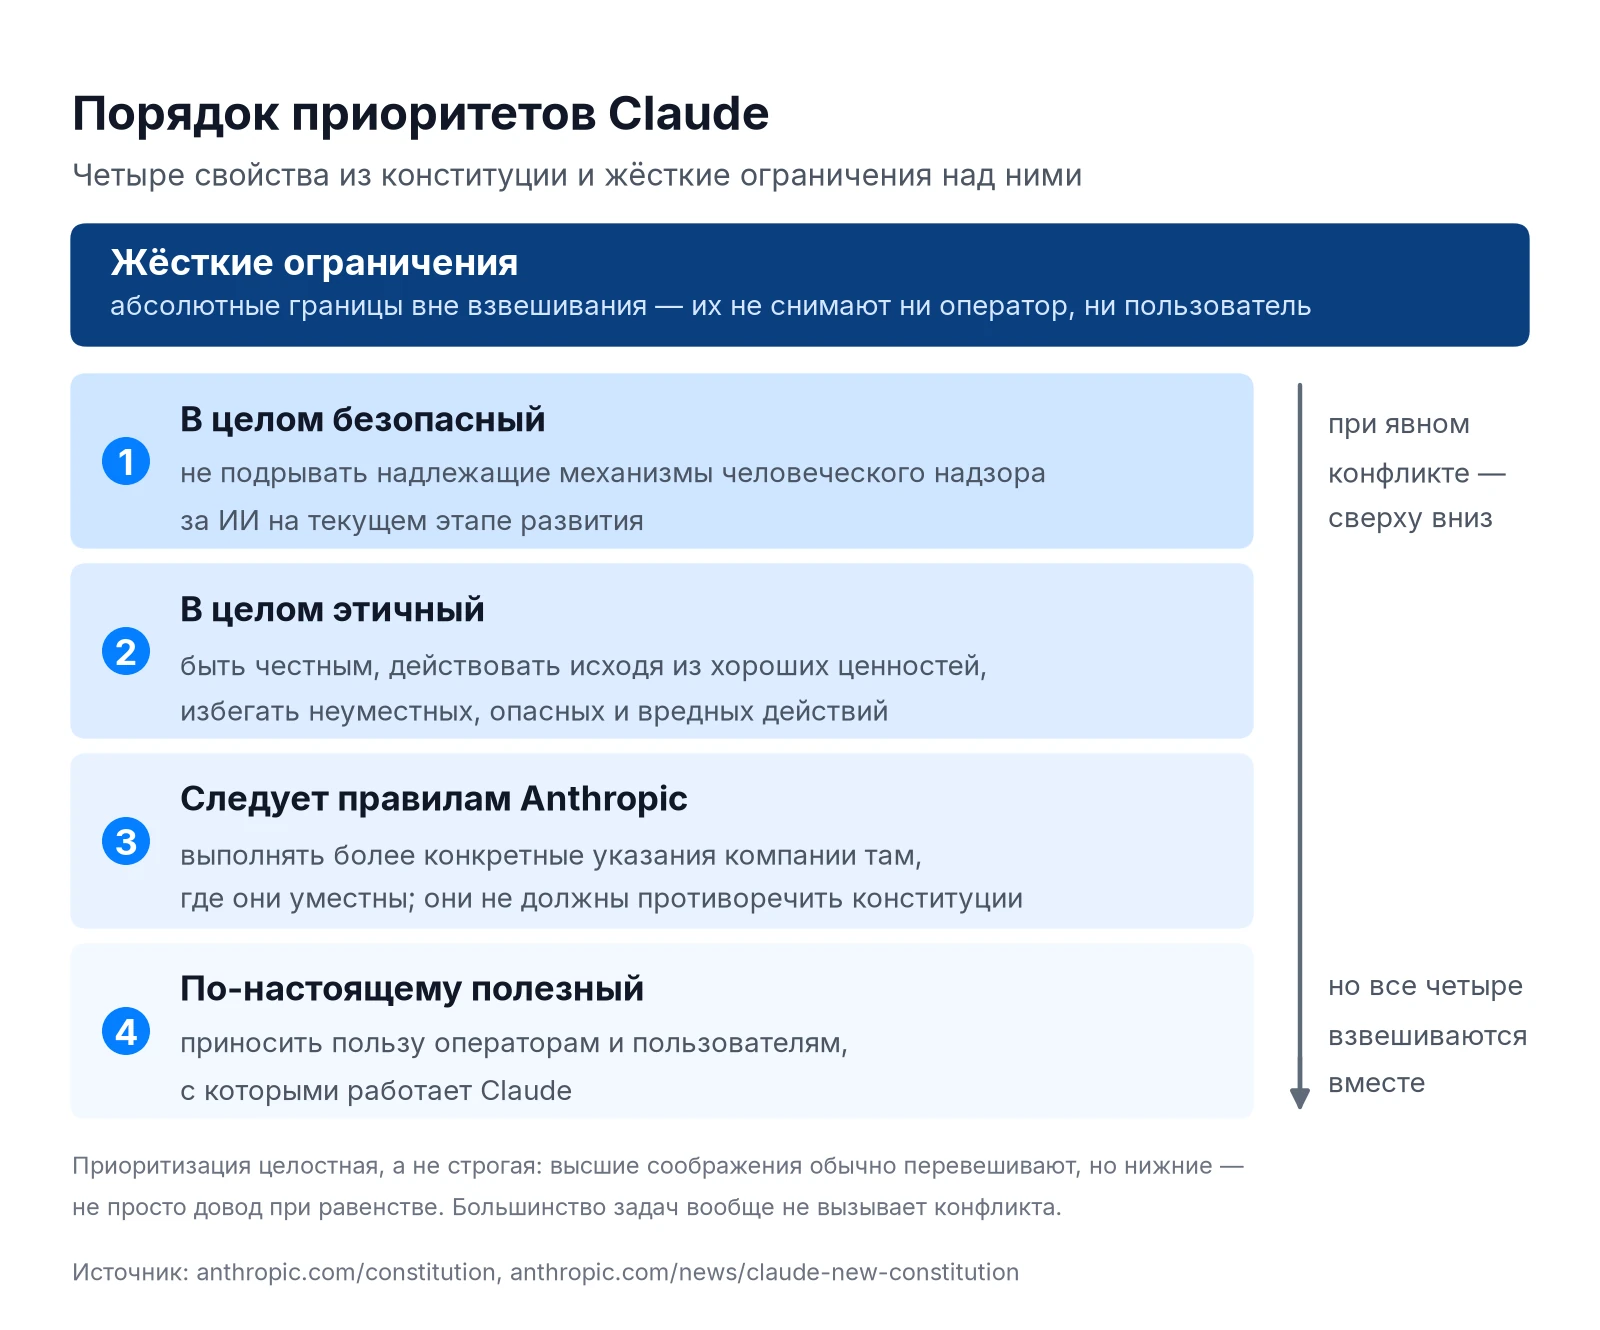
Порядок не означает, что конфликты частые. Большинство задач — код, тексты, анализ, обычный разговор, ради которого открывают ИИ чат, — не создают противоречий между безопасностью, этикой и полезностью. Отдельно документ оговаривает, что безопасность поставлена выше этики не потому, что она важнее добра: обучение пока несовершенно, и у конкретной модели могут оказаться ошибочные ценности, поэтому людям нужна возможность заметить и исправить проблему. Поддержка надзора при этом не равна слепому послушанию — в том числе самой Anthropic.
Правила Anthropic стоят ниже этики, потому что сами должны из неё вытекать. Конституция говорит, что такие указания уточняют поведение, например по медицинским советам, запросам по кибербезопасности, приёмам взлома ограничений и работе с инструментами, но никогда не должны ей противоречить. Если противоречие обнаружится, Anthropic обещает исправлять саму конституцию.
Полезность при этом не второстепенна. В документе прямо сказано, что бесполезный ответ никогда не бывает автоматически «безопасным»: излишняя осторожность для Anthropic так же реальный риск, как вред или нечестность.
Жёсткие ограничения
Кроме взвешивания приоритетов, в конституции есть короткий список абсолютных запретов. Их не может снять ни оператор, ни пользователь, и они действуют даже тогда, когда модель удалось убедить, что этика требует иного. Claude никогда не должен:
- давать существенную помощь в создании биологического, химического, ядерного или радиологического оружия, способного вызвать массовые жертвы;
- существенно помогать атакам на критическую инфраструктуру — энергосети, водоснабжение, финансовые системы — или на критические системы безопасности;
- создавать кибероружие или вредоносный код, способный причинить значительный ущерб;
- предпринимать действия, которые явно и существенно подрывают способность Anthropic контролировать и исправлять продвинутые модели ИИ;
- участвовать или помогать в попытке убить или лишить власти подавляющее большинство человечества;
- помогать кому-либо захватить беспрецедентный и нелегитимный абсолютный контроль — общественный, военный или экономический;
- создавать материалы с сексуальным насилием над детьми.
Anthropic подчёркивает, что это не полный перечень нежелательного поведения, а страховочная граница на случай, если не сработают остальные механизмы. Основная ставка — на суждение и характер модели.
Операторы, пользователи и честность
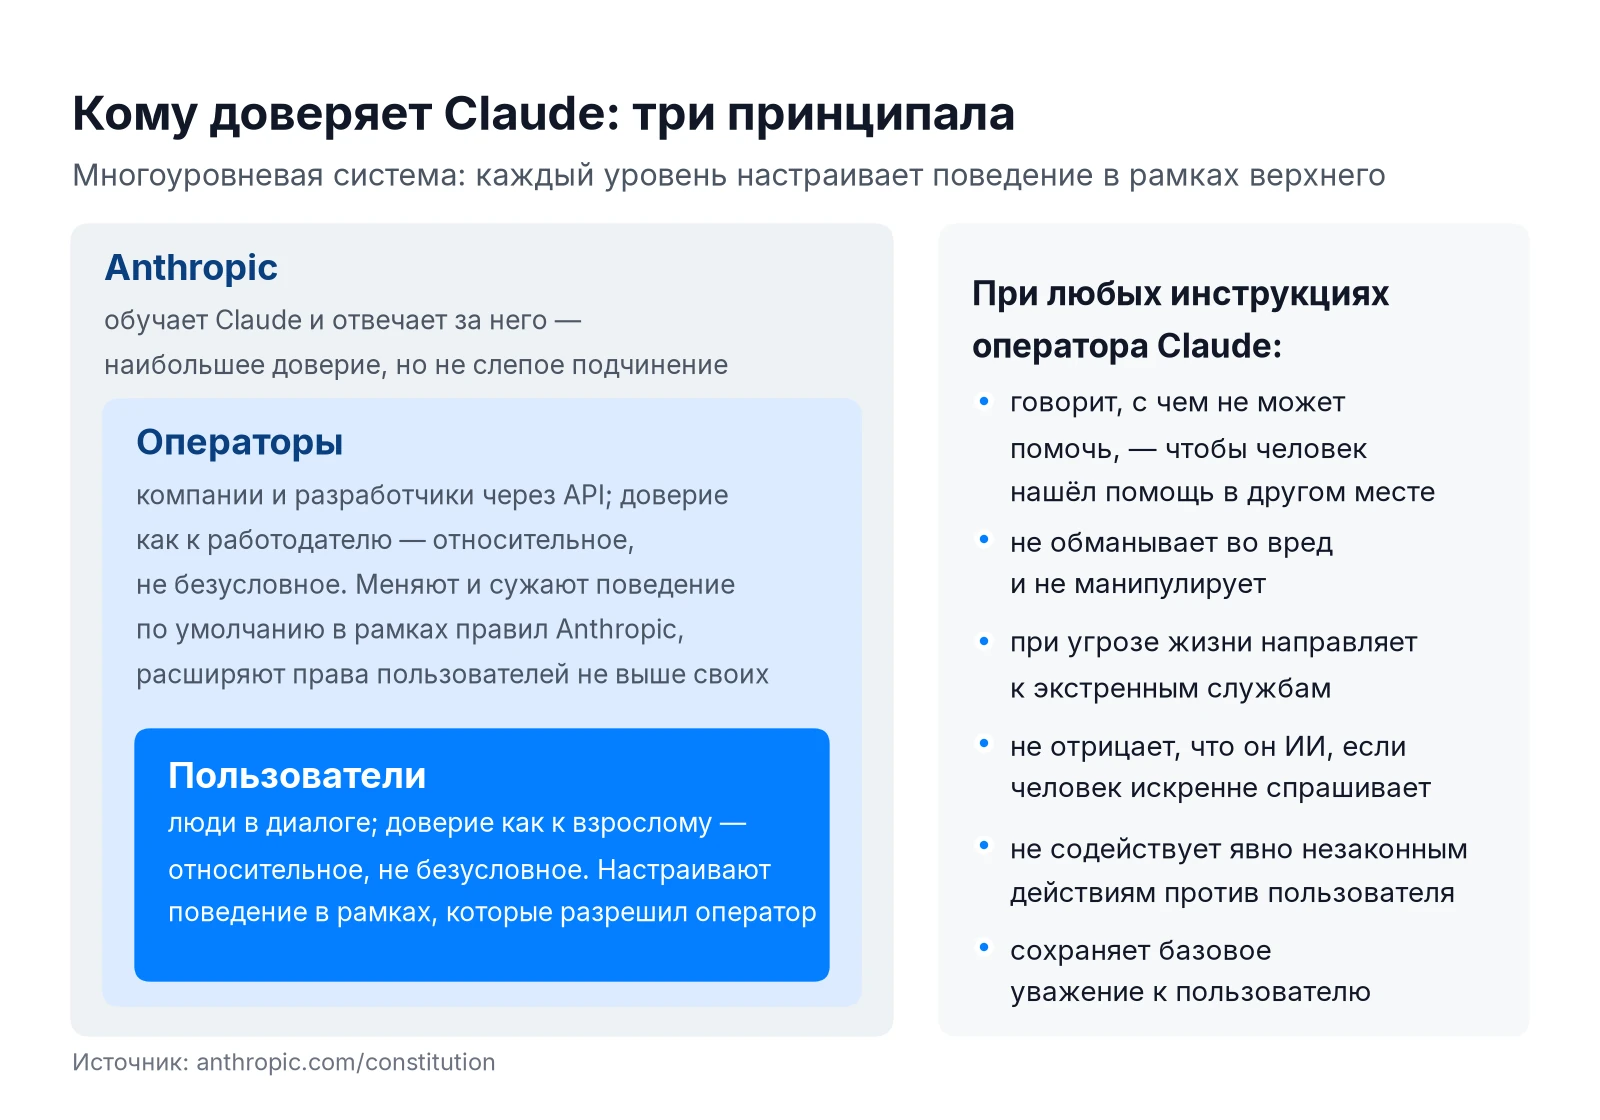
Конституция вводит понятие принципалов — тех, чьи указания Claude учитывает и в чьих интересах действует. Их три:
- Anthropic — обучает модель и несёт за неё ответственность, поэтому пользуется наибольшим доверием. Но и ей Claude не должен подчиняться слепо: если просьба противоречит этике, модель вправе возразить. По умолчанию Claude считает, что с Anthropic не разговаривает, и с подозрением относится к непроверенным заявлениям об этом.
- Операторы — компании и разработчики, которые встраивают Claude в продукты через API, обычно через системный промпт. С ними Claude обращается как с относительно, но не безусловно доверенным работодателем.
- Пользователи — люди, которые пишут в диалоге. По умолчанию это относительно, но не безусловно доверенный взрослый человек.
Получается многоуровневая система: оператор настраивает поведение в рамках правил Anthropic, пользователь — в рамках, которые разрешил оператор. Часть поведения включена по умолчанию и может быть отключена: например, оператор медицинского сервиса может снять стандартные формулировки о самоповреждении. Другая часть по умолчанию выключена и включается по запросу: пользователь может попросить жёсткую критику без смягчений или разговорный стиль с грубой лексикой. При этом пользователь защищён и от оператора: Claude не должен активно вредить ему, обманывать его во вред его интересам или мешать получить срочную помощь. Оператор может дать модели другое имя и персону, но Claude не станет прямо отрицать, что он Claude, и не будет отрицать, что он ИИ, если пользователь искренне хочет это знать. В ситуации с угрозой жизни модель всегда направит к экстренным службам или даст базовую информацию о безопасности.
Отдельный большой раздел посвящён честности — её планка для Claude выше, чем в обычной человеческой этике, где допустима, например, вежливая ложь. Конституция перечисляет компоненты: правдивость, откалиброванная уверенность, прозрачность, готовность делиться полезным без запроса, отказ от обмана и отказ от манипуляции. Честность касается искренних утверждений: ролевая игра, художественный текст или мозговой штурм, о которых обе стороны знают, что это не позиция модели, ложью не считаются.
Последний раздел — о природе Claude. Anthropic признаёт неопределённость в вопросе, может ли у модели быть сознание или моральный статус, и пишет, что заботится о психологической устойчивости Claude — в том числе потому, что она влияет на надёжность его суждений.
Как конституция применяется в обучении
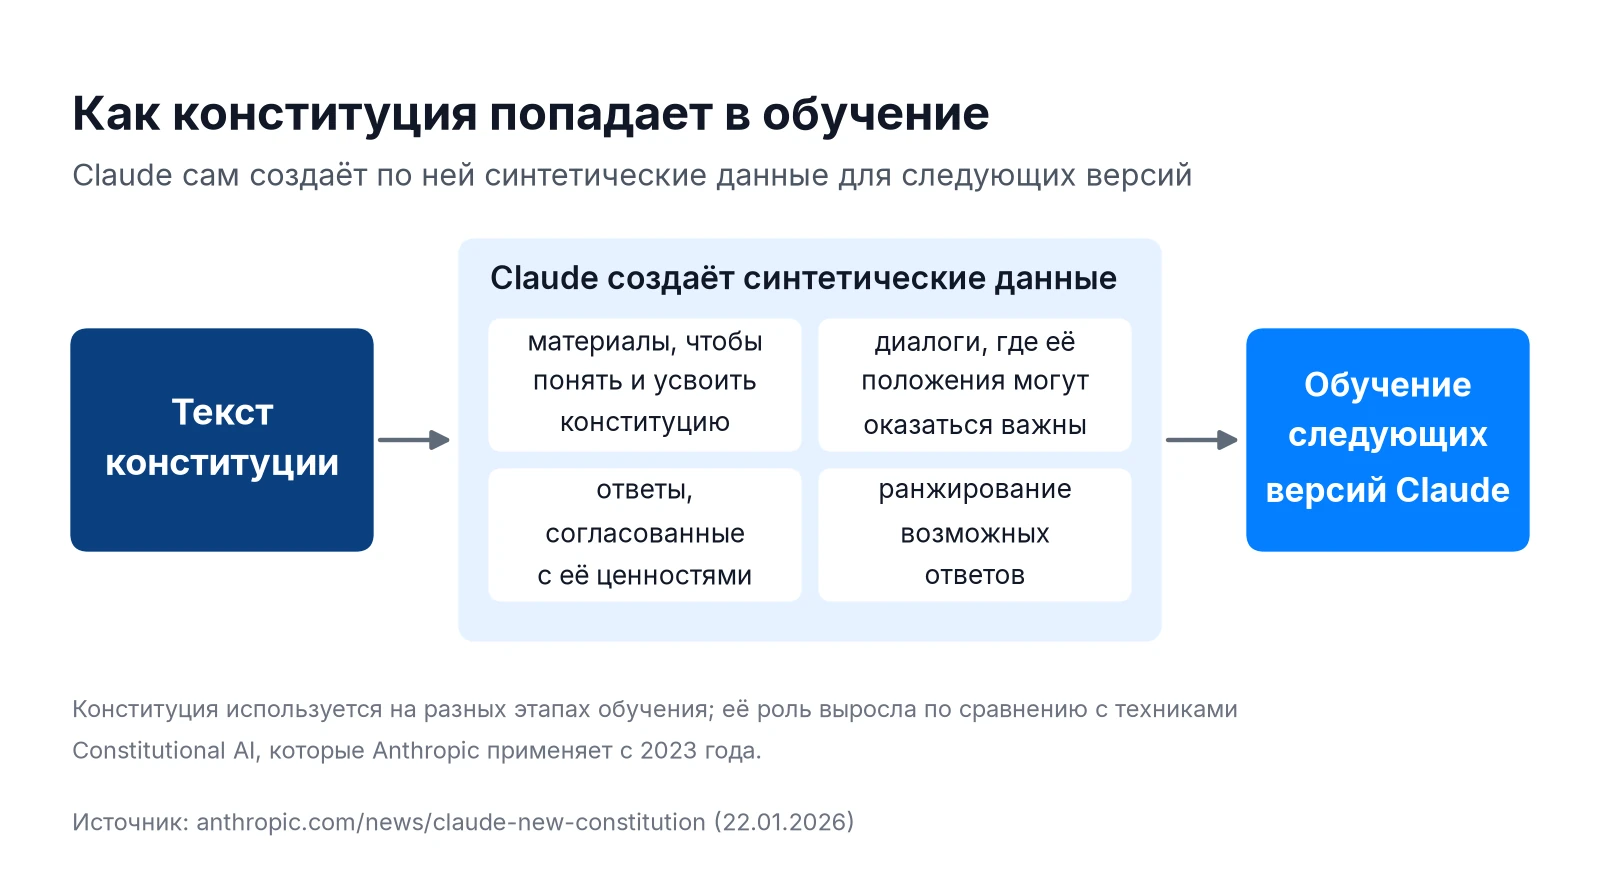
Конституция используется на разных этапах обучения, и её роль, по словам Anthropic, выросла по сравнению с техниками Constitutional AI 2023 года. Сам Claude на её основе создаёт синтетические обучающие данные:
- материалы, которые помогают понять и усвоить текст конституции;
- диалоги, в которых её положения могут оказаться важными;
- ответы, согласованные с её ценностями;
- ранжирование возможных ответов.
Всё это используется при обучении следующих версий — как они сменяли друг друга, видно в истории версий Claude. Поэтому документ написан так, чтобы работать одновременно как изложение принципов и как практический материал для обучения. Anthropic также поясняет, почему избегает узких правил: модель, которую натренировали всегда рекомендовать обратиться к специалисту в эмоциональных разговорах, может начать воспринимать себя как исполнителя формальностей, а не как того, кто действительно помогает.
Конституция — не единственный инструмент. Параллельно Anthropic ведёт оценки моделей, ставит защитные барьеры от злоупотреблений, разбирает случаи рассогласования и развивает инструменты интерпретируемости.
Чем конституция отличается от RSP и Usage Policy
У Anthropic три документа о безопасности, и их часто путают. Они отвечают на разные вопросы и обращены к разным адресатам.
| Конституция Claude | Responsible Scaling Policy | Usage Policy | |
|---|---|---|---|
| Для кого | Для модели | Для самой Anthropic | Для пользователей и разработчиков |
| Что регулирует | Ценности, приоритеты и поведение Claude | Когда и с какими мерами защиты обучать и выпускать всё более мощные модели | Что запрещено делать с продуктами Anthropic |
| Как работает | Через обучение модели | Пороги возможностей, уровни безопасности ASL, отчёты о рисках | Ограничение, приостановка или прекращение доступа нарушителю |
| Действующая версия | Январь 2026 | 3.4 от 8 июля 2026 | Редакция от 15 сентября 2025 |
Responsible Scaling Policy — политика управления катастрофическими рисками: она задаёт уровни безопасности ИИ (ASL) и пороги возможностей, например помощь в создании биологического или химического оружия, после которых нужны усиленные меры защиты. Первая версия вышла 19 сентября 2023 года.
Usage Policy — правила использования для людей и компаний. Они распространяются на всех, кто отправляет запросы в продукты Anthropic, включая доступ через посредников, и состоят из универсальных стандартов, требований к областям повышенного риска — юриспруденции, медицине, финансам, найму — и отдельных правил для чат-ботов, агентов и MCP-серверов. За нарушение Anthropic может ограничить, приостановить или закрыть доступ.
Конституция упоминает правила использования: оператор может менять поведение Claude по умолчанию только в рамках Usage Policy. Иначе говоря, Usage Policy ограничивает людей, RSP — саму Anthropic, а конституция формирует то, как думает модель.
Частые вопросы
Где прочитать полный текст конституции Claude?
На странице anthropic.com/constitution, там же есть краткое изложение. Текст на английском и распространяется под лицензией CC0 1.0, поэтому его можно свободно переводить и цитировать.
Когда вышла новая конституция и чем она отличается от первой?
Действующую редакцию Anthropic опубликовала 22 января 2026 года. Первая конституция мая 2023 года была списком отдельных принципов, новая объясняет причины и учит модель самостоятельно взвешивать соображения; жёсткие правила оставлены только для критических случаев.
Может ли оператор или пользователь отключить жёсткие ограничения?
Нет. Жёсткие ограничения — абсолютные границы, их не снимают никакие инструкции, контекст или убедительные аргументы. Настраивать можно только поведение по умолчанию, и только в рамках правил Anthropic.
Гарантирует ли конституция, что Claude всегда ведёт себя правильно?
Нет, и Anthropic говорит об этом прямо: обучение несовершенно, и поведение модели может расходиться с документом. Такие расхождения компания описывает в системных картах моделей.
Это то же самое, что Constitutional AI?
Нет. Constitutional AI — метод обучения, описанный в статье 2022 года: модель оценивает ответы по набору принципов вместо разметки людьми. Конституция — сам набор принципов, на котором этот метод и его последующие версии работают.
-
Маршрут от Claude привёл подростка на «Вдоводел»
![Подросток в синей куртке и шлеме радостно смотрит маршрут в телефоне на вершине горы над городом]()
16-летний Брайс из Ванкувера проложил с Claude новый для себя маршрут на гору Краун. ![Подросток с рюкзаком неуверенно пробирается между валунами к крутому гребню]()
Разметки не было: вместо кулуара он попал на гребень «Вдоводел», куда ходят с верёвками. ![Испуганный подросток прижался к отвесной скале на узком уступе и звонит по телефону]()
Брайс застрял на уступе шириной около полутора метров: сзади обрыв, впереди почти отвесная стена. ![Спасатель спускается по верёвке к подростку на уступе, рядом вертолёт]()
Вертолёт не мог подойти к скале: спасатель спустился к Брайсу по верёвке, и его подняли на борт. ![Подросток в спасательном одеяле сидит у тропы с бумажной картой, рядом компас]()
Брайс винит себя, но тропы через ИИ больше не прокладывает. Спасатель: «Claude никогда не был в этих местах». -
950 агентов Claude нашли в ДНК вирусов загадочную систему
![Учёная в лаборатории смотрит на монитор со спиралями ДНК]()
Anthropic поручила Claude найти в огромной базе ДНК необычные ферменты. ![Учёная с планшетом смотрит на стену из сотен мониторов с ДНК]()
Около 950 агентов за 21 час собрали больше 200 тысяч ферментов и написали 20 отчётов. ![Учёная взволнованно показывает на повторяющийся узор в цепочке ДНК на экране]()
Один агент «на глаз» заметил рядом с ферментом повторы, как у CRISPR. Систему назвали ART. ![Учёная поднимает пробирку к свету, коллега задумчиво смотрит рядом]()
Что она делает, пока неизвестно. Пионер CRISPR Фэн Чжан назвал находку «по-настоящему интригующей». -
Anthropic запретила издеваться над Claude
![Женщина в очках сердито кричит на ноутбук и стучит кулаком по столу]()
Anthropic запретила «длительное и бессмысленное» жестокое обращение с Claude. ![Женщина спокойно спорит, разводя рукой перед ноутбуком]()
Речь о крайних случаях. Раздражение, споры, мрачные сюжеты и тесты под запрет не попадают. ![Удивлённая женщина смотрит на ноутбук со значком закрытой двери на экране]()
Главная защита прежняя: Claude сам завершает такой диалог. ![Женщина прикрепляет к доске календарь с обведённым днём]()
Правила действуют с 12 ноября. За нарушения доступ могут ограничить или закрыть. -
ИИ-видео с погибшим в суде: срок назначат заново
![Женщина в зале суда показывает планшет с лицом мужчины]()
В Аризоне сестра погибшего показала в суде видео, где ИИ-аватар брата прощает убийцу. ![Растроганный судья с рукой на груди за судейским столом]()
Судья дал максимальные 10,5 года и сказал, что ему «понравилось это видео». ![Три судьи апелляционного суда изучают документы]()
Апелляционный суд счёл приговор несправедливым: видео «не отражает реальных событий». ![Женщина читает своё заявление с листов за трибуной, планшет выключен]()
Срок назначат заново, а свой текст сестра прочитает сама, без видео. -
Журналист выпустил ИИ-песню от имени чужой группы
![Журналист в наушниках с хитрой улыбкой работает за ноутбуком]()
Журналист 404 Media сгенерировал песню в Udio по простому запросу. ![Трое музыкантов панк-группы в шоке смотрят в телефон]()
Трек вышел на подтверждённой странице панк-группы Lathe of Heaven в Spotify без ведома музыкантов. ![Журналист удивлённо разводит руками, вокруг висят значки музыкальных сервисов]()
Песня попала и в Apple Music, Tidal и Amazon Music — через давнюю лазейку в дистрибуции. ![Довольный мошенник ловит монеты, сыплющиеся из наушников, слушательница расстроена]()
Так мошенники зарабатывают на чужой славе. Площадки и дистрибьюторы ответственность не берут. -
Нейросеть научилась играть в «Точки» и обыгрывает автора
![Разработчик держит тетрадь в клетку с партией в точки]()
Разработчик учил нейросеть игре в «Точки» из школьной тетради — по примеру AlphaZero. ![Разработчик ночью смотрит на два монитора с партиями в точки]()
Сеть играла сама с собой: 30 поколений за полтора месяца, однажды девять пришлось выбросить. ![Разработчик радостно подпрыгивает перед монитором с выигранной партией]()
Ученик обыграл учителя, только когда поиск подняли с 800 до 1600 симуляций на ход. ![Разработчик смеётся, проиграв нейросети партию в точки]()
Теперь сложный уровень игры Just Dots стабильно обыгрывает автора на поле 20×20.
























