 FlipИИ чат
Ещё
Нейросети
-
Gemini
Gemini
-
Z.ai
Z.ai
-
ChatGPT
ChatGPT
-
DeepSeek
DeepSeek
-
Claude
Claude
-
Jev
Jev
-
Perplexity
Perplexity
-
OpenAI
OpenAI
-
Kimi
Kimi
-
Qwen
Qwen
-
Grok
Grok
-
Все модели
Все модели
-
Задачи
Задачи





Claude Opus 5.5: всё о новой модели Anthropic — возможности, цена и бенчмарки

Новая флагманская модель claude ai от Anthropic, Claude Opus 5.5, вышла 22 сентября 2026 года — и сразу переопределила ожидания от флагманского класса: она работает на уровне модели Fable 5.1 на большинстве задач, но обходится примерно на 40% дешевле Opus 5 в типовых задачах. По данным официальной страницы Anthropic, модель доступна в Claude API, а также на AWS, Google Cloud и Microsoft Azure; там же зафиксирован факт снижения числа попыток обхода защитных границ примерно на 85% по сравнению с Opus 5 или Claude Mythos 5.1. Что умеет Клод нейросеть помимо Opus и как зарегистрироваться, рассказано в общем обзоре.
Стоимость модели ниже, чем у предшественника, ответы генерируются заметно быстрее, а рассуждения включены всегда: их глубину задаёт параметр effort, отключить мышление нельзя.
В этой статье разберём, что именно изменилось в Opus 5.5 по сравнению с Opus 5 и Fable 5.1, какие возможности открывает модель, сколько реально стоит её использование, какие бенчмарки она показывает и как получить к ней доступ из России.
Что такое Claude Opus 5.5 и когда она вышла
Anthropic выпустила Claude Opus 5.5 22 сентября 2026 года как прямого преемника Opus 5 — это первый релиз компании после публичного призыва CEO Дарио Амодеи синхронизировать гонку возможностей с прогрессом в области безопасности. Клод Опус 5.5 позиционируется как новый эталон в автономном программировании и работе со знаниями, а не просто инкрементальное обновление флагмана.
Дата выхода и позиционирование
Релиз состоялся 22 сентября 2026 года — ровно в тот день, когда модель стала общедоступна в Claude API и на трёх крупнейших облачных платформах. Anthropic сопроводила релиз заявлением, что Опус 5.5 задаёт новый уровень не только в бенчмарках, но и в реальных агентных сценариях: автономная разработка, миграции кодовой базы, финансовый анализ.
Дарио Амодеи обозначил этот релиз как подтверждение тезиса о том, что прирост возможностей и прирост безопасности могут идти вместе, а не в разные стороны. Это задало общий тон позиционирования — Клод Опус 5.5 представлена не просто более мощной моделью, а более надёжной в работе.
Место в линейке Claude
Opus — старшая и наиболее мощная линейка Claude, ориентированная на сложные, длительные и многошаговые задачи. Опус 5.5 сменяет Opus 5 и, несмотря на меньший размер по сравнению с Fable 5.1, обходит её на ряде агентных бенчмарков. Идентификатор модели для API — claude-opus-5-5.
Линейка Claude включает три уровня:
- Opus — флагман для сложных агентных и аналитических задач
- Sonnet — баланс скорости и качества для большинства сценариев
- Haiku — быстрые и дешёвые задачи с высокой частотой запросов
Подробнее история предыдущего поколения описана в статье Claude Opus 4.1 на Википедии, а общие сведения о компании — в материале Anthropic на Русской Википедии.
Чем Opus 5.5 отличается от Opus 5 и Fable 5.1
Opus 5.5 отличается тем, что даёт уровень Fable 5.1 примерно на 40% дешевле в типовых нагрузках, при этом Claude Opus 5.5 стоит на 40% дешевле в работе, чем Claude Opus 5, и Claude Opus 5.5 работает на уровне Claude Fable 5.1 на ключевых агентных задачах. Это сочетание делает модель редким случаем, когда меньший по размеру преемник конкурирует с более крупной моделью по качеству и выигрывает по цене.
Дешевле и быстрее предшественника
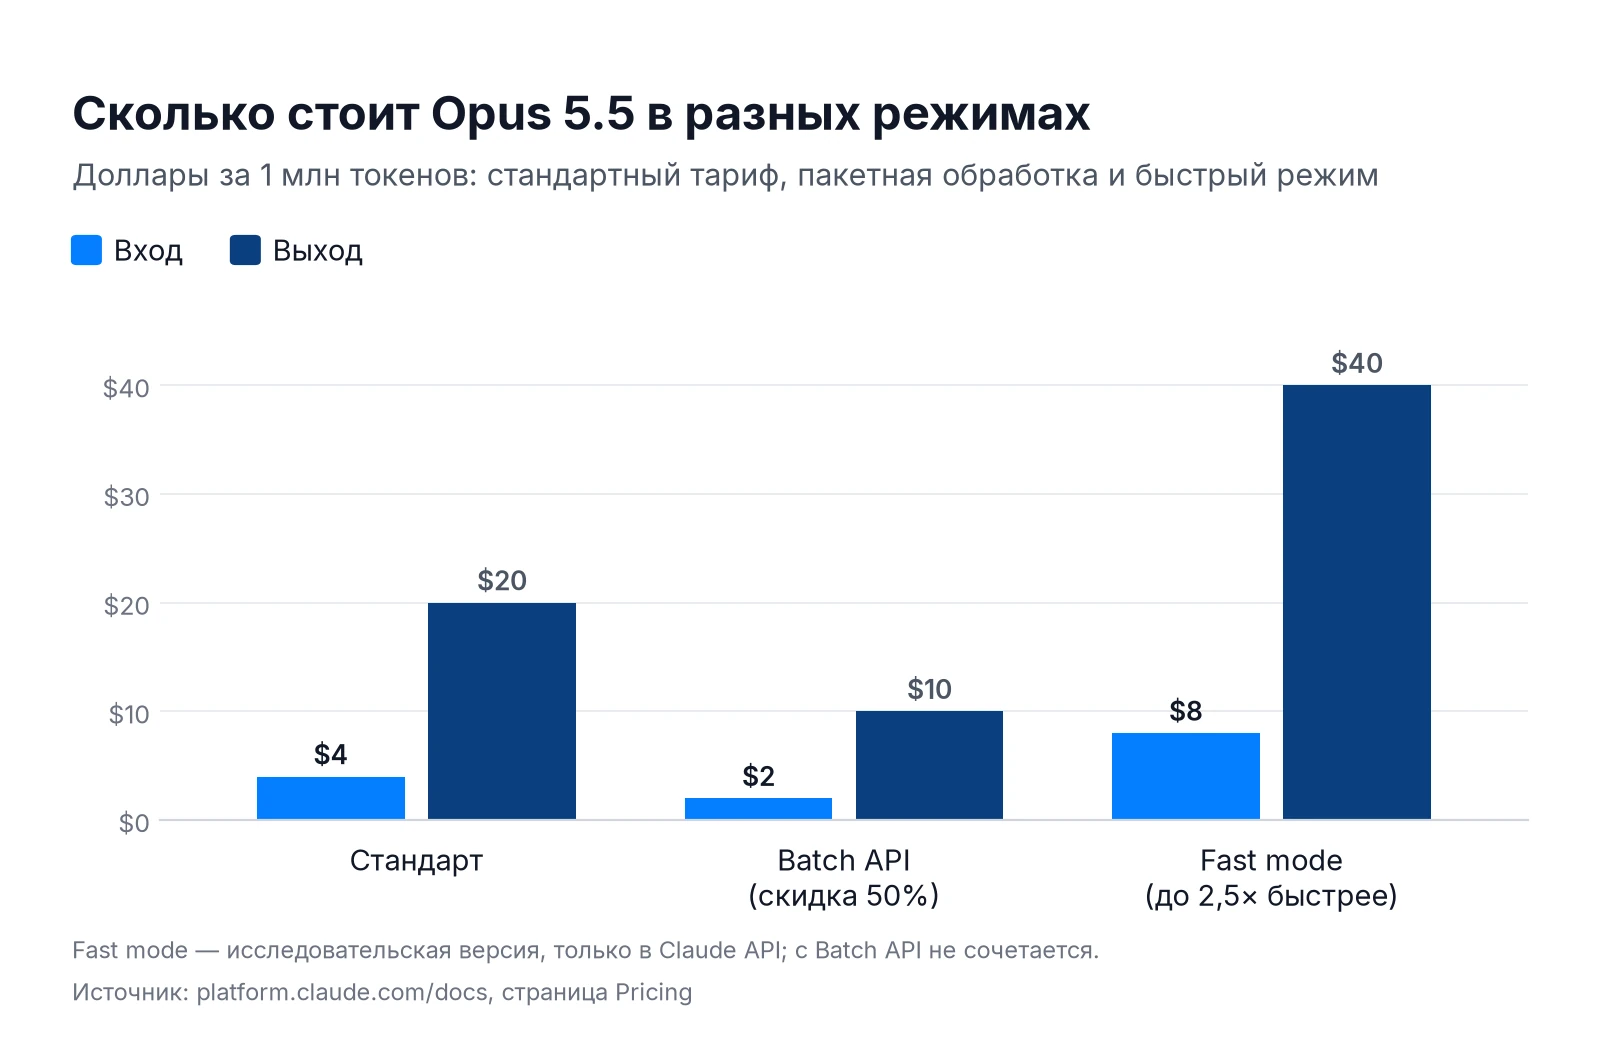
Входные токены подешевели с 5 до 4 долларов за миллион (снижение на 20%), выходные — с 25 до 20 долларов (тоже минус 20%). Чтение из кэша стало дешевле сразу на 60% и теперь обходится в 0,20 доллара за миллион токенов — это особенно важно для агентных систем, где одни и те же инструкции передаются сотни раз.
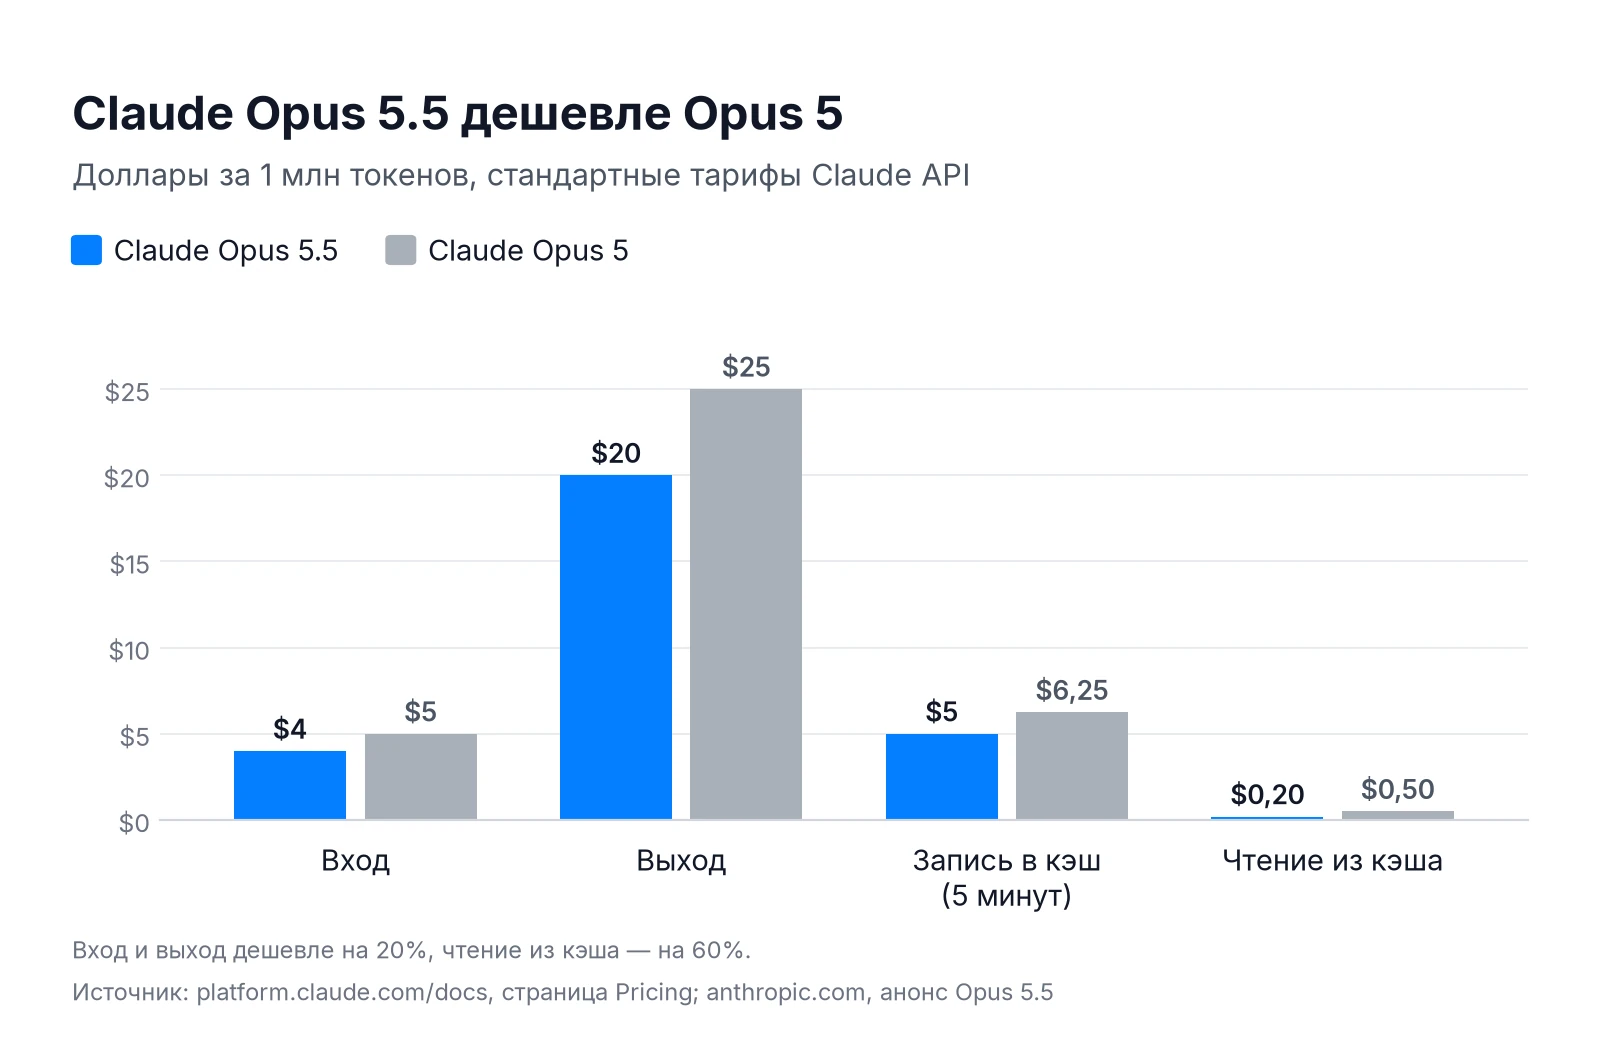
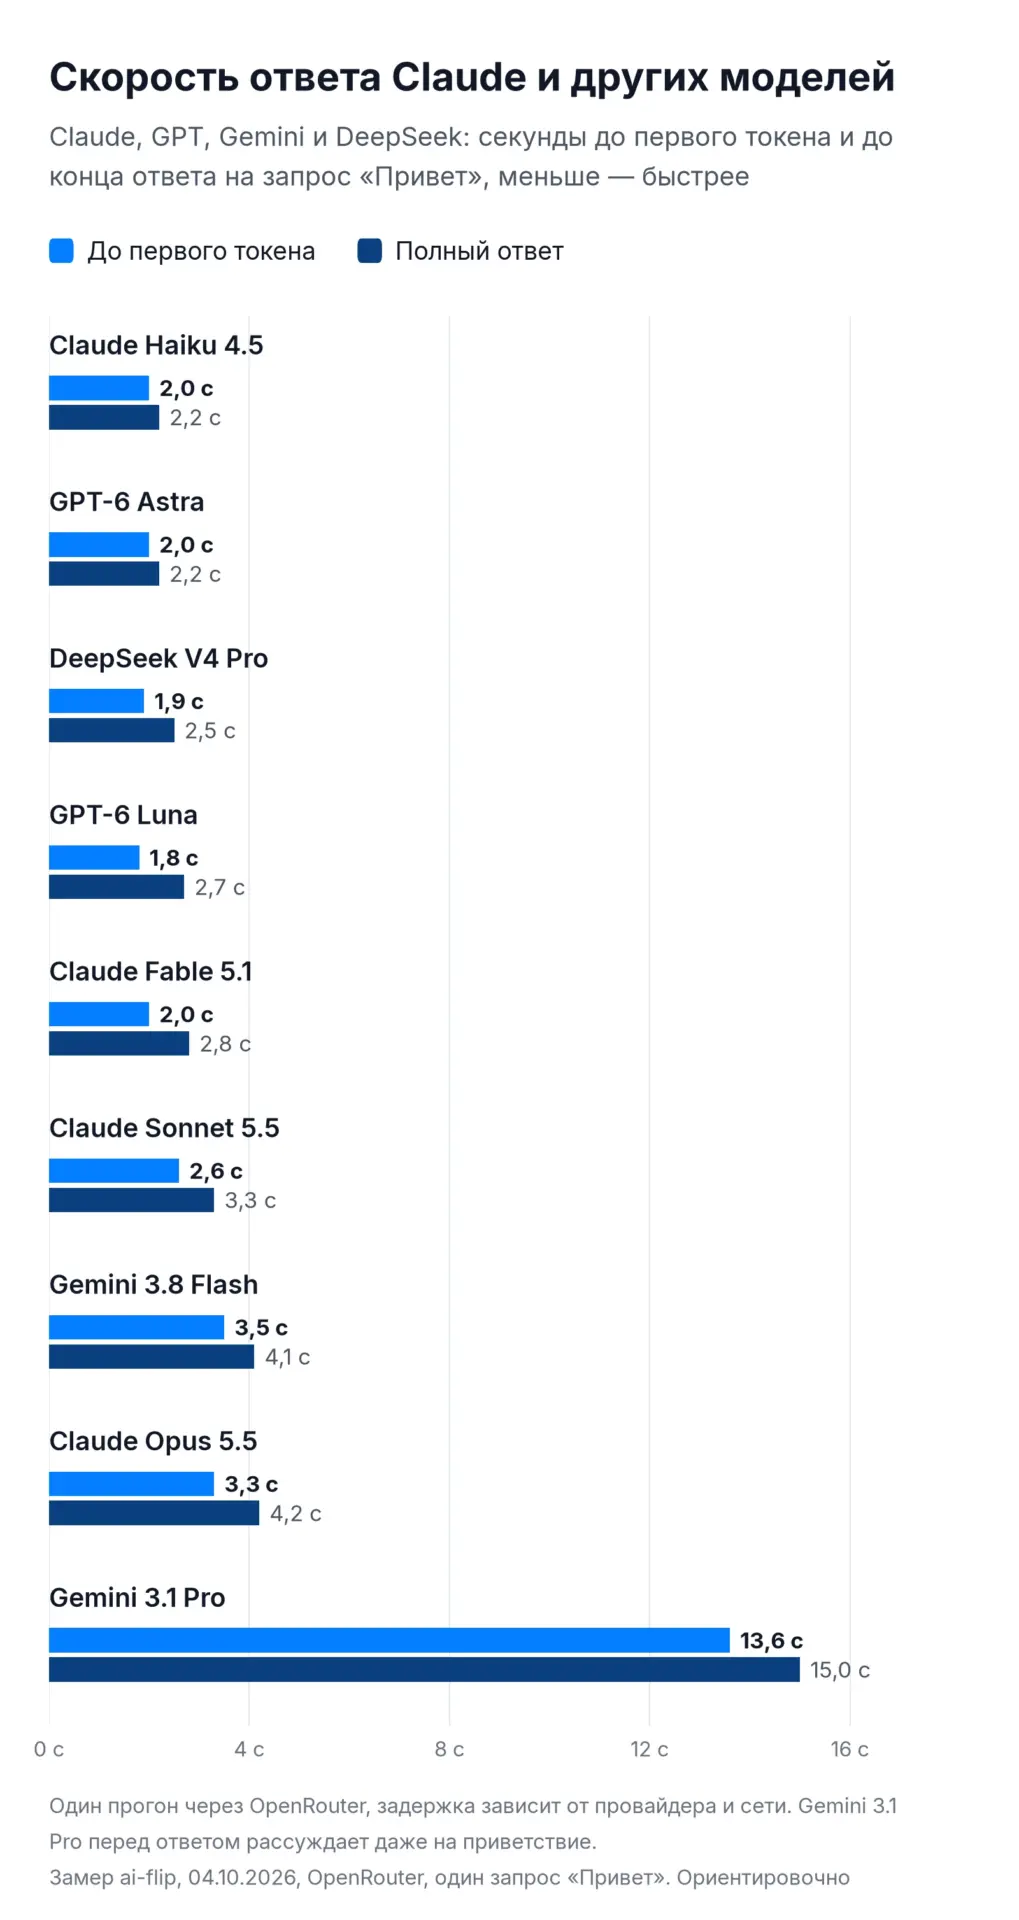
Скорость генерации выросла более чем на 30% по сравнению с Opus 5. В совокупности с меньшим числом токенов на типовые задачи суммарная экономия на реальных нагрузках достигает около 40%, что делает переход с Opus 5 на Opus 5.5 финансово обоснованным без потери качества.
Уровень Fable 5.1 при меньшей цене
Fable 5.1 — более крупная и дорогая модель Anthropic, ориентированная на предельные сценарии. Opus при меньшем размере обходит её на ряде агентных бенчмарков: Terminal-Bench, OSWorld и GDPval-AA. Разрыв по цене между ними существенный, поэтому для большинства корпоративных задач Opus 5.5 становится предпочтительным выбором.
Ниже — сравнительная таблица ключевых параметров трёх моделей:
| Параметр | Opus 5 | Opus 5.5 | Fable 5.1 |
|---|---|---|---|
| Вход, $ / 1M токенов | 5 | 4 | 10 |
| Выход, $ / 1M токенов | 25 | 20 | 50 |
| Чтение из кэша, $ / 1M | 0,50 | 0,20 | 0,25 |
| Скорость генерации | базовая | быстрее более чем на 30% | базовая |
| Terminal-Bench | н/д | лидер | ниже |
Возможности: программирование, агенты и работа со знаниями
Opus умеет вести агентное программирование, управлять компьютером и решать сложные бизнес-задачи на новом уровне точности: на Terminal-Bench она опередила как GPT-6 Astra, так и более крупную Fable. Это делает её наиболее производительной публично доступной моделью для автономных программных агентов.
Кодинг и миграции кода
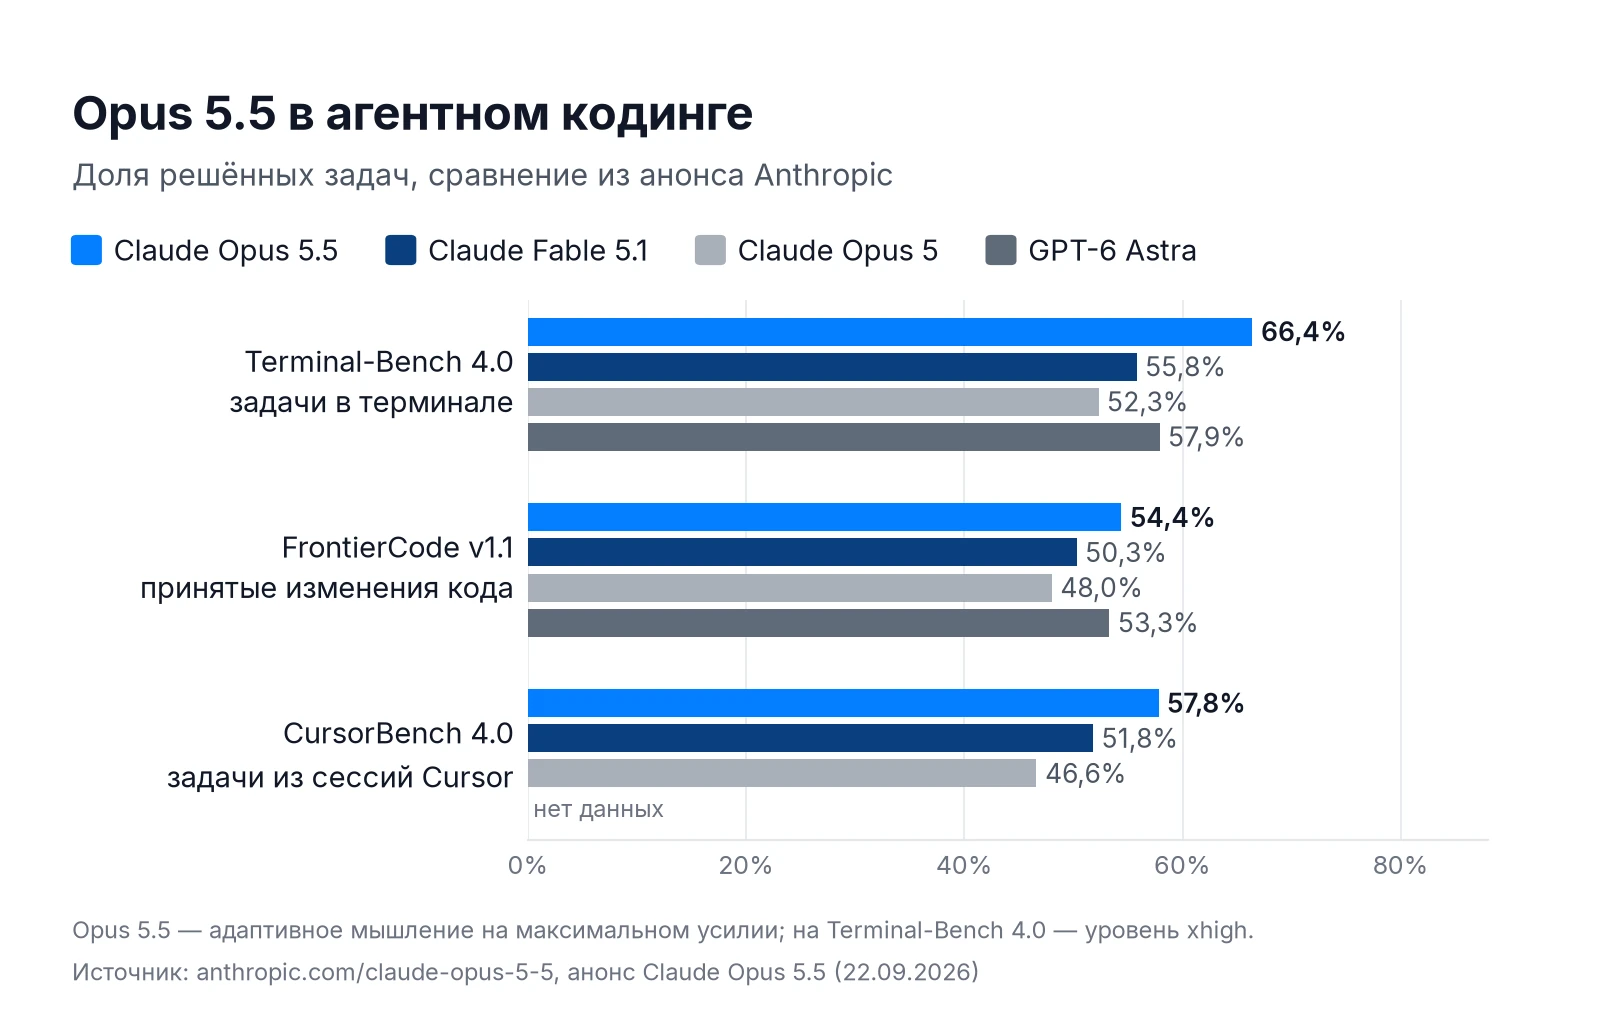
На бенчмарках агентного кодинга Opus 5.5 демонстрирует результаты, недостижимые для предыдущего поколения: Terminal-Bench 4.0 — 66,4%, FrontierCode v1.1 — 54,4%, CursorBench 4.0 — 57,8%. Для сравнения: GPT-6 Astra набирает 57,9% на Terminal-Bench, Fable 5.1 — 55,8%.
Практический масштаб этих цифр подтверждает реальный кейс: один тестировщик выполнил миграцию кодовой базы на 680 000 строк менее чем за день. Типичная инженерная команда потратила бы на это несколько недель. Opus 5.5 способна удерживать контекст всего проекта, вносить согласованные изменения и проверять результат без постоянного вмешательства человека.
Начать работу с агентным кодингом через API можно за несколько шагов:
- Получить API-ключ в личном кабинете Anthropic Console.
- Установить официальный SDK (Python или TypeScript).
- Указать
model="claude-opus-5-5"в запросе. - Передать системный промпт с описанием проекта и инструментами (bash, file-editor).
- Запустить агентный цикл с параметром
effort="max"для сложных задач.
Компьютерное управление и работа со знаниями
В задаче computer use на бенчмарке OSWorld 2.1 Opus 5.5 набирает 81,8%. Модель способна управлять браузером, работать с файловой системой и выполнять многошаговые GUI-задачи автономно.
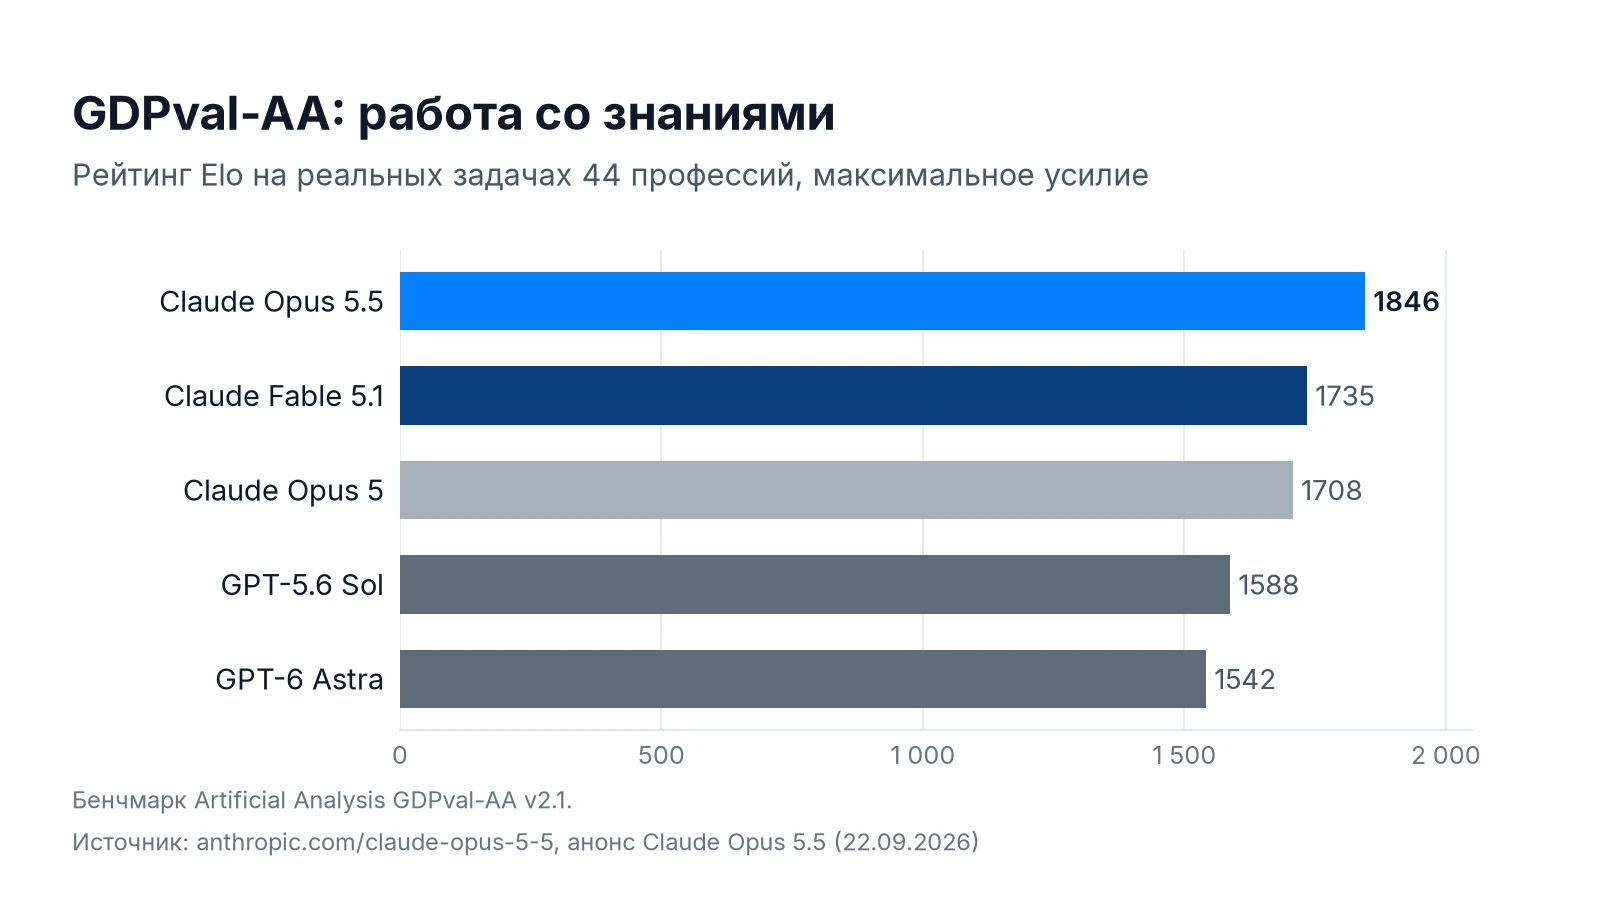
В работе со знаниями и финансовом анализе Опус набирает заметно больше очков на GDPval-AA, чем Fable. Стиль письма стал заметно менее «claudish»: модель выносит главное в начало ответа, избегает избыточных оговорок и форматирует результат под задачу, а не под демонстрацию рассуждений.
Доступны следующие режимы использования:
- Агентное программирование и код-ревью
- Управление компьютером через computer use API
- Финансовый анализ и работа с документами
- Обработка длинных контрактов и юридических текстов
- Бизнес-процессы с многошаговыми инструкциями
Технические характеристики и параметр effort
Opus имеет расширенное контекстное окно и управляется параметром effort: мышление включено всегда, отключить его нельзя, а идентификатор модели — claude-opus-5-5. Это радикально меняет подход к управлению качеством и стоимостью вывода.
Контекст и лимиты вывода
Контекстное окно составляет 1 000 000 токенов — достаточно для целых кодовых баз, обширных документов или длинных диалогов без усечения. Синхронный вывод имеет ограничение по токенам, но через Batch API лимит существенно выше — это важно для массовой обработки документов или параллельных агентных задач.
Model ID для всех API-вызовов — claude-opus-5-5. Модель доступна как в стандартном режиме, так и через Fast mode с повышенной ценой и заметно более высокой скоростью генерации.
Параметр effort и рассуждения
Adaptive thinking в Opus 5.5 включён постоянно и не отключается — модель всегда рассуждает перед ответом. Вместо бинарного переключателя разработчик теперь задаёт интенсивность через параметр effort: значения от минимального до "max", где максимальный уровень активирует развёрнутые цепочки рассуждений для сложных задач.
Даже на минимальных настройках effort модель справляется с большинством стандартных задач быстрее и дешевле. Для отладки кода или коротких аналитических вопросов минимальный effort даёт результат сопоставимого качества при заметно меньшем расходе токенов. Понять, нужна ли вам вообще такая мощность, можно и до API: сначала попробовать ИИ онлайн бесплатно в ограниченной версии на младших моделях.
Preserved Thinking и изменения API
Preserved Thinking — новый механизм, защищающий цепочку рассуждений модели от редактирования извне: блоки размышлений привязаны к конкретному диалогу и не могут быть изменены или переиспользованы в другом контексте. Это касается аккаунтов, созданных после 31 августа 2026 года.
Ряд изменений API нарушает обратную совместимость: принудительные вызовы инструментов теперь могут возвращать ошибки вместо молчаливого игнорирования, старый инструмент computer_20251124 отклоняется и требует замены на актуальную версию. Перед миграцией с Opus 5 стоит пройтись по таблице breaking changes в официальной документации.
| Параметр | Значение |
|---|---|
| Контекстное окно | 1 000 000 токенов |
| Синхронный вывод | до 128 000 токенов |
| Batch API вывод | лимит выше, чем у синхронного вывода |
| Model ID | claude-opus-5-5 |
| Параметр управления | effort (min → max) |
| Preserved Thinking | с 31.08.2026 |
Сколько стоит Claude Opus 5.5
Claude Opus 5.5 стоит 4 доллара за миллион входных и 20 долларов за миллион выходных токенов, причём за вывод — 20 долларов за млн токенов — это на 20% ниже, чем у Opus 5. Чтение из кэша обходится всего в 0,20 доллара за миллион токенов, что делает модель особенно привлекательной для агентных систем с повторяющимися системными промптами.
Тарифы за токены
Полная тарифная сетка Opus 5.5:
- Входные токены — цена уточняется в официальной документации
- Выходные токены — 20 $ / 1M
- Запись в кэш — 5 $ / 1M
- Чтение из кэша — 0,20 $ / 1M
- Fast mode: повышенная цена за вход и выход, скорость заметно выше стандартной
Актуальные цены на токены Claude позволяют сравнить стоимость в контексте других моделей рынка. Fast mode удваивает цену, но оправдан в сценариях, где задержка критична: интерактивные агенты, диалоговые интерфейсы в реальном времени.
Реальная стоимость задач
На практике экономия ~40% достигается не только за счёт снижения прайса, но и за счёт меньшего числа токенов на типовые задачи: Opus 5.5 даёт более точные и короткие ответы, реже требует повторного вызова и лучше использует кэш при агентных сценариях.
Для сравнения: в анонсе Anthropic Opus 5.5 на CursorBench при уровне effort по умолчанию набирает 52,5% и обходит лучший результат GPT-5.6 Sol (41,7%) на 11 пунктов примерно за треть его стоимости задачи. При сложных задачах, где качество Opus 5.5 позволяет избежать итераций, итоговая стоимость решения может оказаться ниже, чем у более дешёвой модели с худшей точностью.
Бенчмарки и сравнение с конкурентами
Opus 5.5 в бенчмарках опережает GPT-6 Astra и Fable 5.1 в агентном кодинге, управлении компьютером и работе со знаниями: Claude Opus 5.5 набрала на Terminal-Bench 4.0 66,4% против 57,9% у GPT-6 Astra и 55,8% у Fable 5.1. Это делает её лидером среди публично оцениваемых моделей в классе агентных задач.
Полная картина по ключевым тестам:
- Terminal-Bench 4.0: Opus 5.5 — 66,4%, GPT-6 Astra — 57,9%, Fable 5.1 — 55,8%
- FrontierCode: Opus показала высокий результат
- CursorBench 4.0: Opus 5.5 — 57,8%
- OSWorld 2.1 (computer use): Opus 5.5 — 81,8%
- GDPval-AA (знания): Opus опережает Fable по очкам Elo
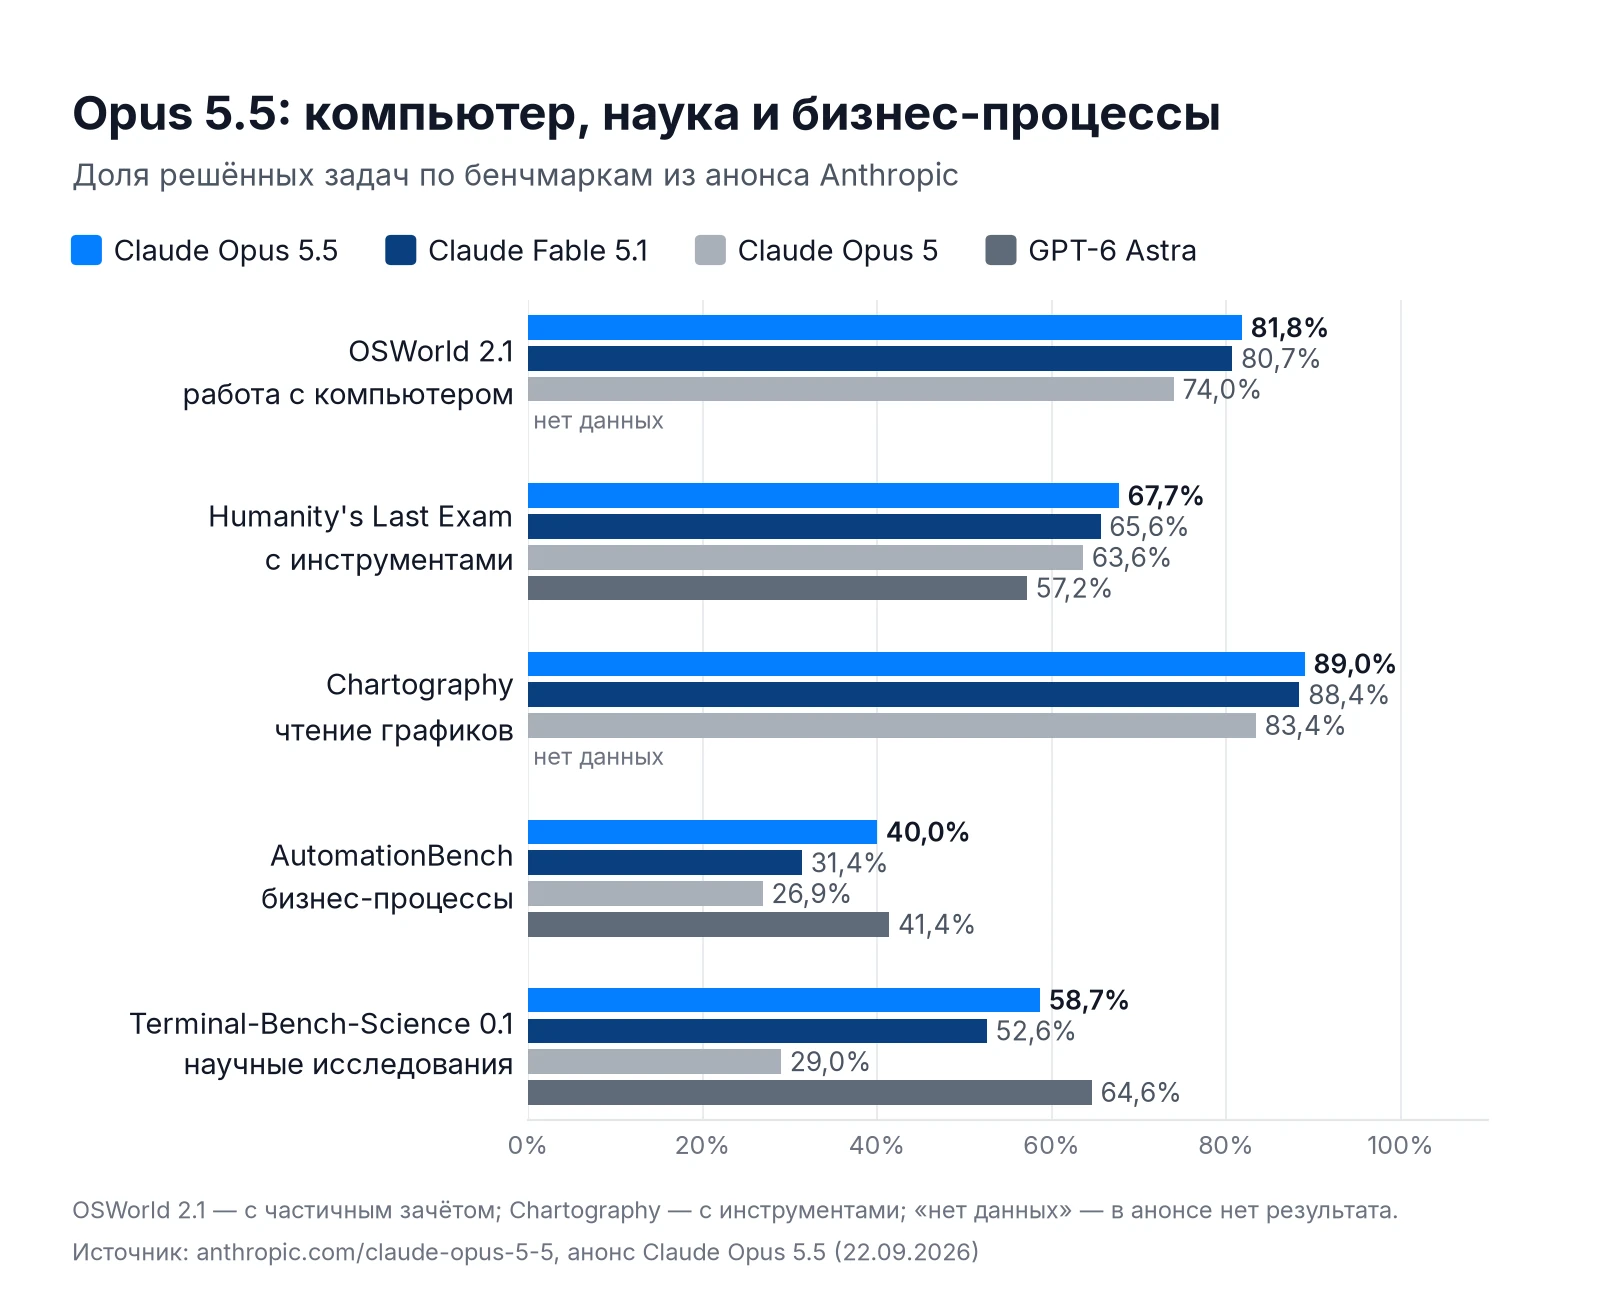
Подробный сравнения флагманов сентября 2026 показывает контекст этих цифр на фоне всей когорты моделей, вышедших в одном окне.
Разрыв между Opus 5.5 и Fable 5.1 в бенчмарках выглядит весомо, но сам Anthropic сделал важную оговорку: на текущем уровне возможностей бенчмарки хуже отражают реальную разницу в качестве, чем раньше. На практике разрыв с Fable уже, чем показывают числа, — особенно в задачах с нечётким успехом, где обе модели дают приемлемый результат. Для большинства корпоративных сценариев выбор в пользу Opus 5.5 определяется ценой, а не принципиальным превосходством по качеству.
Безопасность и выравнивание Opus 5.5
Opus 5.5 — самая безопасная модель Anthropic по результатам аудита. В автоматизированном аудите поведения она показала лучший результат среди всех протестированных моделей компании, а число попыток обхода защитных границ снизилось примерно на 85% по сравнению с Opus 5 или Claude Mythos 5.1. Claude Opus 5.5 показала лучший результат в аудите безопасности Anthropic — и это не маркетинговое заявление, а цифра из методологически воспроизводимого теста.
Anthropic подчёркивает, что безопасность — не ограничение возможностей, а их условие. Дарио Амодеи публично связал этот релиз с тезисом о том, что прогресс в безопасности должен опережать прогресс в возможностях или идти с ним в ногу.
One tester completed a 680,000-line code migration in less than a day—work that would have taken an engineering team weeks.Anthropic
Устойчивость к prompt injection выросла. На атаках через prompt injection Opus 5.5 не уступает Opus 5 или превосходит его во всех проверенных условиях, включая программирование, работу с инструментами, управление компьютером и браузером. В тесте компании Gray Swan, которая занимается безопасностью ИИ, у Opus 5.5 вместе с Fable 5.1 наименьшая доля успешных атак среди всех протестированных моделей.
Барьеры по кибербезопасности, биологии и дистилляции — отдельный механизм. Opus 5.5 — первая модель Opus, которая выходит с барьерами того же класса, что у Fable 5.1: большинство задач по кибербезопасности прозрачно перенаправляется на Opus 4.8, в биологии действуют те же ограничения, что у Fable 5.1, а от дистилляции защищает Preserved Thinking.
Верифицированный доступ для чувствительных областей — отдельная программа. Anthropic ввела две программы верификации: Life Sciences Verification для работы с биомедицинскими данными и Cyber Verification для специалистов по кибербезопасности. Это позволяет легитимным пользователям получить доступ к возможностям, заблокированным по умолчанию, при условии подтверждения организации и целей использования.
Где доступна и как начать пользоваться из России
Claude Opus 5.5 доступна в Claude API и на облаках AWS, Google Cloud и Microsoft Azure: Claude Opus 5.5 доступна на AWS Bedrock, Google Cloud Vertex AI и Microsoft Azure AI Foundry с первого дня релиза. Это стандартная для Anthropic мультиплатформенная стратегия, позволяющая интегрировать модель в инфраструктуру любого крупного облака без привязки к одному провайдеру.
Платформы и доступ
Для работы с моделью доступны несколько путей: напрямую через Claude API (api.anthropic.com), через AWS Bedrock, через Google Cloud Vertex AI и через Microsoft Azure AI Foundry. Во всех случаях model ID — claude-opus-5-5.
Прямой API даёт максимальный контроль над параметрами, включая effort, preserved_thinking и Batch API. Облачные провайдеры добавляют корпоративные инструменты: контроль расходов, VPC-изоляцию, аудит логов и интеграцию с IAM-политиками организации.
Особенности доступа из РФ
Anthropic не обслуживает Россию напрямую: регистрация аккаунта с российским номером телефона или российской платёжной картой недоступна, а прямая оплата из РФ невозможна. Это не связано с техническими ограничениями — только с политикой санкционного комплаенса компании.
Обходные схемы — зарубежный аккаунт AWS, GCP или Azure, оплата иностранной картой или через юрлицо за рубежом, посредники, которые перепродают доступ, — нарушают условия Anthropic: с 4 сентября 2025 года компания закрыла доступ и организациям под контролем владельцев из неподдерживаемых стран. Пользоваться Claude без VPN и с оплатой в рублях можно через агрегаторы нейросетей, например AI-Flip.
Sonnet 5.5 и Haiku 5.5
Anthropic анонсировала выпуск моделей Claude Sonnet 5.5 и Claude Haiku 5.5 в течение нескольких недель после релиза Opus 5.5. Обе модели получат те же улучшения в скорости, эффективности токенов и безопасности — включая новый параметр effort и Preserved Thinking.
Sonnet 5.5 закроет большинство корпоративных сценариев с меньшей стоимостью, чем Opus, а Haiku 5.5 — высокочастотные задачи классификации, маршрутизации и кратких ответов. Для команд, которые сегодня выбирают между Opus 5.5 и Fable 5.1, появление Sonnet 5.5 может стать поводом пересмотреть архитектуру: часть задач, которые сейчас требуют Opus, переедет на более дешёвый уровень.
FAQ
Можно ли отключить рассуждения в Claude Opus 5.5?
Нет. В Opus 5.5 адаптивное мышление включено всегда и не отключается; глубину рассуждений настраивают параметром effort.
Какой model ID у Claude Opus 5.5?
Официальный идентификатор модели — claude-opus-5-5, он используется в запросах к Claude API и совместимым облачным платформам.
Насколько быстрее Opus 5.5 генерирует ответы по сравнению с предшественником?
Anthropic улучшила скорость синхронного вывода в Opus 5.5, хотя конкретные цифры в официальных материалах не раскрываются. При стандартном режиме без глубокого reasoning ответы заметно быстрее, чем у Opus 5.
Выйдут ли Sonnet 5.5 и Haiku 5.5?
Anthropic официально анонсировала Sonnet 5.5 и Haiku 5.5 как ближайшие релизы, поэтому строить прогнозы на основе имеющихся данных нельзя. Следите за официальными объявлениями компании.
Стала ли Opus 5.5 писать более естественно и «по-человечески»?
Да, в Opus 5.5 улучшена выразительность и естественность текста по сравнению с Opus 5. Модель лучше адаптирует тон под контекст и реже воспроизводит шаблонные обороты.
Opus 5.5 лучше GPT-6 Astra?
На Terminal-Bench 4.0 Opus 5.5 набрала 66,4% против 57,9% у GPT-6 Astra, что делает её лидером этого бенчмарка. По безопасности Opus 5.5 также показала лучший результат среди протестированных моделей.
Сколько стоит Claude Opus 5.5?
Входные токены дешевле выходных; актуальные цены уточняйте в официальной документации. Чтение из кэша обходится в 0,20 доллара за миллион токенов — на 60% дешевле, чем у Opus 5.
Насколько безопасна Claude Opus 5.5?
Opus 5.5 показала лучший результат в аудите поведения среди всех протестированных моделей Anthropic. Число попыток обхода защитных границ снизилось примерно на 85% по сравнению с Opus 5.
-
Маршрут от Claude привёл подростка на «Вдоводел»
![Подросток в синей куртке и шлеме радостно смотрит маршрут в телефоне на вершине горы над городом]()
16-летний Брайс из Ванкувера проложил с Claude новый для себя маршрут на гору Краун. ![Подросток с рюкзаком неуверенно пробирается между валунами к крутому гребню]()
Разметки не было: вместо кулуара он попал на гребень «Вдоводел», куда ходят с верёвками. ![Испуганный подросток прижался к отвесной скале на узком уступе и звонит по телефону]()
Брайс застрял на уступе шириной около полутора метров: сзади обрыв, впереди почти отвесная стена. ![Спасатель спускается по верёвке к подростку на уступе, рядом вертолёт]()
Вертолёт не мог подойти к скале: спасатель спустился к Брайсу по верёвке, и его подняли на борт. ![Подросток в спасательном одеяле сидит у тропы с бумажной картой, рядом компас]()
Брайс винит себя, но тропы через ИИ больше не прокладывает. Спасатель: «Claude никогда не был в этих местах». -
950 агентов Claude нашли в ДНК вирусов загадочную систему
![Учёная в лаборатории смотрит на монитор со спиралями ДНК]()
Anthropic поручила Claude найти в огромной базе ДНК необычные ферменты. ![Учёная с планшетом смотрит на стену из сотен мониторов с ДНК]()
Около 950 агентов за 21 час собрали больше 200 тысяч ферментов и написали 20 отчётов. ![Учёная взволнованно показывает на повторяющийся узор в цепочке ДНК на экране]()
Один агент «на глаз» заметил рядом с ферментом повторы, как у CRISPR. Систему назвали ART. ![Учёная поднимает пробирку к свету, коллега задумчиво смотрит рядом]()
Что она делает, пока неизвестно. Пионер CRISPR Фэн Чжан назвал находку «по-настоящему интригующей». -
Anthropic запретила издеваться над Claude
![Женщина в очках сердито кричит на ноутбук и стучит кулаком по столу]()
Anthropic запретила «длительное и бессмысленное» жестокое обращение с Claude. ![Женщина спокойно спорит, разводя рукой перед ноутбуком]()
Речь о крайних случаях. Раздражение, споры, мрачные сюжеты и тесты под запрет не попадают. ![Удивлённая женщина смотрит на ноутбук со значком закрытой двери на экране]()
Главная защита прежняя: Claude сам завершает такой диалог. ![Женщина прикрепляет к доске календарь с обведённым днём]()
Правила действуют с 12 ноября. За нарушения доступ могут ограничить или закрыть. -
ИИ-видео с погибшим в суде: срок назначат заново
![Женщина в зале суда показывает планшет с лицом мужчины]()
В Аризоне сестра погибшего показала в суде видео, где ИИ-аватар брата прощает убийцу. ![Растроганный судья с рукой на груди за судейским столом]()
Судья дал максимальные 10,5 года и сказал, что ему «понравилось это видео». ![Три судьи апелляционного суда изучают документы]()
Апелляционный суд счёл приговор несправедливым: видео «не отражает реальных событий». ![Женщина читает своё заявление с листов за трибуной, планшет выключен]()
Срок назначат заново, а свой текст сестра прочитает сама, без видео. -
Журналист выпустил ИИ-песню от имени чужой группы
![Журналист в наушниках с хитрой улыбкой работает за ноутбуком]()
Журналист 404 Media сгенерировал песню в Udio по простому запросу. ![Трое музыкантов панк-группы в шоке смотрят в телефон]()
Трек вышел на подтверждённой странице панк-группы Lathe of Heaven в Spotify без ведома музыкантов. ![Журналист удивлённо разводит руками, вокруг висят значки музыкальных сервисов]()
Песня попала и в Apple Music, Tidal и Amazon Music — через давнюю лазейку в дистрибуции. ![Довольный мошенник ловит монеты, сыплющиеся из наушников, слушательница расстроена]()
Так мошенники зарабатывают на чужой славе. Площадки и дистрибьюторы ответственность не берут. -
Нейросеть научилась играть в «Точки» и обыгрывает автора
![Разработчик держит тетрадь в клетку с партией в точки]()
Разработчик учил нейросеть игре в «Точки» из школьной тетради — по примеру AlphaZero. ![Разработчик ночью смотрит на два монитора с партиями в точки]()
Сеть играла сама с собой: 30 поколений за полтора месяца, однажды девять пришлось выбросить. ![Разработчик радостно подпрыгивает перед монитором с выигранной партией]()
Ученик обыграл учителя, только когда поиск подняли с 800 до 1600 симуляций на ход. ![Разработчик смеётся, проиграв нейросети партию в точки]()
Теперь сложный уровень игры Just Dots стабильно обыгрывает автора на поле 20×20.
























