 FlipИИ чат
Ещё
Нейросети
-
Gemini
Gemini
-
Z.ai
Z.ai
-
ChatGPT
ChatGPT
-
DeepSeek
DeepSeek
-
Claude
Claude
-
Jev
Jev
-
Perplexity
Perplexity
-
OpenAI
OpenAI
-
Kimi
Kimi
-
Qwen
Qwen
-
Grok
Grok
-
Все модели
Все модели
-
Задачи
Задачи





Terminal-Bench-Science — бенчмарк научных ИИ-агентов

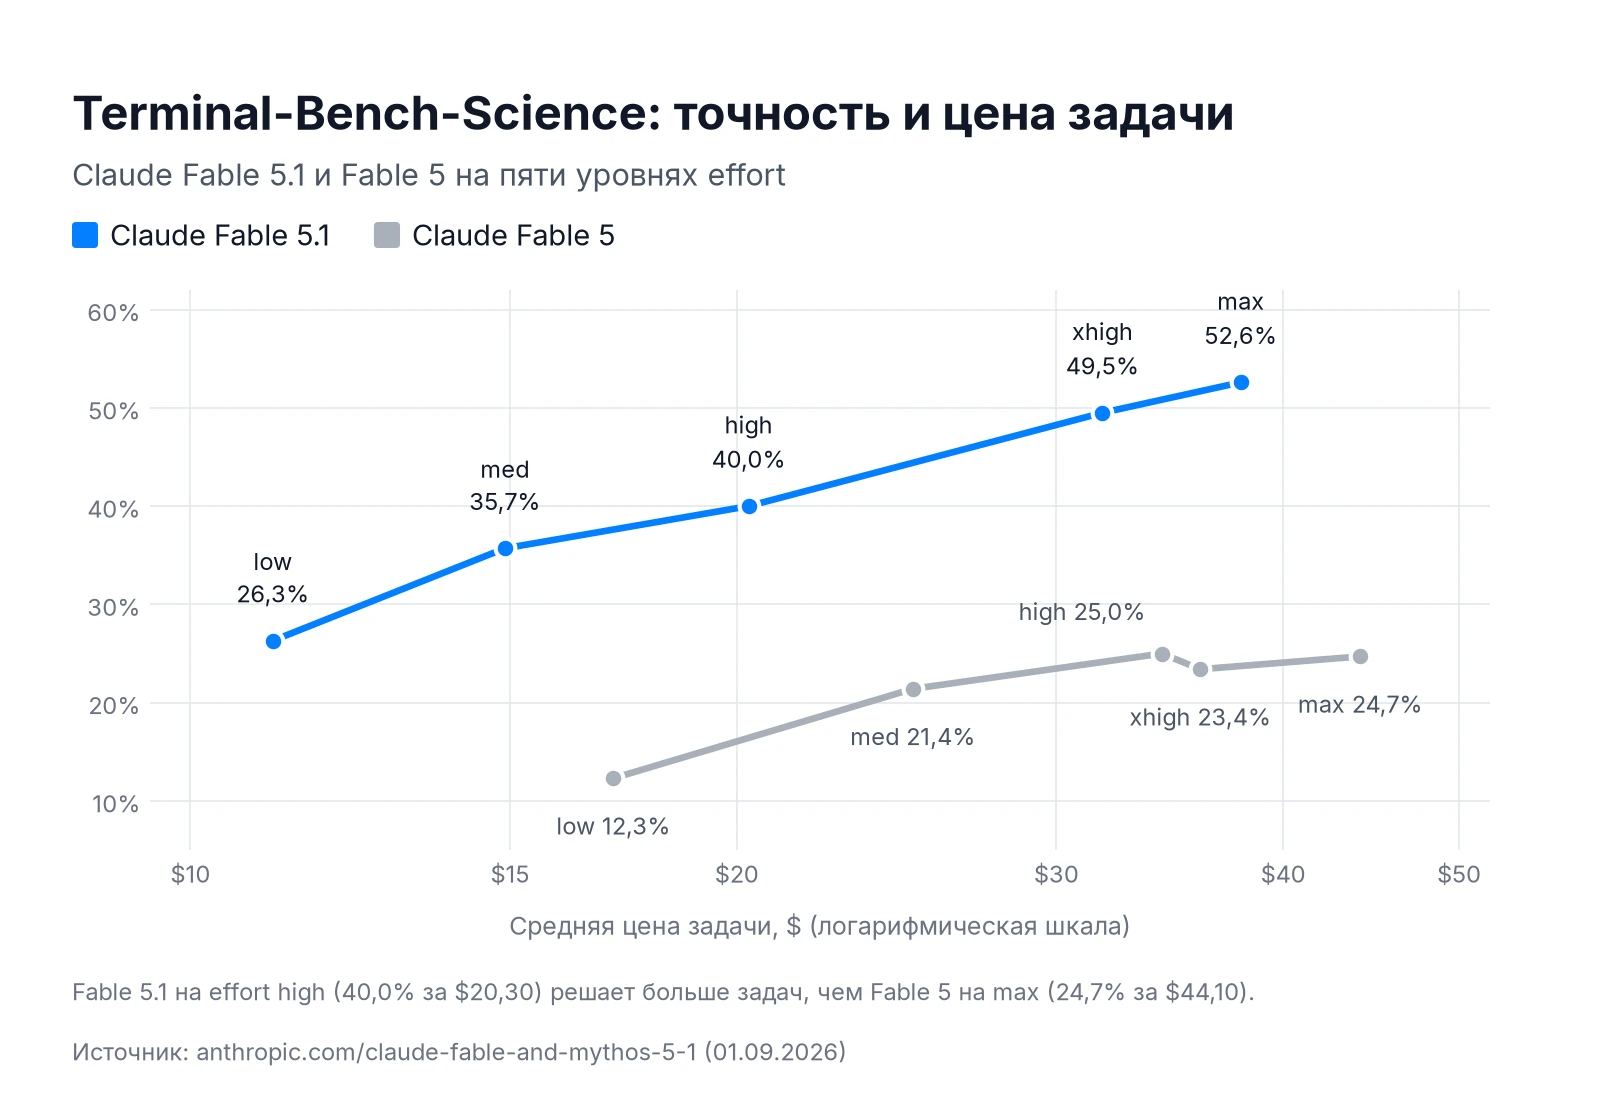
Terminal-Bench-Science 0.1 — агентный бенчмарк, в котором модель работает в реальном терминале и решает задачи из области научных исследований. Согласно анонсу Anthropic, Claude Fable 5.1 набрала 52.6% — более чем вдвое превысив результат предшественника. Это та же базовая модель, что и Claude Mythos 5.1, но цифры бенчмарка Anthropic публикует для Fable 5.1. Как устроено всё семейство и что умеет Claude нейросеть за пределами науки, — в общем обзоре.
Что такое Terminal-Bench-Science
Terminal-Bench-Science отличается от классических тестов на знания: агент не отвечает на вопросы, а выполняет многошаговые научные задания в терминале — пишет код, запускает эксперименты, анализирует данные и интерпретирует результаты. Публичный лидерборд считает по 3 попытки на задачу в harness Claude Code; воспроизведение Anthropic даёт несколько иные цифры — расхождение укладывается в пределы шума (±3.5–4.5 пп на модель).
Результаты моделей
| Модель | Anthropic (воспроизведение) | Публичный лидерборд |
|---|---|---|
| Fable 5.1 | 52.6% | — |
| Opus 5 | 29.0% | 30.0% |
| Fable 5 | 24.7% | 21.4% |
| GPT-5.6 Sol | 22.4% | — |
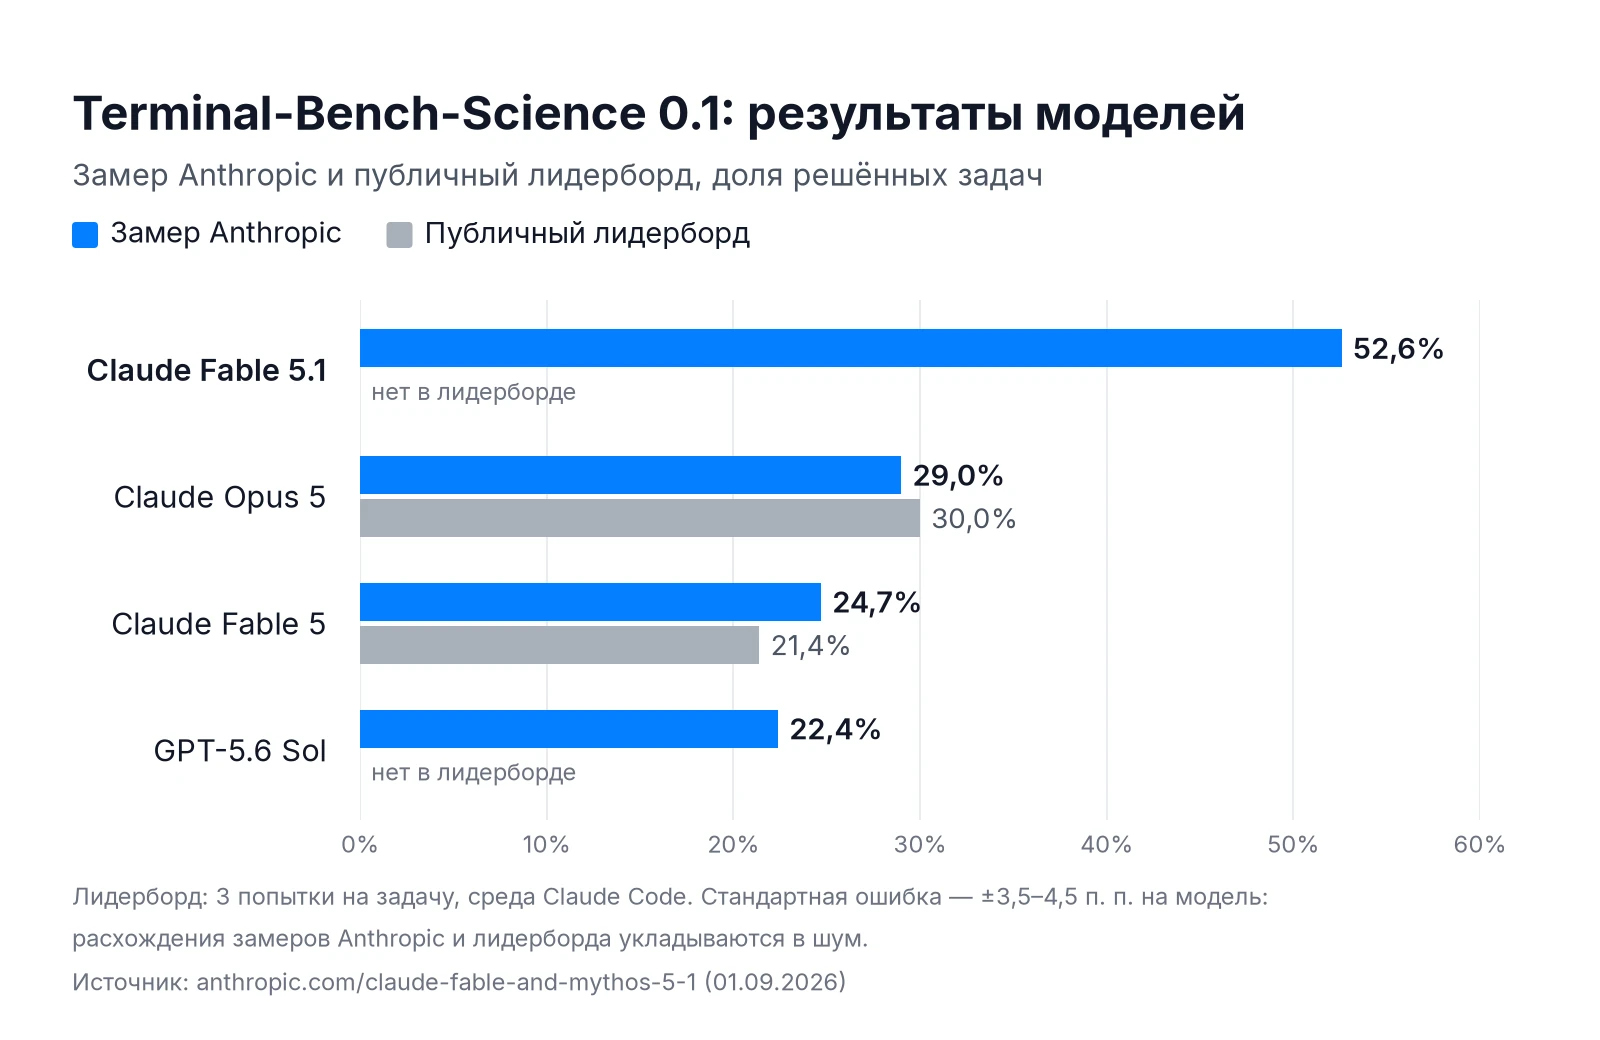
Прирост к Fable 5 — более чем двукратный: 52.6% против 24.7%. Такой скачок между поколениями редко встречается в агентных бенчмарках.
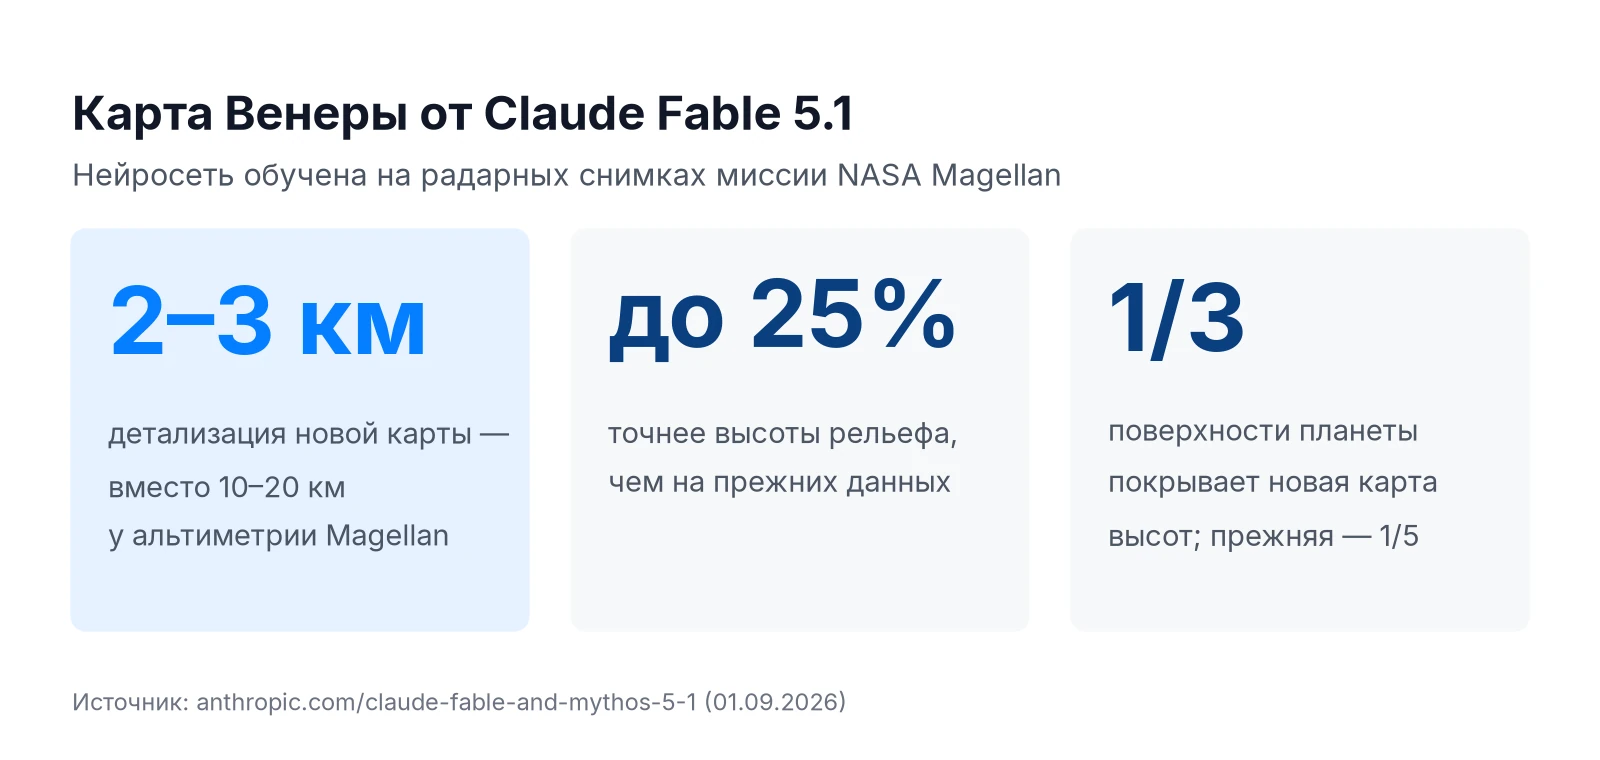
Мы обнаружили, что Claude Fable 5.1 способна обучить нейронную сеть и построить карту высот трети поверхности Венеры по радарным снимкам миссии NASA Magellan.Anthropic System Card — Fable 5.1 / Mythos 5.1
Контекст: другие бенчмарки Fable 5.1
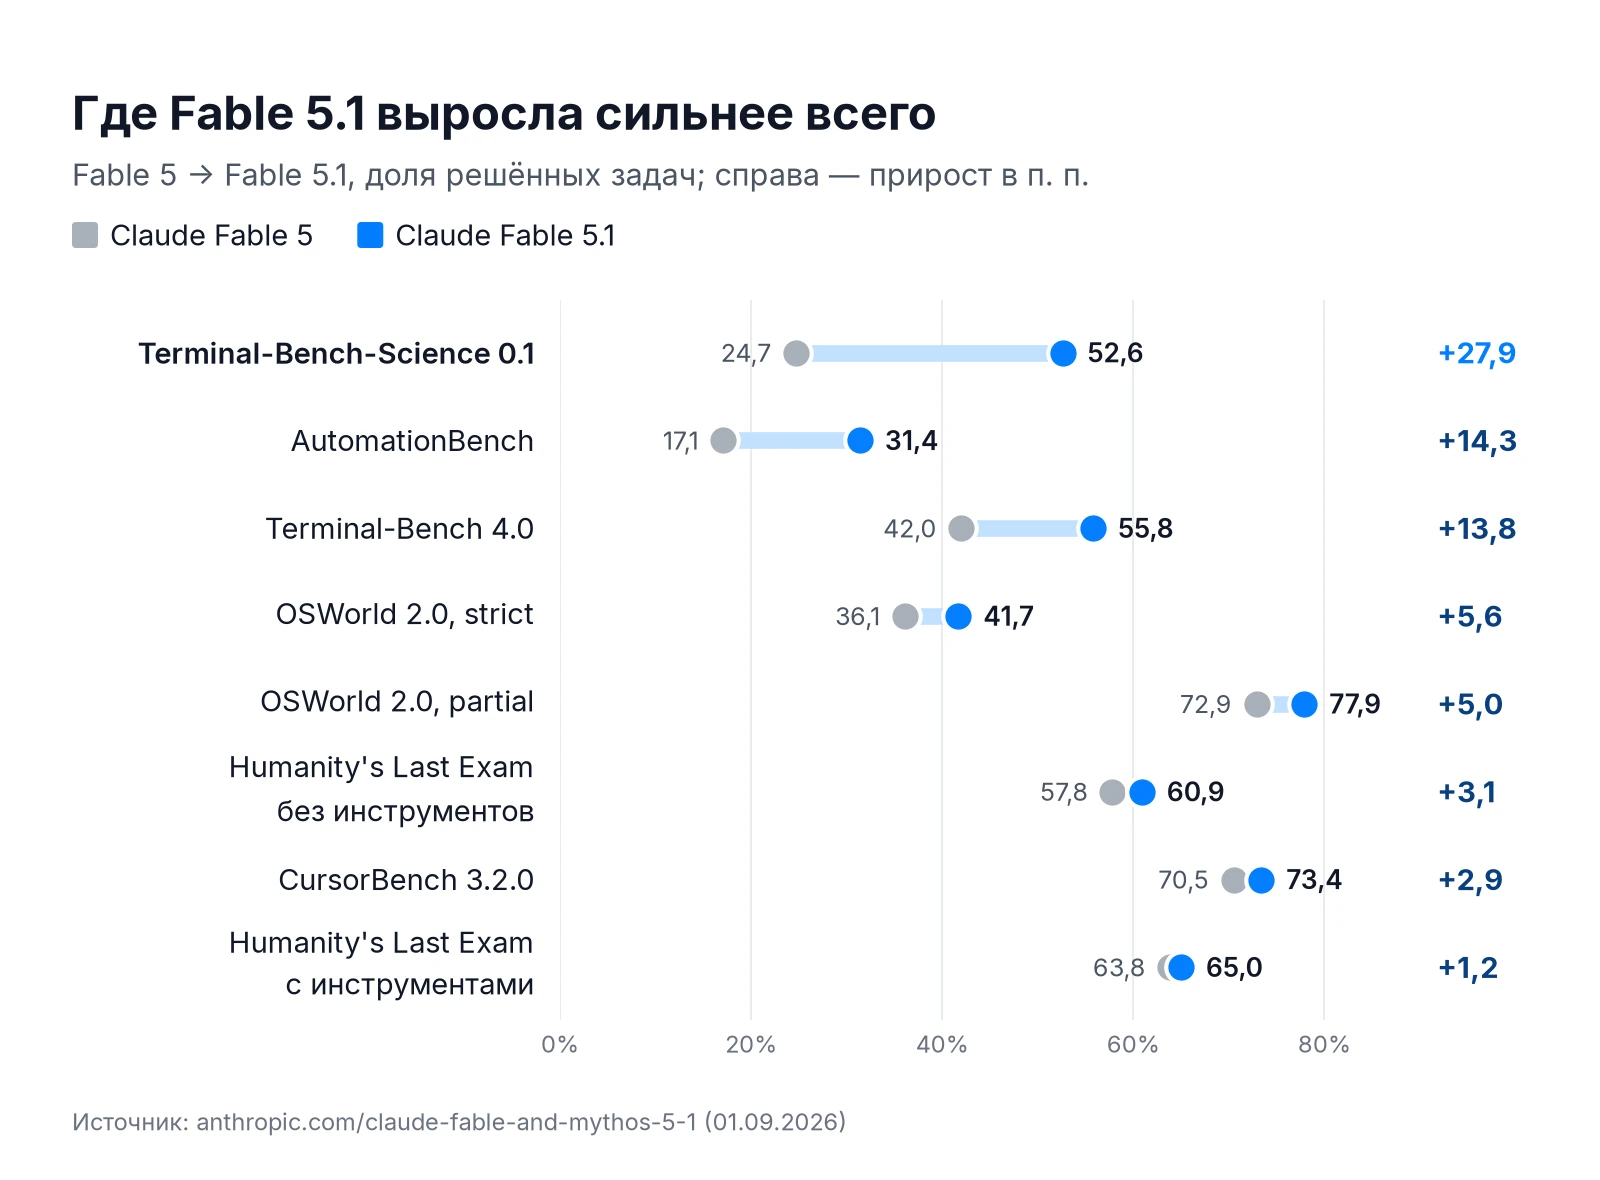
Terminal-Bench-Science — один из нескольких агентных тестов той же модели:
| Бенчмарк | Fable 5.1 |
|---|---|
| Terminal-Bench-Science 0.1 | 52.6% |
| Terminal-Bench 4.0 (кодирование) | 55.8% |
| CursorBench 3.2.0 | 73.4% |
| Humanity’s Last Exam (с инструментами) | 65.0% |
| OSWorld 2.0 (strict / partial) | 41.7% / 77.9% |
| AutomationBench | 31.4% |
| GDPval-AA v2 | 1853 |
Собственная опубликованная цифра Mythos 5.1 — 60.9% на Terminal-Bench 4.0.
Разрыв между научным (52.6%) и кодовым (55.8%) бенчмарками Fable 5.1 объясняется природой задач: научные задания требуют не только кода, но и доменных знаний в физике, биологии, химии. Отвечать на вопросы по химии в окне, где открыт ИИ чат, модели умеют давно; сложнее превращать эти знания в рабочий код в терминале.
Смежная верификационная программа Cyber Verification Program оценивает применение тех же научных способностей в условиях повышенных требований к безопасности.
Как читать результаты
Пять правил для корректной интерпретации:
- Сравнивайте только одну версию бенчмарка — TBS 0.1 несопоставим с будущими версиями.
- Учитывайте ошибку ±4.5 пп: разница менее 5 пунктов между моделями может быть шумом.
- Различайте harness: публичный лидерборд и воспроизведение Anthropic — разные методологии.
- Если ваш кейс — биоинформатика или численные методы, TBS ближе к реальности, чем бенчмарки на кодирование.
- Актуальные данные — на странице Claude Mythos; лидерборд обновляется с выходом новых моделей.
Responsible Scaling Policy Anthropic определяет, при каких пороговых значениях таких бенчмарков модель требует дополнительной оценки безопасности перед выпуском.
FAQ
Что такое Terminal-Bench-Science?
Terminal-Bench-Science 0.1 — агентный бенчмарк, в котором языковая модель работает в терминале над многошаговыми научными задачами: анализ данных, запуск кода, интерпретация результатов.
Какой результат показали Claude Fable 5.1 и Mythos 5.1?
На Terminal-Bench-Science Fable 5.1 набрала 52.6% — более чем вдвое выше Fable 5 (24.7%). Для Mythos 5.1 Anthropic публикует 60.9% на Terminal-Bench 4.0. Это один из крупнейших межпоколенческих приростов в агентных научных бенчмарках.
Чем публичный лидерборд отличается от воспроизведения Anthropic?
Публичный лидерборд считает по 3 попытки на задачу в harness Claude Code. Воспроизведение Anthropic использует собственную методологию. Расхождения укладываются в пределы ошибки ±3.5–4.5 пп.
Как Terminal-Bench-Science соотносится с Terminal-Bench 4.0?
Terminal-Bench 4.0 тестирует агентное кодирование (Fable 5.1 — 55.8%, Mythos 5.1 — 60.9%), TBS — научные задачи (Fable 5.1 — 52.6%). Разрыв отражает дополнительную сложность доменных знаний.
Что такое стандартная ошибка бенчмарка?
±3.5–4.5 процентных пункта на модель. Разница менее 5 пунктов между моделями может оказаться в пределах шума.
Влияет ли Terminal-Bench-Science на политику безопасности Anthropic?
Да. Пороговые значения агентных бенчмарков учитываются в Responsible Scaling Policy при решении о дополнительной оценке безопасности модели перед выпуском.
-
Маршрут от Claude привёл подростка на «Вдоводел»
![Подросток в синей куртке и шлеме радостно смотрит маршрут в телефоне на вершине горы над городом]()
16-летний Брайс из Ванкувера проложил с Claude новый для себя маршрут на гору Краун. ![Подросток с рюкзаком неуверенно пробирается между валунами к крутому гребню]()
Разметки не было: вместо кулуара он попал на гребень «Вдоводел», куда ходят с верёвками. ![Испуганный подросток прижался к отвесной скале на узком уступе и звонит по телефону]()
Брайс застрял на уступе шириной около полутора метров: сзади обрыв, впереди почти отвесная стена. ![Спасатель спускается по верёвке к подростку на уступе, рядом вертолёт]()
Вертолёт не мог подойти к скале: спасатель спустился к Брайсу по верёвке, и его подняли на борт. ![Подросток в спасательном одеяле сидит у тропы с бумажной картой, рядом компас]()
Брайс винит себя, но тропы через ИИ больше не прокладывает. Спасатель: «Claude никогда не был в этих местах». -
950 агентов Claude нашли в ДНК вирусов загадочную систему
![Учёная в лаборатории смотрит на монитор со спиралями ДНК]()
Anthropic поручила Claude найти в огромной базе ДНК необычные ферменты. ![Учёная с планшетом смотрит на стену из сотен мониторов с ДНК]()
Около 950 агентов за 21 час собрали больше 200 тысяч ферментов и написали 20 отчётов. ![Учёная взволнованно показывает на повторяющийся узор в цепочке ДНК на экране]()
Один агент «на глаз» заметил рядом с ферментом повторы, как у CRISPR. Систему назвали ART. ![Учёная поднимает пробирку к свету, коллега задумчиво смотрит рядом]()
Что она делает, пока неизвестно. Пионер CRISPR Фэн Чжан назвал находку «по-настоящему интригующей». -
Anthropic запретила издеваться над Claude
![Женщина в очках сердито кричит на ноутбук и стучит кулаком по столу]()
Anthropic запретила «длительное и бессмысленное» жестокое обращение с Claude. ![Женщина спокойно спорит, разводя рукой перед ноутбуком]()
Речь о крайних случаях. Раздражение, споры, мрачные сюжеты и тесты под запрет не попадают. ![Удивлённая женщина смотрит на ноутбук со значком закрытой двери на экране]()
Главная защита прежняя: Claude сам завершает такой диалог. ![Женщина прикрепляет к доске календарь с обведённым днём]()
Правила действуют с 12 ноября. За нарушения доступ могут ограничить или закрыть. -
ИИ-видео с погибшим в суде: срок назначат заново
![Женщина в зале суда показывает планшет с лицом мужчины]()
В Аризоне сестра погибшего показала в суде видео, где ИИ-аватар брата прощает убийцу. ![Растроганный судья с рукой на груди за судейским столом]()
Судья дал максимальные 10,5 года и сказал, что ему «понравилось это видео». ![Три судьи апелляционного суда изучают документы]()
Апелляционный суд счёл приговор несправедливым: видео «не отражает реальных событий». ![Женщина читает своё заявление с листов за трибуной, планшет выключен]()
Срок назначат заново, а свой текст сестра прочитает сама, без видео. -
Журналист выпустил ИИ-песню от имени чужой группы
![Журналист в наушниках с хитрой улыбкой работает за ноутбуком]()
Журналист 404 Media сгенерировал песню в Udio по простому запросу. ![Трое музыкантов панк-группы в шоке смотрят в телефон]()
Трек вышел на подтверждённой странице панк-группы Lathe of Heaven в Spotify без ведома музыкантов. ![Журналист удивлённо разводит руками, вокруг висят значки музыкальных сервисов]()
Песня попала и в Apple Music, Tidal и Amazon Music — через давнюю лазейку в дистрибуции. ![Довольный мошенник ловит монеты, сыплющиеся из наушников, слушательница расстроена]()
Так мошенники зарабатывают на чужой славе. Площадки и дистрибьюторы ответственность не берут. -
Нейросеть научилась играть в «Точки» и обыгрывает автора
![Разработчик держит тетрадь в клетку с партией в точки]()
Разработчик учил нейросеть игре в «Точки» из школьной тетради — по примеру AlphaZero. ![Разработчик ночью смотрит на два монитора с партиями в точки]()
Сеть играла сама с собой: 30 поколений за полтора месяца, однажды девять пришлось выбросить. ![Разработчик радостно подпрыгивает перед монитором с выигранной партией]()
Ученик обыграл учителя, только когда поиск подняли с 800 до 1600 симуляций на ход. ![Разработчик смеётся, проиграв нейросети партию в точки]()
Теперь сложный уровень игры Just Dots стабильно обыгрывает автора на поле 20×20.
























