 FlipИИ чат
Ещё
Нейросети
-
Gemini
Gemini
-
Z.ai
Z.ai
-
ChatGPT
ChatGPT
-
DeepSeek
DeepSeek
-
Claude
Claude
-
Jev
Jev
-
Perplexity
Perplexity
-
OpenAI
OpenAI
-
Kimi
Kimi
-
Qwen
Qwen
-
Grok
Grok
-
Все модели
Все модели
-
Задачи
Задачи





GLM-5.2: что умеет флагманская открытая модель с контекстом 1 млн токенов

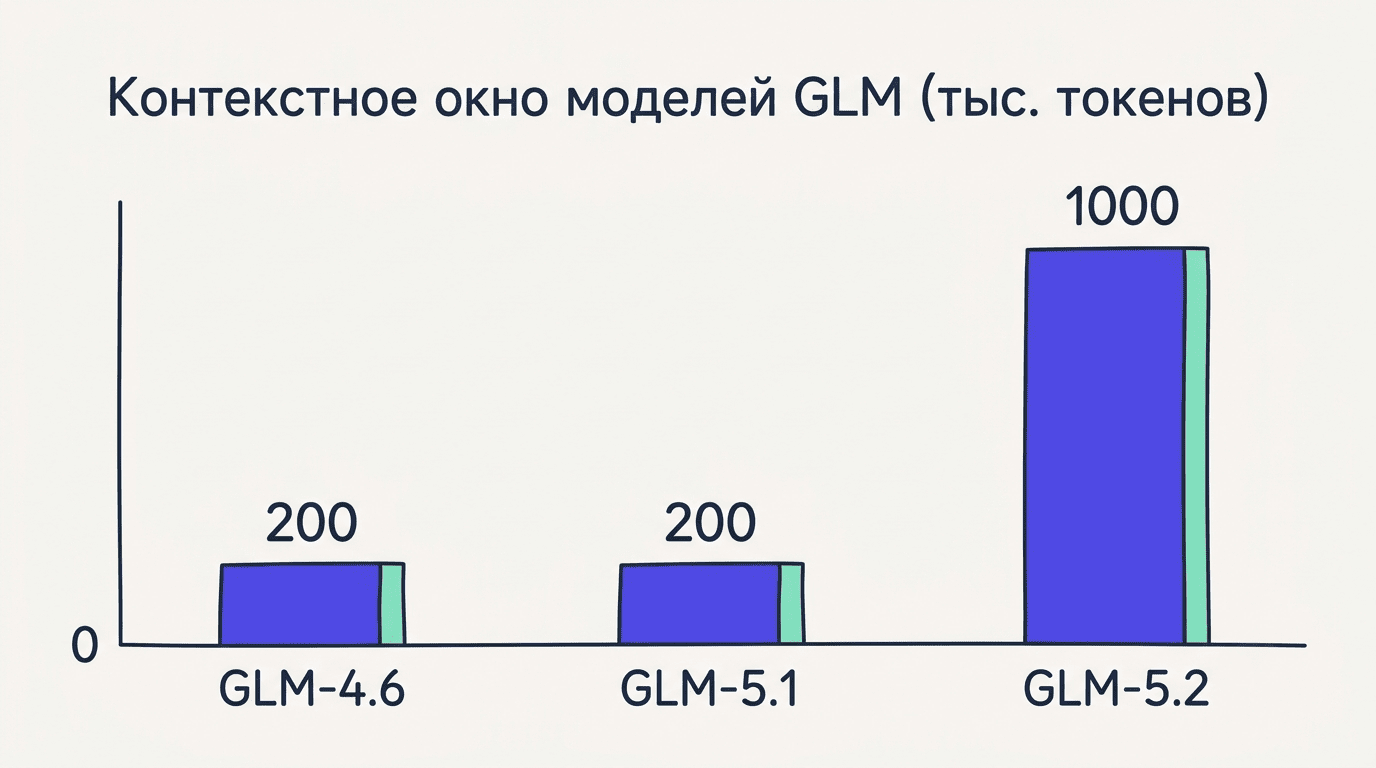
GLM-5.2 — флагманская открытая языковая модель, которую 13 июня 2026 выпустила Z.ai (Zhipu AI). Главное отличие — контекст вырос до 1 000 000 токенов, впятеро больше 200K у GLM-5.1, при этом цены API не изменились.
MoE-архитектура на ~744-753 млрд параметров и лицензия MIT делают модель заточенной под многочасовые агентные задачи и кодинг с открытыми весами.
Что такое GLM-5.2 и кто её сделал
Флагманская языковая модель Z.ai (Zhipu AI) вышла 13 июня 2026 года. Открытие исходного кода состоялось неделей позже релиза в облаке и API — обычная для Zhipu AI практика постепенного раскрытия.
Модель доступна сразу в нескольких форматах:
- через API по OpenAI-совместимому протоколу;
- в браузерном чате Z.ai;
- в 20+ агентных средах, включая Claude Code, OpenCode и ZCode.
Флагман линейки GLM
Нейросеть GLM изначально заточена под long-horizon задачи — многочасовую непрерывную работу агента над кодовой базой, рефакторингом и тестами, а не только на короткие диалоговые ответы. Это отличает GLM-5.2 от предыдущих версий линейки, где упор делался на разговорные и общие задачи.
Для сравнения ключевых версий линейки:
| Модель | Дата релиза | Лицензия |
|---|---|---|
| GLM-5.1 | ранее 2026 | MIT |
| GLM-5.2 | 13 июня 2026 | MIT |
Контекст 1 млн токенов — главное отличие от GLM-5.1
Рост окна контекста — центральное изменение релиза, и оно напрямую влияет на то, какие задачи модель способна держать в памяти без потери связности.
Впятеро больше контекста
Контекст вырос с 200K токенов у GLM-5.1 до 1 000 000 у GLM-5.2 — сплошное окно без деления на чанки, вывод при этом ограничен 128K (131 072) токенами. Такого объёма хватает, чтобы уместить целый репозиторий среднего размера вместе с тестами и всей историей диалога с агентом, не прибегая к суммаризации или дроблению контекста на части.
| Параметр | GLM-5.1 | GLM-5.2 |
|---|---|---|
| Контекст | 200 000 токенов | 1 000 000 токенов |
| Вывод | до 128K | до 128K (131 072) |
| Индексация | без IndexShare | IndexShare |
IndexShare и ускорение
Стабильность окна в 1 млн токенов держится за счёт механизма IndexShare: один лёгкий индексатор переиспользуется на каждые 4 слоя разреженного внимания, что снижает число операций на токен в 2.9 раза при длине контекста 1M по сравнению с GLM-5.1. Дополнительный слой Multi-Token Prediction увеличивает длину блока генерируемого ответа на 20%, что заметно ускоряет инференс именно в агентных сценариях с длинными цепочками действий.
Характеристики и архитектура MoE
Архитектурно GLM-5.2 — модель смеси экспертов (Mixture-of-Experts), где на каждый токен активируется лишь часть параметров, что экономит вычисления при сохранении ёмкости всей сети.
Параметры и режимы. MoE-архитектура: ~744-753 млрд параметров всего, из них активных на токен — ~40-98 млрд по разным замерам. Модальность одна — текст на входе и на выходе, без изображений и аудио. Модель поддерживает два уровня reasoning effort: High — баланс качества и расхода токенов для повседневных задач, и Max — для сложных многошаговых сценариев, где важна глубина рассуждения больше скорости.
Открытые веса. Лицензия MIT снимает почти все ограничения на коммерческое использование и дообучение — редкий случай для модели такого масштаба, обычно флагманы такого уровня остаются закрытыми.
Из архитектурных решений, которые отличают GLM-5.2 от типичной плотной модели, стоит выделить:
- разреженную активацию экспертов — на каждый токен работает лишь часть из ~744-753 млрд параметров;
- два независимых режима рассуждения (High и Max) вместо единственного фиксированного;
- открытую публикацию весов под MIT сразу вместе с релизом в облаке.
| Характеристика | Значение |
|---|---|
| Всего параметров | ~744-753 млрд |
| Активных на токен | ~40-98 млрд |
| Модальность | текст → текст |
| Reasoning effort | High / Max |
| Лицензия | MIT |
Бенчмарки: где GLM-5.2 в топе
Главный аргумент в пользу GLM-5.2 — не архитектурные детали, а результаты на прикладных бенчмарках кодинга и агентных задач, где модель обгоняет предыдущую версию с большим отрывом.
Кодинг и агентные тесты
Как измерить прогресс модели на практике, можно по следующим шагам:
- Сравнить Terminal-Bench 2.1 — у GLM-5.2 результат 81.0 против 63.5 у GLM-5.1 (+17.5 пункта), что делает её сильнейшей открытой моделью и единственной, преодолевшей отметку в 80%.
- Проверить FrontierSWE — 74.4%, второе место после закрытой Opus 4.8 (75.1%).
- Оценить SWE-bench Pro — 62.1% против 58.4% у предыдущей версии.
- Посмотреть AIME 2026 — 99.2%, почти предельный результат на математических задачах олимпиадного уровня.
- Сверить Design Arena — 1360 Elo, модель обошла Claude Fable 5 (1350) в задачах генерации интерфейсов.
Zhipu AI формулирует стратегию развития линейки так:
Мы открываем веса наших моделей, потому что верим: прогресс в ИИ ускоряется, когда исследователи по всему миру могут проверять, дообучать и улучшать одну и ту же архитектуру, а не начинать с нуля.Zhipu AI, релиз-нот GLM-5.2
Эта ставка на открытость видна и в цифрах: разрыв с предыдущей версией на большинстве бенчмарков превышает 10 пунктов, а по кодингу и агентным задачам GLM-5.2 приближается к лучшим закрытым моделям на рынке. Ниже — сводная таблица по всем ключевым замерам, чтобы масштаб прогресса был виден сразу.
Резюме сравнения по ключевым бенчмаркам:
| Бенчмарк | GLM-5.1 | GLM-5.2 |
|---|---|---|
| Terminal-Bench 2.1 | 63.5 | 81.0 |
| FrontierSWE | — | 74.4 (2 место после Opus 4.8) |
| SWE-bench Pro | 58.4 | 62.1 |
| AIME 2026 | — | 99.2 |
| Design Arena (Elo) | — | 1360 |
Цены API и локальный запуск
Разработчикам, планирующим подключить модель к своим проектам, важны два вопроса — сколько стоит API и можно ли развернуть модель у себя. Подробный разбор тарифов и подключения — в материале про API GLM.
Тарифы API
Согласно официальному прайс-листу Z.ai, цены на GLM-5.2 остались на уровне GLM-5.1 (за 1 млн токенов): входные токены — $1.40, входные из кэша — $0.26, выходные — $4.40. API совместимо с форматом OpenAI Chat Completions, endpoint — api.z.ai, имя модели в запросах — glm-5.2 (для полного окна контекста используется идентификатор glm-5.2[1m]).
Локальный запуск
Веса модели опубликованы на Hugging Face под организацией zai-org и на ModelScope под лицензией MIT. Развернуть GLM-5.2 на ноутбуке не получится — требования к памяти зависят от точности весов:
- FP8 — около 754 ГБ только под веса;
- BF16 — около 1.5 ТБ;
- 4-битная квантизация — 370-400 ГБ, минимальный вариант из практически применимых.
Для локального инференса нужно серверное железо уровня нескольких GPU H100, что делает это решение доступным в основном исследовательским лабораториям и крупным компаниям, а не индивидуальным разработчикам.
Материнская компания модели, Zhipu AI, подробнее описана в отдельном обзоре — Zhipu AI, где разобрана история компании и вся линейка GLM.
FAQ
Сколько параметров у GLM-5.2?
~744-753 млрд параметров всего (MoE-архитектура), активных на токен ~40-98 млрд по разным замерам.
Какой контекст у GLM-5.2?
1 000 000 токенов — впятеро больше 200K у GLM-5.1; максимальный вывод — до 128K (131 072) токенов.
Сколько стоит API GLM-5.2?
За 1 млн токенов: вход $1.40, вход из кэша $0.26, выход $4.40 — те же цены, что были у GLM-5.1.
Чем GLM-5.2 отличается от GLM-5.1?
Контекст вырос до 1 млн токенов вместо 200K, добавлен механизм IndexShare, появились два режима reasoning effort, резко вырос результат в кодинге (Terminal-Bench 81.0 против 63.5).
Можно ли запустить GLM-5.2 локально?
Да, веса открыты под лицензией MIT, но нужно серверное железо: FP8-версии требуется около 754 ГБ памяти, BF16 — около 1.5 ТБ.
-
Маршрут от Claude привёл подростка на «Вдоводел»
![Подросток в синей куртке и шлеме радостно смотрит маршрут в телефоне на вершине горы над городом]()
16-летний Брайс из Ванкувера проложил с Claude новый для себя маршрут на гору Краун. ![Подросток с рюкзаком неуверенно пробирается между валунами к крутому гребню]()
Разметки не было: вместо кулуара он попал на гребень «Вдоводел», куда ходят с верёвками. ![Испуганный подросток прижался к отвесной скале на узком уступе и звонит по телефону]()
Брайс застрял на уступе шириной около полутора метров: сзади обрыв, впереди почти отвесная стена. ![Спасатель спускается по верёвке к подростку на уступе, рядом вертолёт]()
Вертолёт не мог подойти к скале: спасатель спустился к Брайсу по верёвке, и его подняли на борт. ![Подросток в спасательном одеяле сидит у тропы с бумажной картой, рядом компас]()
Брайс винит себя, но тропы через ИИ больше не прокладывает. Спасатель: «Claude никогда не был в этих местах». -
950 агентов Claude нашли в ДНК вирусов загадочную систему
![Учёная в лаборатории смотрит на монитор со спиралями ДНК]()
Anthropic поручила Claude найти в огромной базе ДНК необычные ферменты. ![Учёная с планшетом смотрит на стену из сотен мониторов с ДНК]()
Около 950 агентов за 21 час собрали больше 200 тысяч ферментов и написали 20 отчётов. ![Учёная взволнованно показывает на повторяющийся узор в цепочке ДНК на экране]()
Один агент «на глаз» заметил рядом с ферментом повторы, как у CRISPR. Систему назвали ART. ![Учёная поднимает пробирку к свету, коллега задумчиво смотрит рядом]()
Что она делает, пока неизвестно. Пионер CRISPR Фэн Чжан назвал находку «по-настоящему интригующей». -
Anthropic запретила издеваться над Claude
![Женщина в очках сердито кричит на ноутбук и стучит кулаком по столу]()
Anthropic запретила «длительное и бессмысленное» жестокое обращение с Claude. ![Женщина спокойно спорит, разводя рукой перед ноутбуком]()
Речь о крайних случаях. Раздражение, споры, мрачные сюжеты и тесты под запрет не попадают. ![Удивлённая женщина смотрит на ноутбук со значком закрытой двери на экране]()
Главная защита прежняя: Claude сам завершает такой диалог. ![Женщина прикрепляет к доске календарь с обведённым днём]()
Правила действуют с 12 ноября. За нарушения доступ могут ограничить или закрыть. -
ИИ-видео с погибшим в суде: срок назначат заново
![Женщина в зале суда показывает планшет с лицом мужчины]()
В Аризоне сестра погибшего показала в суде видео, где ИИ-аватар брата прощает убийцу. ![Растроганный судья с рукой на груди за судейским столом]()
Судья дал максимальные 10,5 года и сказал, что ему «понравилось это видео». ![Три судьи апелляционного суда изучают документы]()
Апелляционный суд счёл приговор несправедливым: видео «не отражает реальных событий». ![Женщина читает своё заявление с листов за трибуной, планшет выключен]()
Срок назначат заново, а свой текст сестра прочитает сама, без видео. -
Журналист выпустил ИИ-песню от имени чужой группы
![Журналист в наушниках с хитрой улыбкой работает за ноутбуком]()
Журналист 404 Media сгенерировал песню в Udio по простому запросу. ![Трое музыкантов панк-группы в шоке смотрят в телефон]()
Трек вышел на подтверждённой странице панк-группы Lathe of Heaven в Spotify без ведома музыкантов. ![Журналист удивлённо разводит руками, вокруг висят значки музыкальных сервисов]()
Песня попала и в Apple Music, Tidal и Amazon Music — через давнюю лазейку в дистрибуции. ![Довольный мошенник ловит монеты, сыплющиеся из наушников, слушательница расстроена]()
Так мошенники зарабатывают на чужой славе. Площадки и дистрибьюторы ответственность не берут. -
Нейросеть научилась играть в «Точки» и обыгрывает автора
![Разработчик держит тетрадь в клетку с партией в точки]()
Разработчик учил нейросеть игре в «Точки» из школьной тетради — по примеру AlphaZero. ![Разработчик ночью смотрит на два монитора с партиями в точки]()
Сеть играла сама с собой: 30 поколений за полтора месяца, однажды девять пришлось выбросить. ![Разработчик радостно подпрыгивает перед монитором с выигранной партией]()
Ученик обыграл учителя, только когда поиск подняли с 800 до 1600 симуляций на ход. ![Разработчик смеётся, проиграв нейросети партию в точки]()
Теперь сложный уровень игры Just Dots стабильно обыгрывает автора на поле 20×20.
























