 FlipИИ чат
Ещё
Нейросети
-
Gemini
Gemini
-
Z.ai
Z.ai
-
ChatGPT
ChatGPT
-
DeepSeek
DeepSeek
-
Claude
Claude
-
Jev
Jev
-
Perplexity
Perplexity
-
OpenAI
OpenAI
-
Kimi
Kimi
-
Qwen
Qwen
-
Grok
Grok
-
Все модели
Все модели
-
Задачи
Задачи





Уровни усилий effort в Claude: low, medium, high, xhigh, max

Параметр effort управляет глубиной рассуждения модели перед ответом. В Claude Fable 5.1 доступно пять уровней — low, medium, high, xhigh и max — и переключать их можно прямо по ходу диалога без перезапуска сессии. По умолчанию в API и Claude Code установлен High, в Claude.ai — Medium. Обо всех моделях Claude — в общем обзоре.
Официальное описание механики — в документации Anthropic.
Пять уровней: от low до max
| Уровень | Рассуждение | Дефолт для |
|---|---|---|
| low | Минимальное | — |
| medium | Умеренное | Claude.ai |
| high | Глубокое | API, Claude Code |
| xhigh | Очень глубокое | Долгие агентные и кодинговые задачи (дольше 30 минут) |
| max | Максимальное | Спецзадачи |
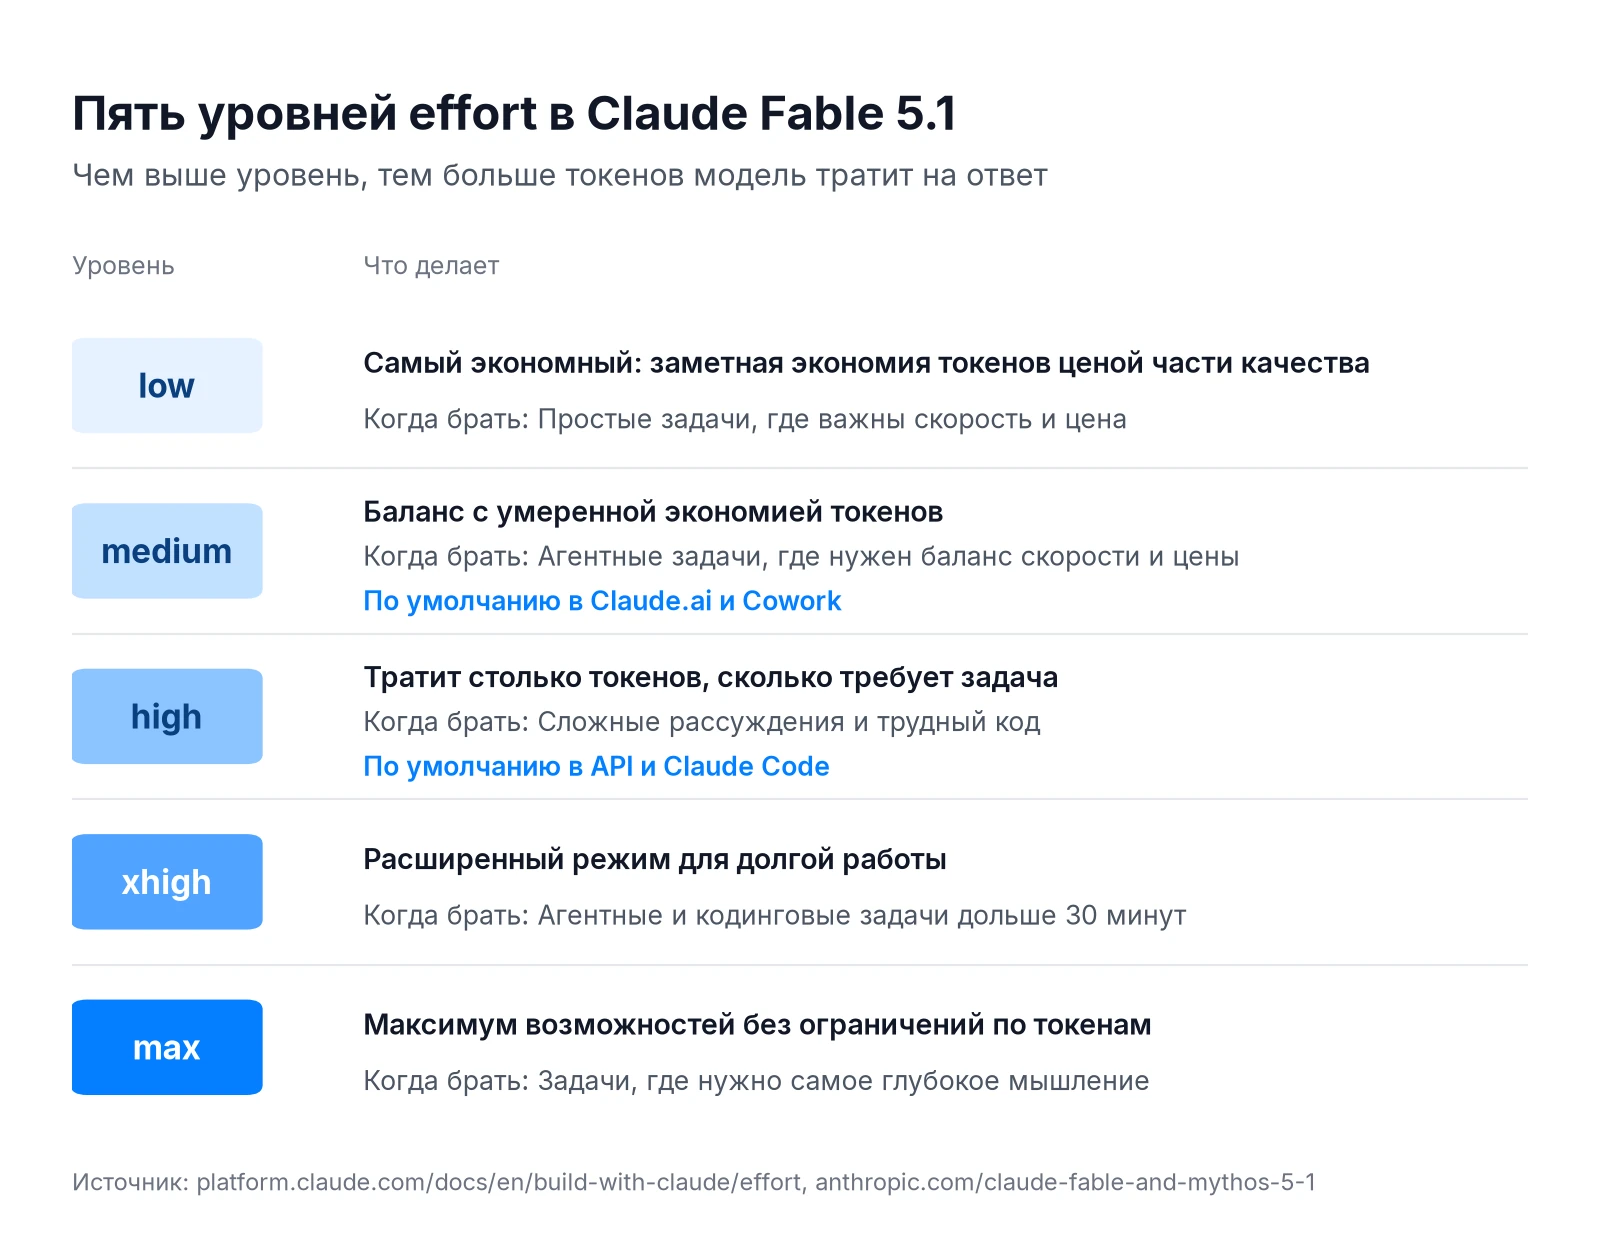
Low подходит для быстрых фактических вопросов и шаблонных задач — глубина рассуждения там не нужна.
High выставлен по умолчанию в Claude Code, потому что задачи разработки редко тривиальны. Max включает полный режим расширенного мышления — CursorBench 3.2.0 фиксирует результат 73,4% именно при max effort.
Когда high или max себя оправдывают:
- отладка сложного многофайлового кода
- научные расчёты и формальные доказательства
- финальная проверка перед деплоем
- задачи с высокой ценой ошибки
Производительность: цифры бенчмарков
Terminal-Bench-Science 0.1 показывает двукратный разрыв между крайними уровнями:
| Уровень effort | Terminal-Bench-Science | Стоимость |
|---|---|---|
| low | 26,3% | ~$11,1 за задачу в среднем |
| max | 52,6% | ~$37,9 за задачу в среднем |
Разница в качестве двукратная, разница в цене — 3,4×. Max окупается только там, где дополнительная точность критична.
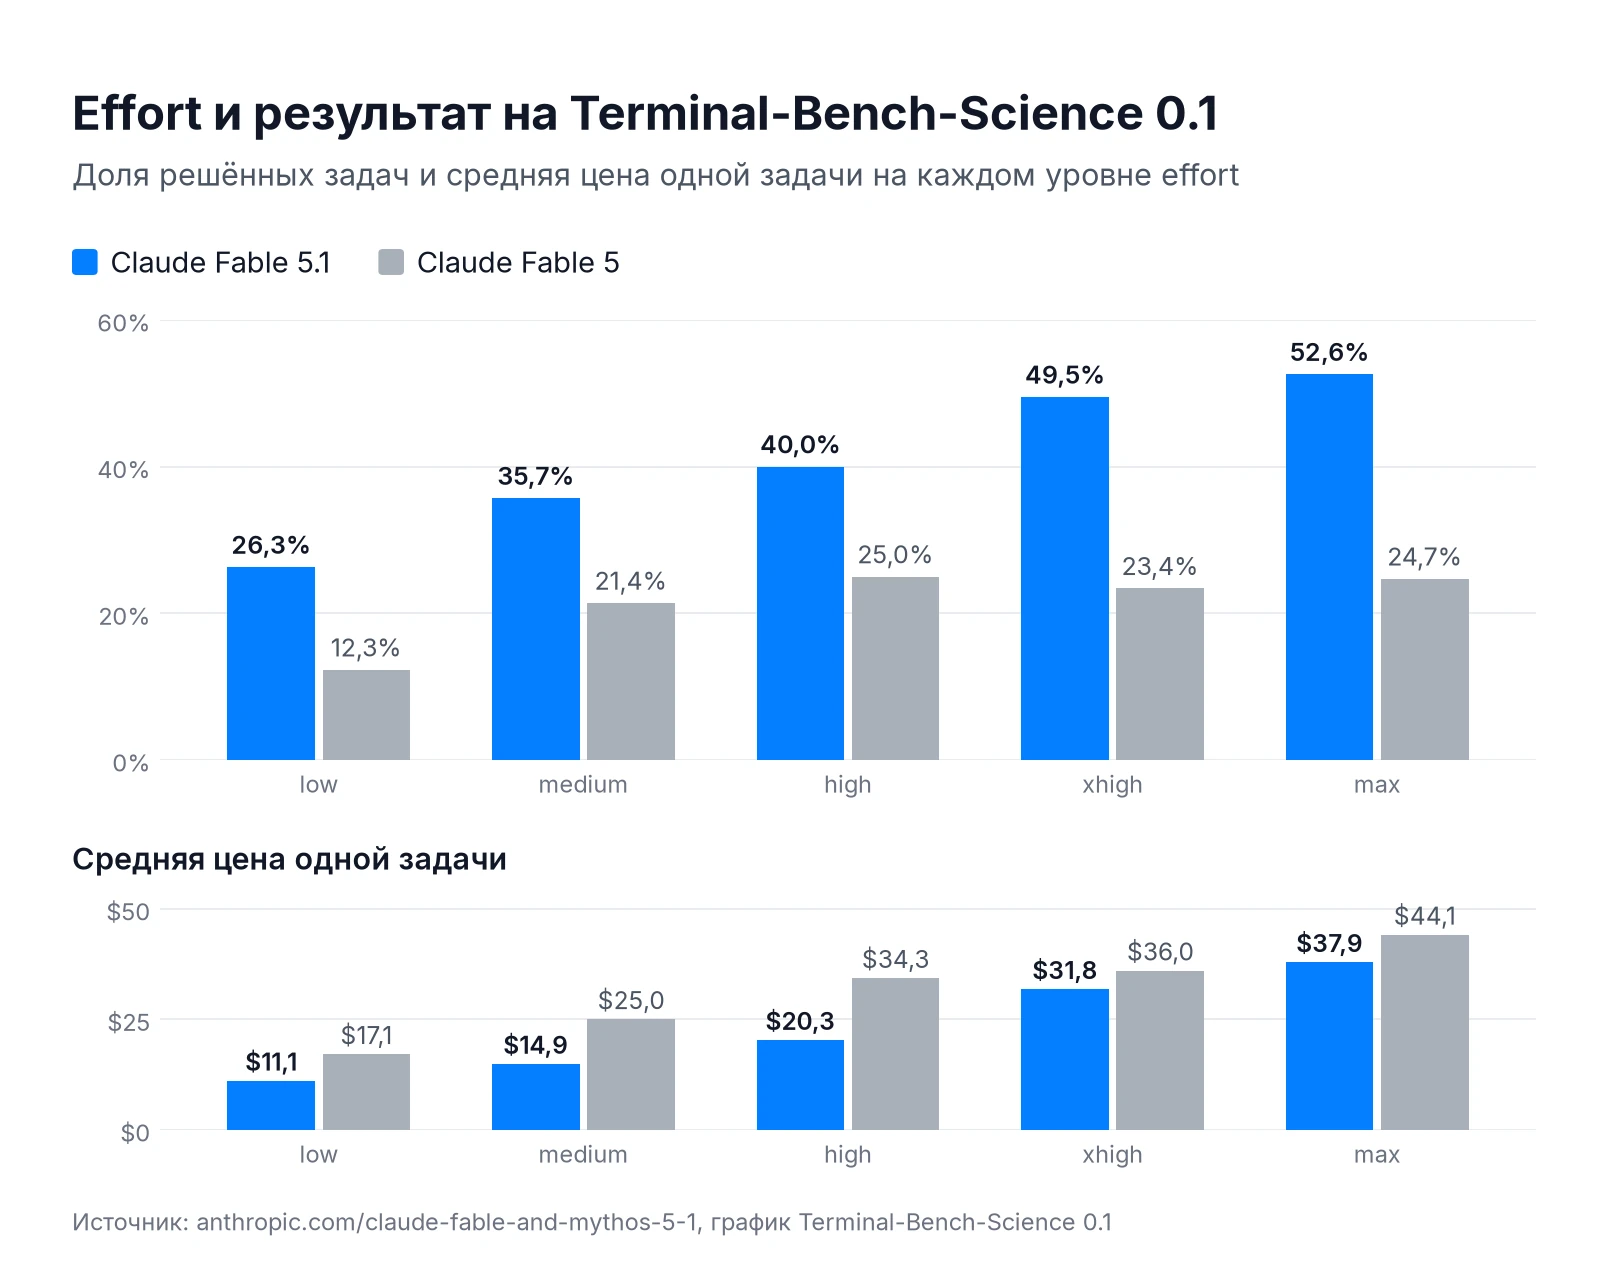
Исследователи Artificial Analysis отметили: в режиме max модель генерирует больше выходных токенов, и некоторые задачи выходят дороже, чем ожидалось. В обычном диалоге, где ИИ чат бот отвечает на короткие вопросы, такой уровень почти никогда не нужен. Подробнее о том, как кэш снижает стоимость агентных сессий, — в материале про кэширование промптов.
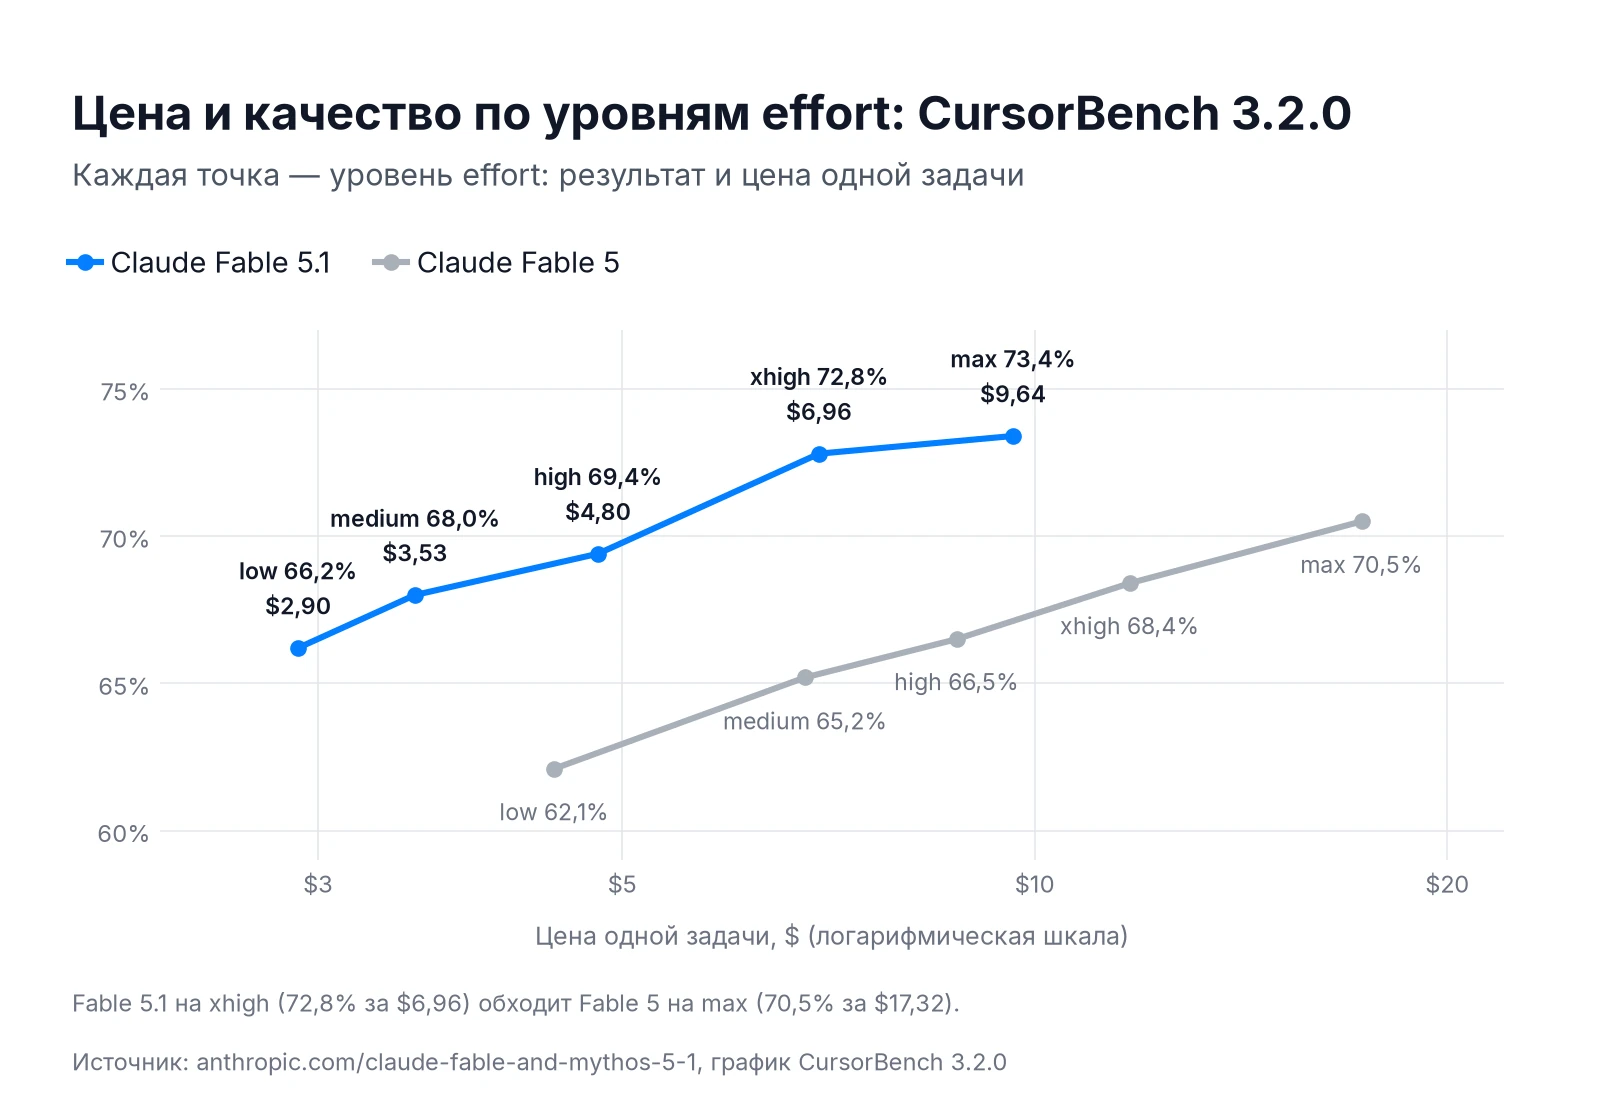
Стоимость и настройка
Цена за токен не зависит от effort: $10 за 1M входных и $50 за 1M выходных по официальному прайсу. Что меняется — количество токенов на рассуждение:
- low → меньше токенов → быстрее и дешевле
- max → больше выходных токенов → точнее, но дороже
Чтение из кэша стоит $0,25 за 1M — ключевая экономия в агентных циклах, где контекст повторяется. Подробнее о модели — в обзоре Claude Mythos 5.1.
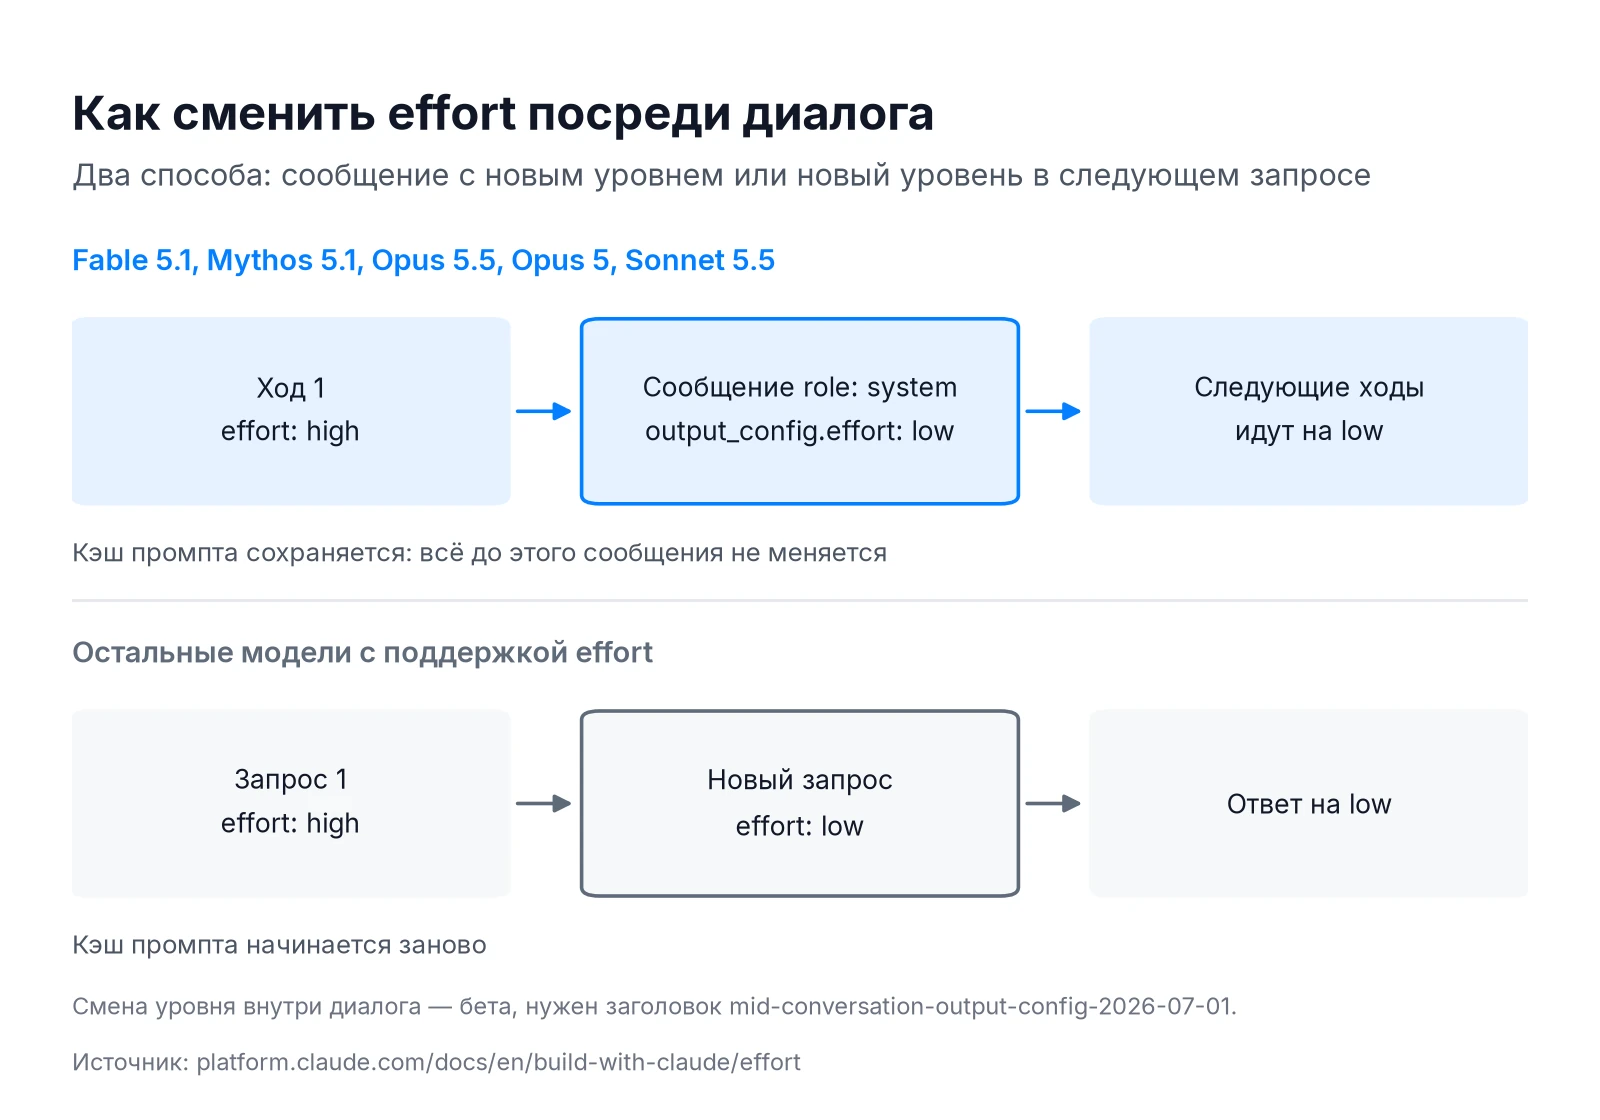
Как изменить effort в диалоге
Чтобы переключить уровень effort через Claude API:
- Используйте идентификатор модели
claude-fable-5-1. - Передайте параметр
effortсо значениемlow,medium,highилиmax. - Для смены уровня в середине цикла передайте новое значение в следующем API-вызове — перезапуск сессии не нужен.
- В Claude Code — переключение через меню модели.
- В Claude.ai — через иконку настроек в интерфейсе чата.
Effort levels let developers tune the depth of reasoning per task — paying more only when the task warrants it.Anthropic, официальный анонс Claude Fable 5.1 и Mythos 5.1
FAQ
Что такое эффорт-тиры в Claude?
Эффорт-тиры (effort tiers) — управляемые уровни глубины рассуждения модели. Их пять: low, medium, high, xhigh, max. Чем выше уровень, тем точнее ответ на сложных задачах — и тем больше токенов.
Чем отличаются уровни low, medium, high, xhigh и max?
Low — минимальное рассуждение, быстро и дёшево. Medium — дефолт в Claude.ai. High — дефолт в API и Claude Code. Xhigh — для долгих агентных и кодинговых задач дольше 30 минут. Max — полный режим расширенного мышления: CursorBench 73,4%, но больше токенов на вывод.
Какой эффорт стоит по умолчанию в Claude Code?
По умолчанию в Claude Code установлен уровень High. В Claude.ai дефолт — Medium.
Можно ли менять уровень усилий по ходу диалога?
Да, это ключевая особенность Claude Fable 5.1: уровень effort меняется через параметр API в любой момент сессии без перезапуска.
Насколько дороже обходится режим max?
На Terminal-Bench-Science low стоит в среднем около $11,1 за одну задачу, max — около $37,9. Разница 3,4×. Цена за токен не меняется, но max генерирует больше выходных токенов.
Когда стоит выбирать low effort?
Low подходит для быстрых фактических вопросов и шаблонных задач, где глубина рассуждения не влияет на результат.
Как effort влияет на CursorBench и Terminal-Bench?
CursorBench 3.2.0 фиксирует 73,4% при max effort. На Terminal-Bench-Science 0.1 разница между low (26,3%) и max (52,6%) двукратная.
-
Маршрут от Claude привёл подростка на «Вдоводел»
![Подросток в синей куртке и шлеме радостно смотрит маршрут в телефоне на вершине горы над городом]()
16-летний Брайс из Ванкувера проложил с Claude новый для себя маршрут на гору Краун. ![Подросток с рюкзаком неуверенно пробирается между валунами к крутому гребню]()
Разметки не было: вместо кулуара он попал на гребень «Вдоводел», куда ходят с верёвками. ![Испуганный подросток прижался к отвесной скале на узком уступе и звонит по телефону]()
Брайс застрял на уступе шириной около полутора метров: сзади обрыв, впереди почти отвесная стена. ![Спасатель спускается по верёвке к подростку на уступе, рядом вертолёт]()
Вертолёт не мог подойти к скале: спасатель спустился к Брайсу по верёвке, и его подняли на борт. ![Подросток в спасательном одеяле сидит у тропы с бумажной картой, рядом компас]()
Брайс винит себя, но тропы через ИИ больше не прокладывает. Спасатель: «Claude никогда не был в этих местах». -
950 агентов Claude нашли в ДНК вирусов загадочную систему
![Учёная в лаборатории смотрит на монитор со спиралями ДНК]()
Anthropic поручила Claude найти в огромной базе ДНК необычные ферменты. ![Учёная с планшетом смотрит на стену из сотен мониторов с ДНК]()
Около 950 агентов за 21 час собрали больше 200 тысяч ферментов и написали 20 отчётов. ![Учёная взволнованно показывает на повторяющийся узор в цепочке ДНК на экране]()
Один агент «на глаз» заметил рядом с ферментом повторы, как у CRISPR. Систему назвали ART. ![Учёная поднимает пробирку к свету, коллега задумчиво смотрит рядом]()
Что она делает, пока неизвестно. Пионер CRISPR Фэн Чжан назвал находку «по-настоящему интригующей». -
Anthropic запретила издеваться над Claude
![Женщина в очках сердито кричит на ноутбук и стучит кулаком по столу]()
Anthropic запретила «длительное и бессмысленное» жестокое обращение с Claude. ![Женщина спокойно спорит, разводя рукой перед ноутбуком]()
Речь о крайних случаях. Раздражение, споры, мрачные сюжеты и тесты под запрет не попадают. ![Удивлённая женщина смотрит на ноутбук со значком закрытой двери на экране]()
Главная защита прежняя: Claude сам завершает такой диалог. ![Женщина прикрепляет к доске календарь с обведённым днём]()
Правила действуют с 12 ноября. За нарушения доступ могут ограничить или закрыть. -
ИИ-видео с погибшим в суде: срок назначат заново
![Женщина в зале суда показывает планшет с лицом мужчины]()
В Аризоне сестра погибшего показала в суде видео, где ИИ-аватар брата прощает убийцу. ![Растроганный судья с рукой на груди за судейским столом]()
Судья дал максимальные 10,5 года и сказал, что ему «понравилось это видео». ![Три судьи апелляционного суда изучают документы]()
Апелляционный суд счёл приговор несправедливым: видео «не отражает реальных событий». ![Женщина читает своё заявление с листов за трибуной, планшет выключен]()
Срок назначат заново, а свой текст сестра прочитает сама, без видео. -
Журналист выпустил ИИ-песню от имени чужой группы
![Журналист в наушниках с хитрой улыбкой работает за ноутбуком]()
Журналист 404 Media сгенерировал песню в Udio по простому запросу. ![Трое музыкантов панк-группы в шоке смотрят в телефон]()
Трек вышел на подтверждённой странице панк-группы Lathe of Heaven в Spotify без ведома музыкантов. ![Журналист удивлённо разводит руками, вокруг висят значки музыкальных сервисов]()
Песня попала и в Apple Music, Tidal и Amazon Music — через давнюю лазейку в дистрибуции. ![Довольный мошенник ловит монеты, сыплющиеся из наушников, слушательница расстроена]()
Так мошенники зарабатывают на чужой славе. Площадки и дистрибьюторы ответственность не берут. -
Нейросеть научилась играть в «Точки» и обыгрывает автора
![Разработчик держит тетрадь в клетку с партией в точки]()
Разработчик учил нейросеть игре в «Точки» из школьной тетради — по примеру AlphaZero. ![Разработчик ночью смотрит на два монитора с партиями в точки]()
Сеть играла сама с собой: 30 поколений за полтора месяца, однажды девять пришлось выбросить. ![Разработчик радостно подпрыгивает перед монитором с выигранной партией]()
Ученик обыграл учителя, только когда поиск подняли с 800 до 1600 симуляций на ход. ![Разработчик смеётся, проиграв нейросети партию в точки]()
Теперь сложный уровень игры Just Dots стабильно обыгрывает автора на поле 20×20.
























