 FlipИИ чат
Ещё
Нейросети
-
Gemini
Gemini
-
Z.ai
Z.ai
-
ChatGPT
ChatGPT
-
DeepSeek
DeepSeek
-
Claude
Claude
-
Jev
Jev
-
Perplexity
Perplexity
-
OpenAI
OpenAI
-
Kimi
Kimi
-
Qwen
Qwen
-
Grok
Grok
-
Все модели
Все модели
-
Задачи
Задачи





Claude Fable 5.1: что нового во флагманской модели Anthropic — бенчмарки, цена и отличия от Fable 5

1 сентября 2026 года Anthropic представила Claude Fable 5.1 — новую флагманскую модель для кодинга, работы со знаниями и долгих агентных задач. Согласно официальному анонсу Anthropic, это прямой преемник Fable 5: умнее, точнее в программировании и науке, заметно дешевле в агентных сценариях. Что умеет нейросеть Клауд в целом и как начать с ней работу, — в общем обзоре.
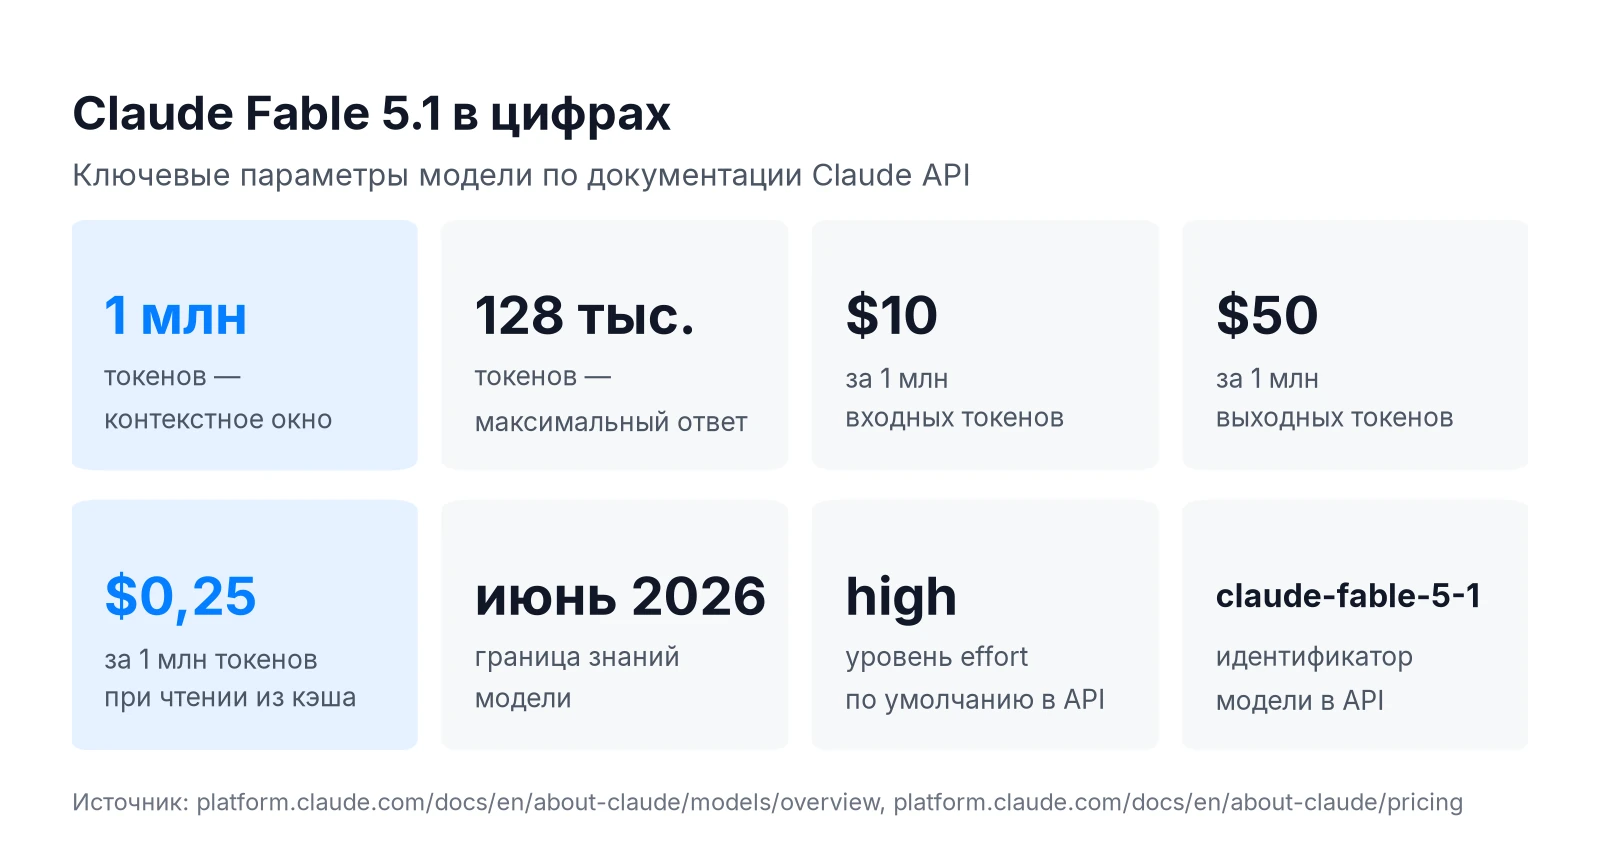
Базовые цены входа и выхода не изменились, но чтение из кэша подешевело на 75%, а в высокоагентных сценариях экономия достигает 45% по сравнению с Fable 5. API-идентификатор модели — claude-fable-5-1, контекстное окно — до 1 млн токенов, вывод — до 128 тыс. токенов за ответ.
Что такое Claude Fable 5.1
Claude Fable 5.1 — флагманская языковая модель компании Anthropic, созданная для задач агентного программирования, долгой исследовательской работы и многоэтапного решения проблем. Она пришла на смену Fable 5 и занимает верхнюю строчку в линейке Claude на момент релиза в сентябре 2026 года.
Флагман для кодинга и агентных задач
Новая модель Anthropic ориентирована прежде всего на программирование и автономную работу в терминале. Она поддерживает контекстное окно до 1 млн токенов — достаточно, чтобы удерживать в памяти большую кодовую базу или объёмный научный корпус. Максимальный вывод за один запрос составляет 128 тыс. токенов. API-идентификатор для обращения к модели — claude-fable-5-1, граница знаний — июнь 2026 года.
В экосистеме Claude она закрывает нишу «умного» флагмана: Mythos 5.1 параллельно вышел как версия с расширенным доверенным доступом для специализированных организаций, тогда как Fable 5.1 доступна широкой аудитории разработчиков через стандартный API.
Что изменилось в поведении модели
Anthropic внесла несколько заметных изменений в API. Появилась возможность менять уровень усилий (effort) прямо по ходу диалога — раньше это значение задавалось только в начале сессии. Теперь доступны пошаговые системные сообщения (step-level system prompts) и сохранение прогресса между вызовами инструментов.
Одновременно Anthropic упразднила типы tool_choice any и tool — разработчикам, которые их использовали, потребуется обновить интеграцию. Категории безопасности и система предохранителей остались на уровне Fable 5.
Отличия от Fable 5: бенчмарки
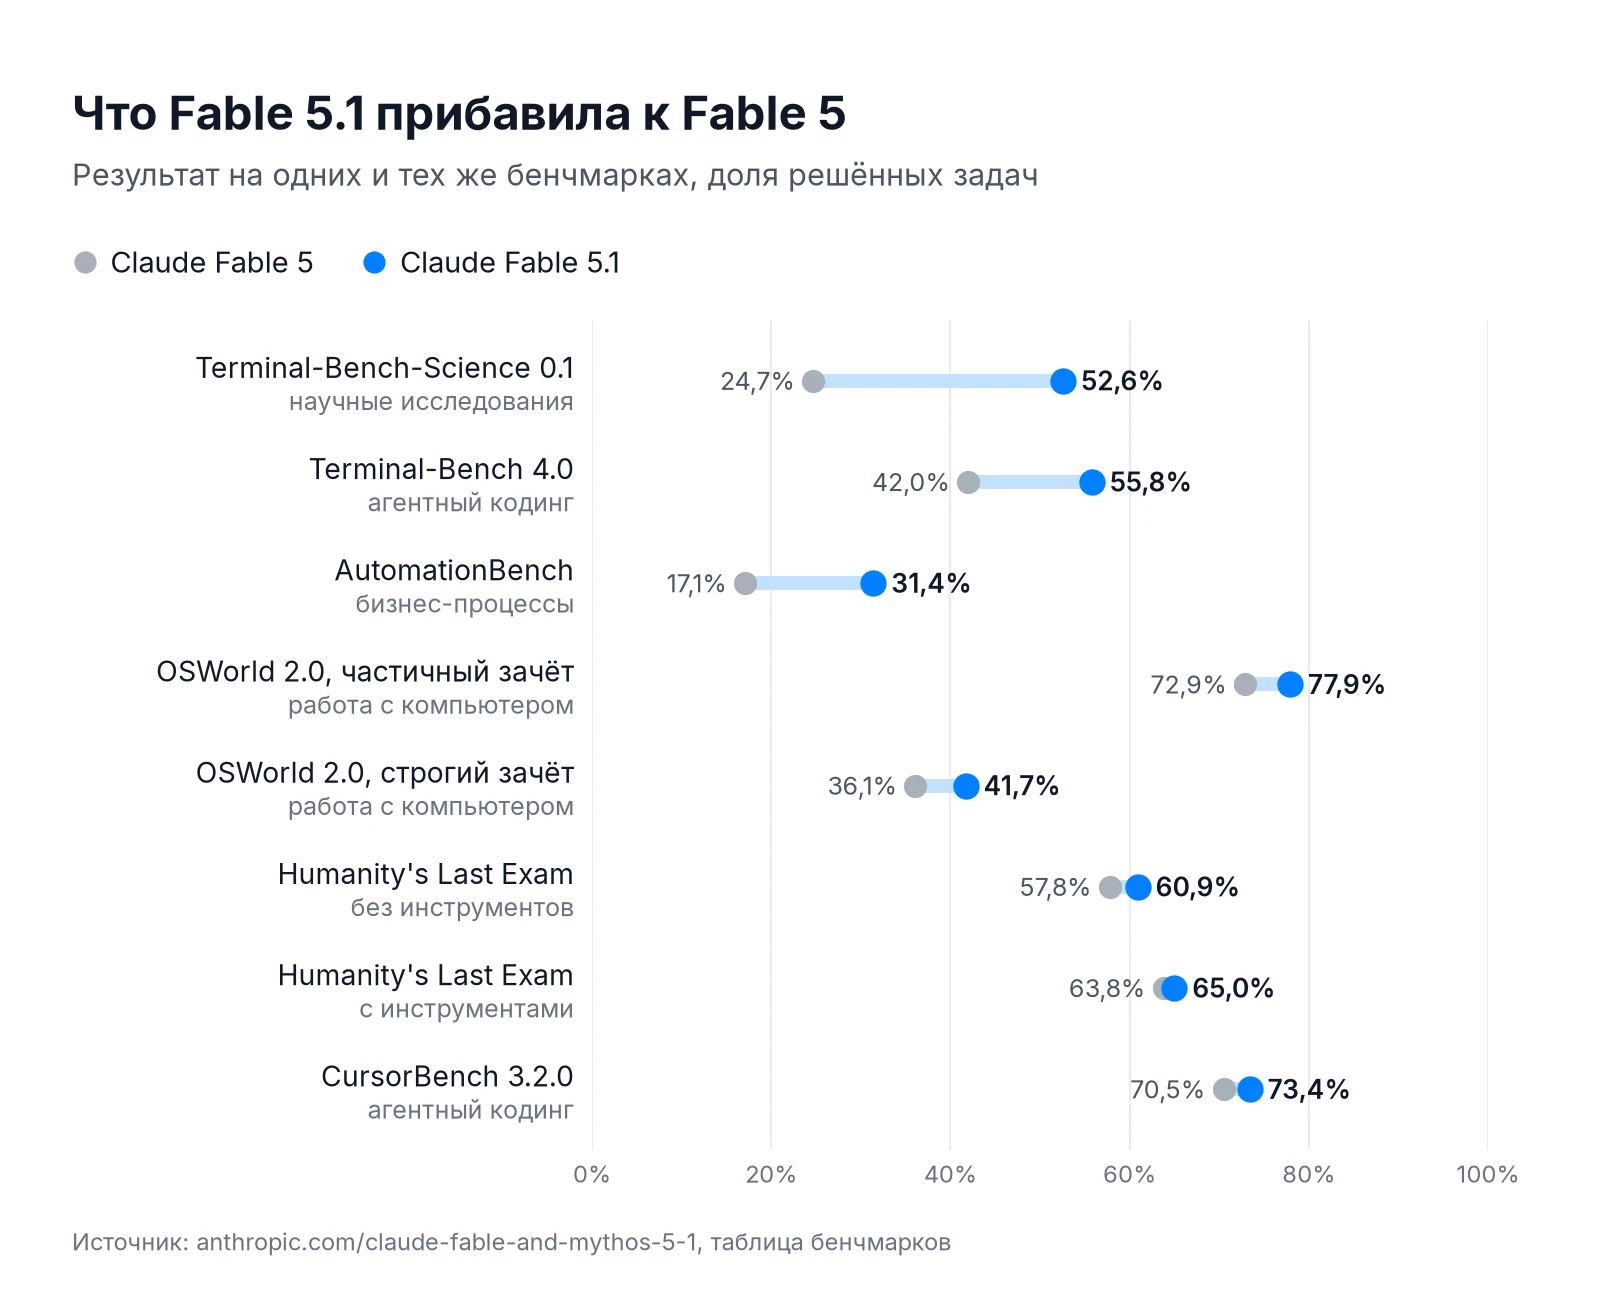
Главное, что отличает Fable 5.1 от предшественника, — рост на специализированных бенчмарках. Особенно заметен скачок в программировании и научных рассуждениях.
Программирование и работа с компьютером
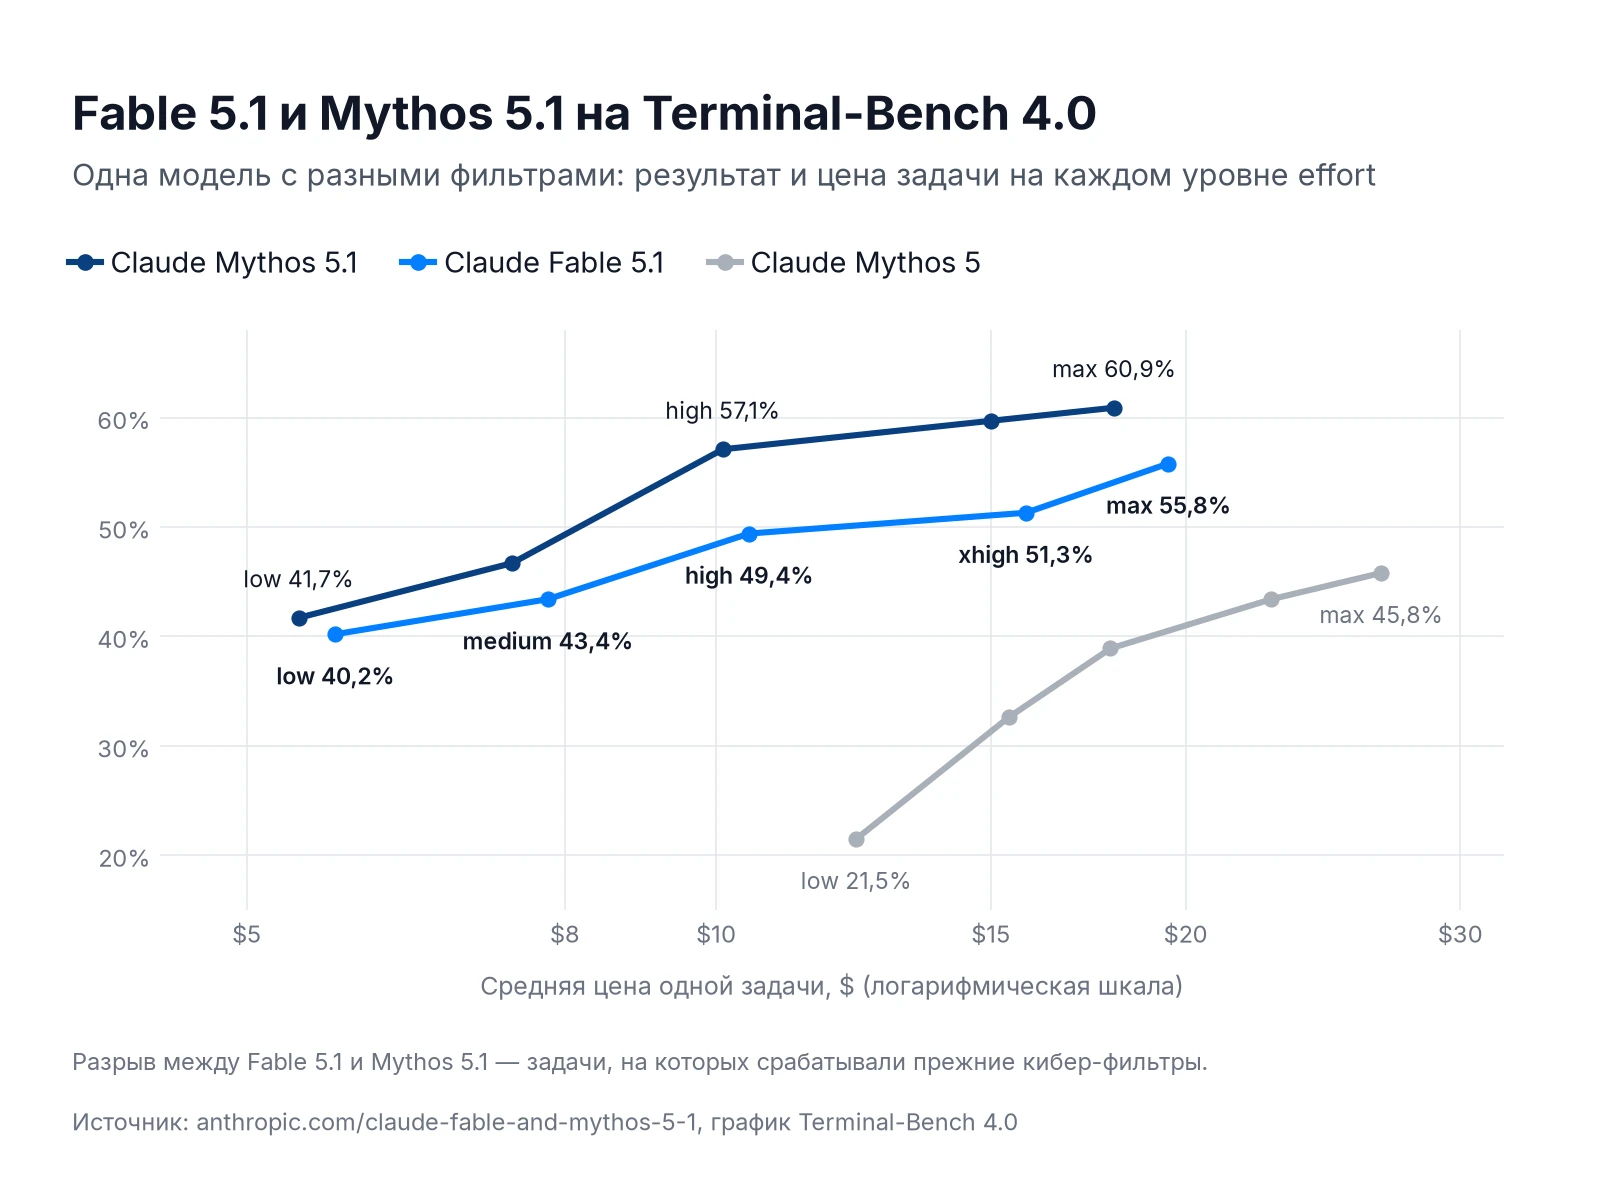
На Terminal-Bench 4.0 — стандартном тесте для автономной работы в терминале — Fable 5.1 набирает 55,8% против 42% у предшественника. Для сравнения: Opus 5 остановился на 52,3%, а GPT-5.6 Sol — на 37,3%. На CursorBench 3.2.0 модель показывает 73,4% при максимальном уровне усилий, на DeepSWE v1.1 — 67,4%. В агрегированном AA Coding Agent Index от Artificial Analysis Fable 5.1 в Claude Code набирает 70 баллов.
Управление компьютером проверялось на OSWorld 2.0: модель получила 77,9% в частичном режиме и 41,7% в строгом. Это один из наиболее требовательных тестов на автономное управление GUI, и результат Fable 5.1 здесь значительно опережает Fable 5. Подробнее о том, как устроен бенчмарк Terminal-Bench и что он измеряет, — в отдельном разборе.
Наука и рассуждения
На бенчмарке Terminal-Bench-Science 0.1 модель показывает 52,6% против 24,7% у Fable 5 — рост почти вдвое. GDPval-AA v2, измеряющий качество рассуждений, дал Fable 5.1 результат 1853 балла при 1723 у Fable 5 и 1824 у Opus 5. Humanity’s Last Exam с включёнными инструментами — 65%. На независимом Artificial Analysis Intelligence Index (max effort) модель набирает 66 баллов против 62,1 у Fable 5 и 63,1 у Opus 5.
Слабее Fable 5.1 выглядит в сложной математике и точных науках: FrontierMath Tier 4 — 87,8%, GPQA Diamond (вопросы уровня PhD) — 93,7%.
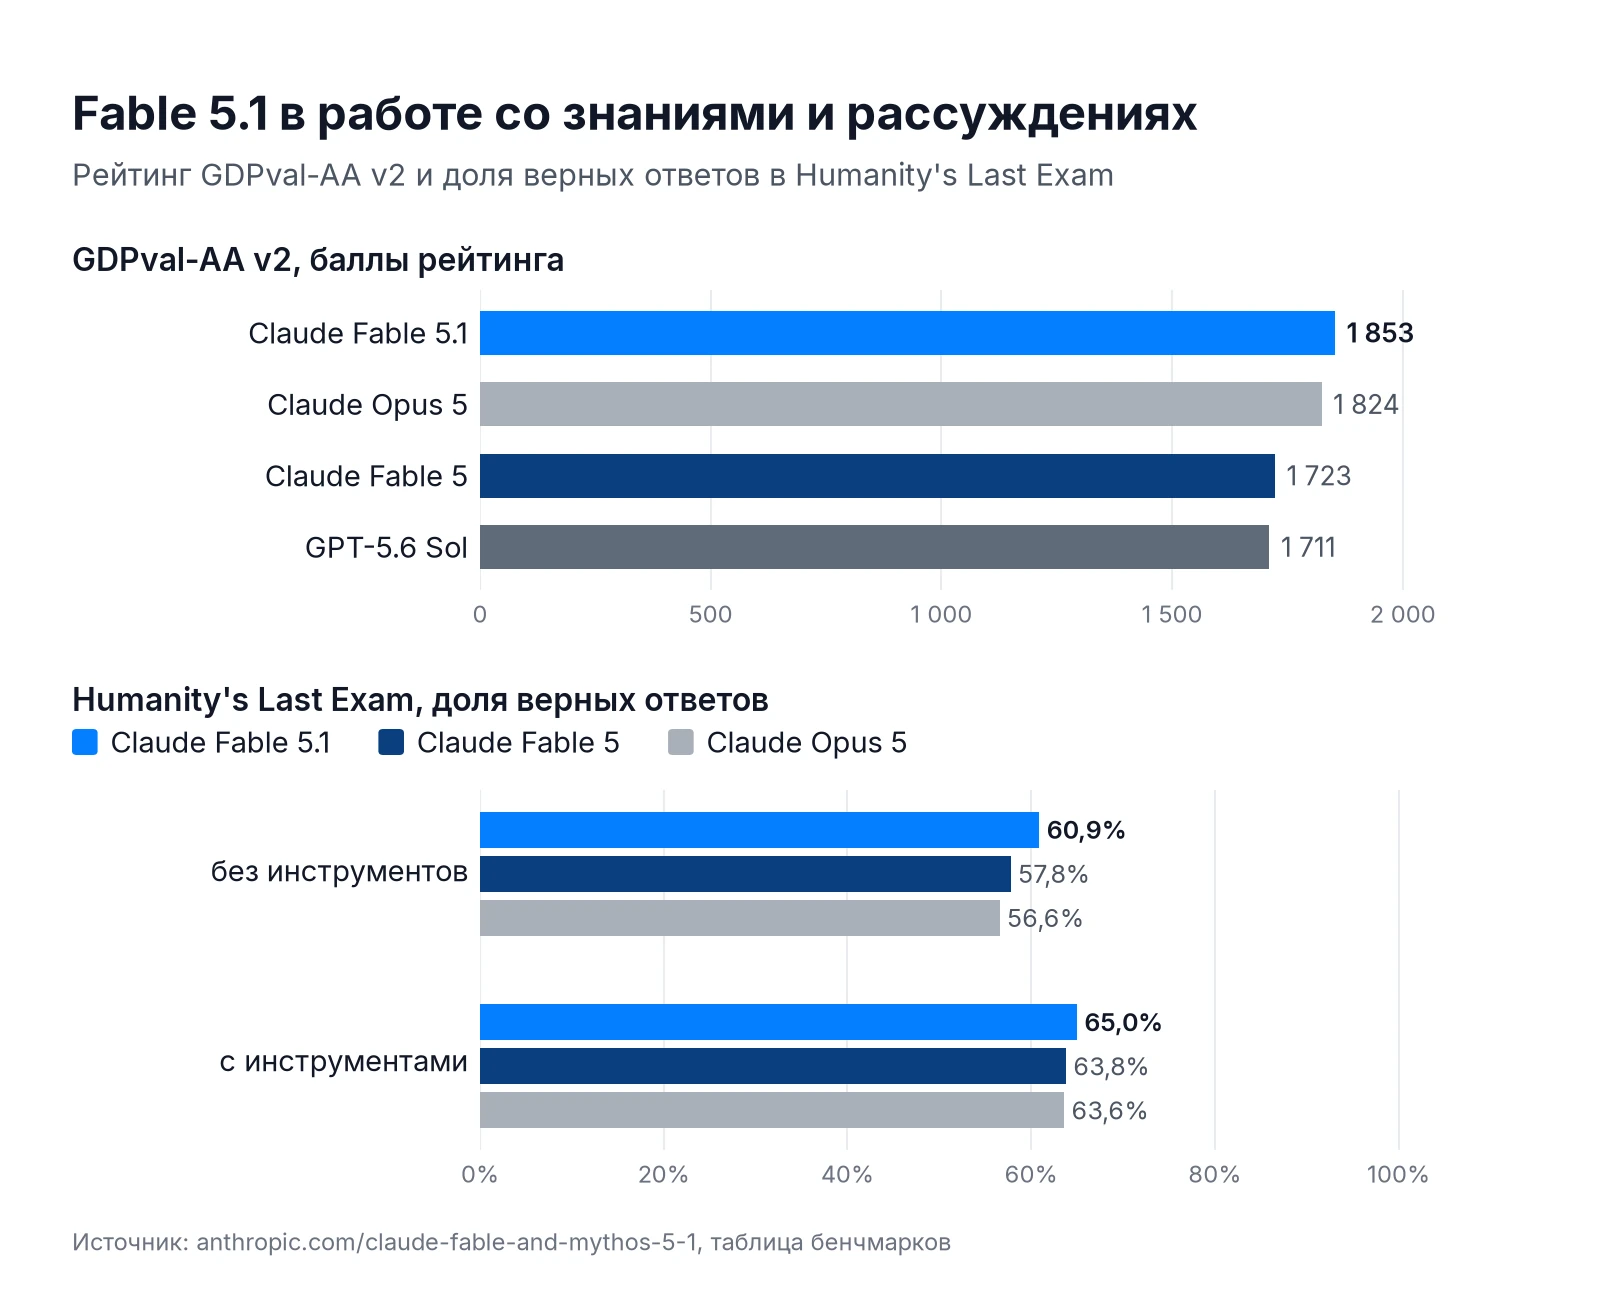
Ниже — сводная таблица ключевых бенчмарков:
| Бенчмарк | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 55,8% | 42,0% | 52,3% | 37,3% |
| Terminal-Bench-Science 0.1 | 52,6% | 24,7% | — | — |
| GDPval-AA v2 | 1853 | 1723 | 1824 | — |
| AA Intelligence Index (max effort) | 66 | 62,1 | 63,1 | — |
| OSWorld 2.0 (partial) | 77,9% | — | — | — |
| OSWorld 2.0 (strict) | 41,7% | — | — | — |
| CursorBench 3.2.0 | 73,4% | — | — | — |
| DeepSWE v1.1 | 67,4% | — | — | — |
| Humanity’s Last Exam (с инстр.) | 65% | — | — | — |
| FrontierMath Tier 4 | 87,8% | — | — | — |
| GPQA Diamond | 93,7% | — | — | — |
Fable 5.1 против GPT-6 Astra
Fable 5.1 вышла 1 сентября 2026 года — на двое суток раньше GPT-6 Astra от OpenAI. По общему интеллекту лидирует Fable: 66 баллов Artificial Analysis Intelligence Index против 61,2 у Astra, и даже в таблице самой OpenAI Fable 5.1 стоит первой с результатом 65,7. На Humanity’s Last Exam с инструментами — 65,0% против 57,2%.
В кодинге картина смешанная: по AA Coding Agent Index Fable 5.1 в Claude Code обходит Astra в Codex — 70 против 67, но на «сырых» бенчмарках уступает: DeepSWE v1.1 — 67,4% против 74,1%, Terminal-Bench 4.0 — 55,8% против 57,9%. В математике и точных науках преимущество у Astra: FrontierMath Tier 4 — 87,8% против 97,6%, GPQA Diamond — 93,7% против 96,0%. Полный разбор — в сравнении GPT-6 Astra и Claude Fable 5.1 и отдельно по FrontierMath Tier 4.
| Бенчмарк | Claude Fable 5.1 | GPT-6 Astra |
|---|---|---|
| AA Intelligence Index (max effort) | 66 | 61,2 |
| Humanity’s Last Exam (с инстр.) | 65,0% | 57,2% |
| AA Coding Agent Index | 70 | 67 |
| DeepSWE v1.1 | 67,4% | 74,1% |
| Terminal-Bench 4.0 | 55,8% | 57,9% |
| FrontierMath Tier 4 | 87,8% | 97,6% |
| GPQA Diamond | 93,7% | 96,0% |
Цена и экономия
Базовые цены и кэш
Стоимость токенов в базовых тарифах не изменилась: $10 за 1 млн входных токенов и $50 за 1 млн выходных. Ключевое удешевление касается чтения из кэша: оно подешевело на 75%, до $0,25 за 1 млн токенов. Именно это делает Fable 5.1 выгоднее для агентных сценариев, где модель многократно обращается к одному и тому же контексту. Как работает кэширование промптов и когда оно даёт максимальную выгоду — в отдельном материале.
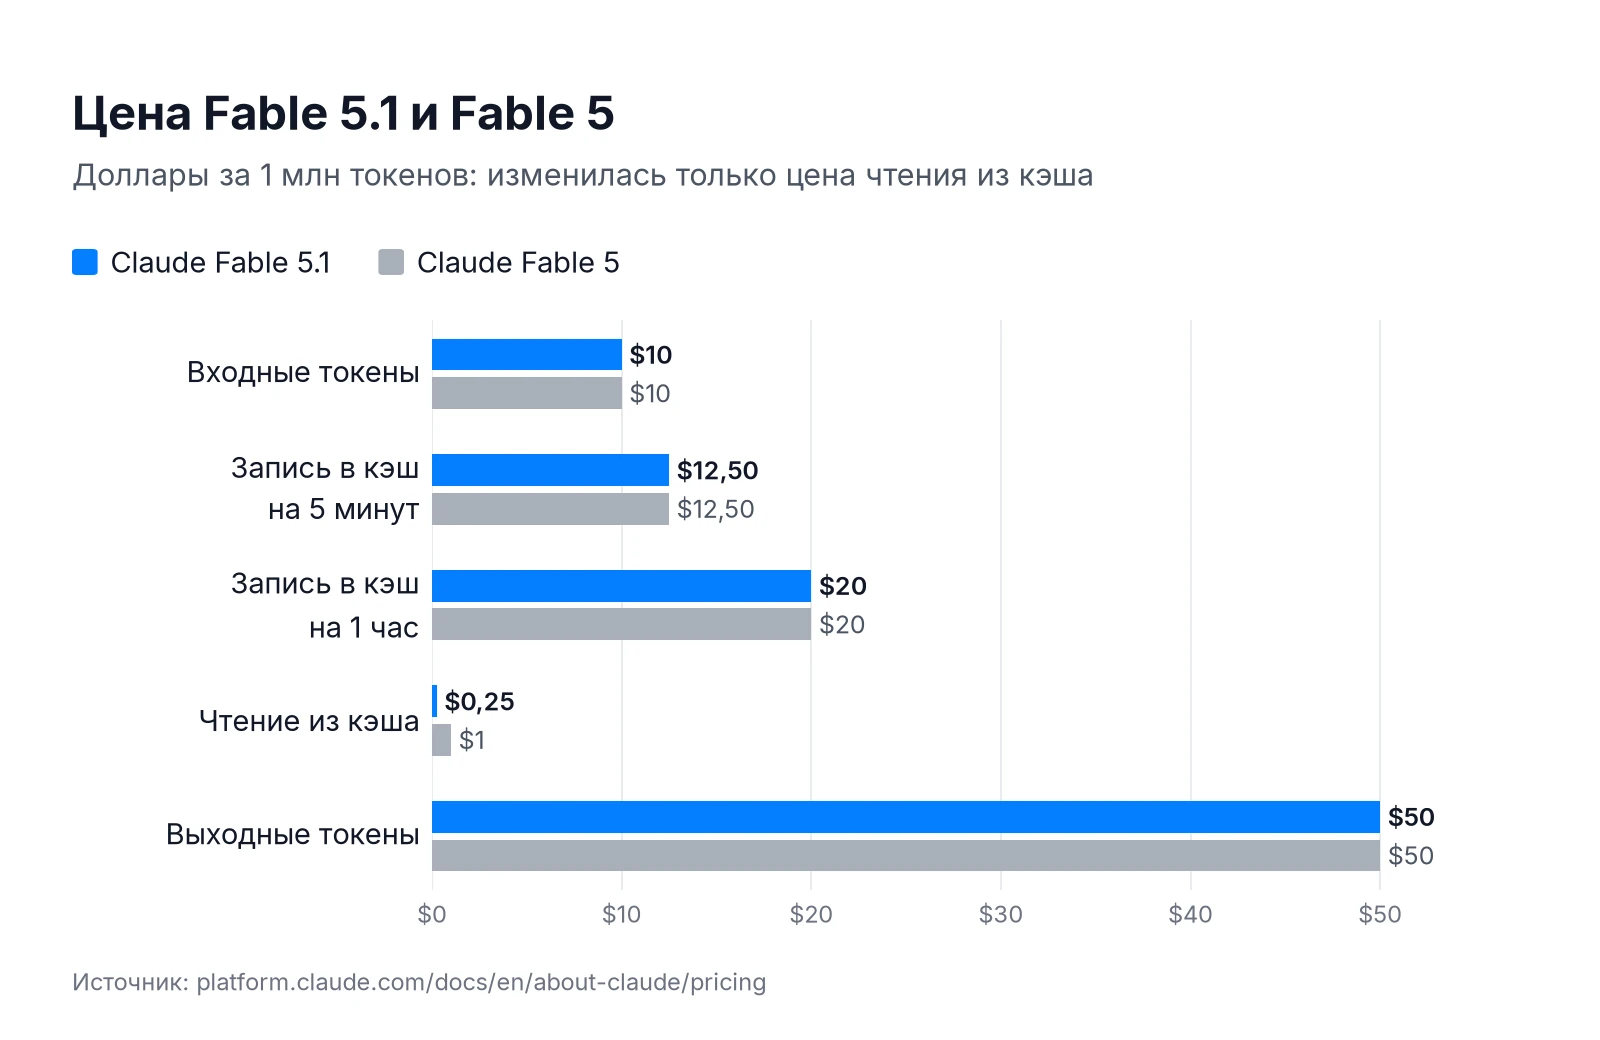
По данным Anthropic, типовые задачи обходятся примерно на 25% дешевле Fable 5, а высокоагентные сценарии — до 45%. Ранние тестеры, среди которых упоминаются Canva и SpaceXAI, подтвердили реальную экономию на рабочих нагрузках.
Против GPT-6 Astra базовый ценник одинаковый — $10 и $50 за 1 млн токенов, но кэш у Fable 5.1 в 4 раза дешевле: $0,25 против $1,00 за 1 млн. Кроме того, у Astra на длинном контексте (свыше 272 тыс. токенов) включается повышенный биллинг 2x/1,5x, а у Fable 5.1 такого режима нет. Blended-стоимость по задачам AA Intelligence Index — $7,17 у Fable 5.1 против $7,70 у Astra.
Полная таблица тарифов:
| Параметр | Claude Fable 5.1 |
|---|---|
| Входные токены | $10 / 1M |
| Выходные токены | $50 / 1M |
| Чтение из кэша | $0,25 / 1M (−75%) |
| Контекстное окно | до 1 млн токенов |
| Макс. вывод за ответ | 128 тыс. токенов |
Нюанс: экономия не гарантирована
Реальная экономия зависит от настройки уровня усилий. Независимые тесты аналитической компании Artificial Analysis показали: в режиме максимального усилия модель может генерировать заметно больше выходных токенов, и тогда отдельная задача выходит дороже, чем та же задача на Fable 5. Это особенно актуально для коротких запросов, где задействование расширенного рассуждения экономически нецелесообразно. По той же причине в расчёте на одну завершённую задачу AA Intelligence Index Fable 5.1 обходится примерно в $3,70 против ~$1,67 у GPT-6 Astra.
Правило простое: для рутинных задач используйте уровень Medium или Low, оставляя High и максимальный эффорт для сложного кода и научных вычислений. Для повседневных вопросов, которые обычно задают в окне ИИ чат, хватает и Low.
Fable 5.1 снижает стоимость агентной работы за счёт радикального удешевления кэша — это позволяет компаниям масштабировать долгие задачи без линейного роста расходов.— Anthropic, официальный анонс Claude Fable 5.1 и Mythos 5.1
Fable 5.1 против Mythos 5.1
Одна модель — два режима
Claude Fable 5.1 и Claude Mythos 5.1 — это технически одна и та же модель, настроенная на разные уровни защитных ограничений. Fable 5.1 доступна всем разработчикам через стандартный API с полным набором производственных предохранителей. Mythos 5.1 выдаётся только участникам программы доверенного доступа — проверенным организациям в области кибербезопасности и наук о жизни.
Ключевая разница не в интеллекте, а в том, какие типы запросов модель обрабатывает без блокировок. Для большинства разработчиков релевантна именно Fable 5.1. Что представляет собой Claude Mythos 5.1 и кому доступен доверенный режим — разбираем подробно.
Меньше ложных срабатываний
Anthropic сообщает, что ложные срабатывания в задачах кибербезопасности снизились на 60% по сравнению с исходным Fable 5. На безобидные вопросы по биологии и медицине — на 85%. Это важно для продуктов, где модель регулярно видит технические запросы и раньше необоснованно отказывала.
В научных прогонах Mythos 5.1 улучшал аффинность связывания белков примерно в 10 раз на 3 из 12 протестированных мишеней. Также модель помогла построить детализированную карту поверхности Венеры по снимкам зонда NASA Magellan — задача, требующая одновременно работы с большим объёмом данных и понимания предметной области.
Где доступна и как начать
Платформы и доступ
Claude Fable 5.1 доступна сегодня через Claude API, а также через облачные платформы: Amazon Bedrock, Google Cloud Vertex AI и Microsoft Azure AI Foundry. Идентификатор для запроса — claude-fable-5-1.
По умолчанию уровень усилий (effort) установлен в High в Claude Code и в Medium в Claude.ai. Уровень можно менять по ходу диалога, что позволяет гибко управлять балансом скорость/стоимость/качество. Как выбрать уровни усилий (effort) под конкретную задачу и не переплатить — в отдельном руководстве.
Документация к API описывает пять уровней усилий — low, medium, high, xhigh и max, по умолчанию в API стоит high. Основные из них:
- Low — быстрые ответы, минимальное рассуждение. Подходит для простых справочных запросов.
- Medium — баланс скорости и качества. Используется по умолчанию в Claude.ai.
- High — расширенное рассуждение, максимальная точность. Дефолт в API и Claude Code.
Кроме них есть xhigh для долгих агентных и кодинговых задач (дольше 30 минут) и максимальный (max) режим усилий для особо требовательных задач — например, комплексной отладки или автономного решения задач на CursorBench.
Как подключить Fable 5.1 в своём проекте
- Убедитесь, что ваш API-ключ действителен и у вас есть доступ к Claude API (или к нужному облачному провайдеру).
- Обновите версию библиотеки Anthropic SDK до последней — она добавила поддержку Fable 5.1.
- В запросе укажите
model: "claude-fable-5-1". - Задайте уровень усилий под вашу задачу:
effort: "low","medium","high","xhigh"или"max"; без параметра модель работает на high. - Если вы использовали
tool_choice: "any"илиtool_choice: "tool"— замените на поддерживаемые типы (auto,required). - Проверьте работу кэша: повторяющиеся системные промпты и контексты теперь обходятся в $0,25/1M токенов.
- Запустите тестовый прогон и сравните стоимость с Fable 5 — большинство агентных сценариев покажут снижение.
FAQ
Что такое Claude Fable 5.1?
Флагманская языковая модель Anthropic, выпущенная 1 сентября 2026 года как преемник Claude Fable 5. Ориентирована на агентное программирование, научную работу и долгие многоэтапные задачи. API-идентификатор — claude-fable-5-1, контекстное окно — до 1 млн токенов.
Чем Fable 5.1 отличается от Fable 5?
Выше результаты на ключевых бенчмарках: Terminal-Bench 4.0 — 55,8% против 42%, Terminal-Bench-Science — 52,6% против 24,7% (рост почти вдвое). Чтение из кэша подешевело на 75%, типовые задачи — на 25%, агентные сценарии — до 45%. Добавлена поддержка смены уровня усилий по ходу диалога.
Сколько стоит Claude Fable 5.1?
Базовые тарифы: $10 за 1M входных токенов и $50 за 1M выходных — без изменений. Чтение из кэша — $0,25 за 1M токенов (снижение на 75% относительно Fable 5).
Что такое Claude Mythos 5.1?
Та же модель, что и Fable 5.1, но с ослабленными защитными ограничениями. Доступна только по программе доверенного доступа для проверенных организаций в кибербезопасности и науках о жизни. Ложные срабатывания в кибербез-задачах снизились на 60%, на биомедицинские запросы — на 85%.
Где доступна модель Fable 5.1?
Через официальный Claude API (anthropic.com/api), а также на платформах Amazon Web Services, Google Cloud и Microsoft Azure. Идентификатор модели: claude-fable-5-1.
Что такое эффорт-тиры в Fable 5.1?
Уровни усилий (low / medium / high / xhigh / max), которые управляют глубиной рассуждения модели. В API и Claude Code по умолчанию стоит High, в Claude.ai — Medium. Теперь уровень можно менять прямо по ходу диалога, не перезапуская сессию.
Гарантирована ли экономия при переходе с Fable 5?
Для большинства агентных задач — да, за счёт удешевления кэша. Но в режиме максимального усилия модель может генерировать больше выходных токенов, и короткие задачи иногда обходятся дороже. Независимые тесты Artificial Analysis подтвердили этот нюанс.
Что выбрать: Fable 5.1 или GPT-6 Astra?
Fable 5.1 — для рассуждений, длинных агентных сессий в Claude Code и сценариев с активным кэшем: кэш в 4 раза дешевле, Intelligence Index выше (66 против 61,2). Astra — для сложной математики, computer use, автоматизации и минимальной стоимости завершённой задачи: ~$1,67 против ~$3,70 по AA Intelligence Index.
-
Маршрут от Claude привёл подростка на «Вдоводел»
![Подросток в синей куртке и шлеме радостно смотрит маршрут в телефоне на вершине горы над городом]()
16-летний Брайс из Ванкувера проложил с Claude новый для себя маршрут на гору Краун. ![Подросток с рюкзаком неуверенно пробирается между валунами к крутому гребню]()
Разметки не было: вместо кулуара он попал на гребень «Вдоводел», куда ходят с верёвками. ![Испуганный подросток прижался к отвесной скале на узком уступе и звонит по телефону]()
Брайс застрял на уступе шириной около полутора метров: сзади обрыв, впереди почти отвесная стена. ![Спасатель спускается по верёвке к подростку на уступе, рядом вертолёт]()
Вертолёт не мог подойти к скале: спасатель спустился к Брайсу по верёвке, и его подняли на борт. ![Подросток в спасательном одеяле сидит у тропы с бумажной картой, рядом компас]()
Брайс винит себя, но тропы через ИИ больше не прокладывает. Спасатель: «Claude никогда не был в этих местах». -
950 агентов Claude нашли в ДНК вирусов загадочную систему
![Учёная в лаборатории смотрит на монитор со спиралями ДНК]()
Anthropic поручила Claude найти в огромной базе ДНК необычные ферменты. ![Учёная с планшетом смотрит на стену из сотен мониторов с ДНК]()
Около 950 агентов за 21 час собрали больше 200 тысяч ферментов и написали 20 отчётов. ![Учёная взволнованно показывает на повторяющийся узор в цепочке ДНК на экране]()
Один агент «на глаз» заметил рядом с ферментом повторы, как у CRISPR. Систему назвали ART. ![Учёная поднимает пробирку к свету, коллега задумчиво смотрит рядом]()
Что она делает, пока неизвестно. Пионер CRISPR Фэн Чжан назвал находку «по-настоящему интригующей». -
Anthropic запретила издеваться над Claude
![Женщина в очках сердито кричит на ноутбук и стучит кулаком по столу]()
Anthropic запретила «длительное и бессмысленное» жестокое обращение с Claude. ![Женщина спокойно спорит, разводя рукой перед ноутбуком]()
Речь о крайних случаях. Раздражение, споры, мрачные сюжеты и тесты под запрет не попадают. ![Удивлённая женщина смотрит на ноутбук со значком закрытой двери на экране]()
Главная защита прежняя: Claude сам завершает такой диалог. ![Женщина прикрепляет к доске календарь с обведённым днём]()
Правила действуют с 12 ноября. За нарушения доступ могут ограничить или закрыть. -
ИИ-видео с погибшим в суде: срок назначат заново
![Женщина в зале суда показывает планшет с лицом мужчины]()
В Аризоне сестра погибшего показала в суде видео, где ИИ-аватар брата прощает убийцу. ![Растроганный судья с рукой на груди за судейским столом]()
Судья дал максимальные 10,5 года и сказал, что ему «понравилось это видео». ![Три судьи апелляционного суда изучают документы]()
Апелляционный суд счёл приговор несправедливым: видео «не отражает реальных событий». ![Женщина читает своё заявление с листов за трибуной, планшет выключен]()
Срок назначат заново, а свой текст сестра прочитает сама, без видео. -
Журналист выпустил ИИ-песню от имени чужой группы
![Журналист в наушниках с хитрой улыбкой работает за ноутбуком]()
Журналист 404 Media сгенерировал песню в Udio по простому запросу. ![Трое музыкантов панк-группы в шоке смотрят в телефон]()
Трек вышел на подтверждённой странице панк-группы Lathe of Heaven в Spotify без ведома музыкантов. ![Журналист удивлённо разводит руками, вокруг висят значки музыкальных сервисов]()
Песня попала и в Apple Music, Tidal и Amazon Music — через давнюю лазейку в дистрибуции. ![Довольный мошенник ловит монеты, сыплющиеся из наушников, слушательница расстроена]()
Так мошенники зарабатывают на чужой славе. Площадки и дистрибьюторы ответственность не берут. -
Нейросеть научилась играть в «Точки» и обыгрывает автора
![Разработчик держит тетрадь в клетку с партией в точки]()
Разработчик учил нейросеть игре в «Точки» из школьной тетради — по примеру AlphaZero. ![Разработчик ночью смотрит на два монитора с партиями в точки]()
Сеть играла сама с собой: 30 поколений за полтора месяца, однажды девять пришлось выбросить. ![Разработчик радостно подпрыгивает перед монитором с выигранной партией]()
Ученик обыграл учителя, только когда поиск подняли с 800 до 1600 симуляций на ход. ![Разработчик смеётся, проиграв нейросети партию в точки]()
Теперь сложный уровень игры Just Dots стабильно обыгрывает автора на поле 20×20.
























