 FlipИИ чат
Ещё
Нейросети
-
Gemini
Gemini
-
Z.ai
Z.ai
-
ChatGPT
ChatGPT
-
DeepSeek
DeepSeek
-
Claude
Claude
-
Jev
Jev
-
Perplexity
Perplexity
-
OpenAI
OpenAI
-
Kimi
Kimi
-
Qwen
Qwen
-
Grok
Grok
-
Все модели
Все модели
-
Задачи
Задачи





Terminal-Bench: бенчмарк для ИИ-агентов в терминале — версии и результаты моделей

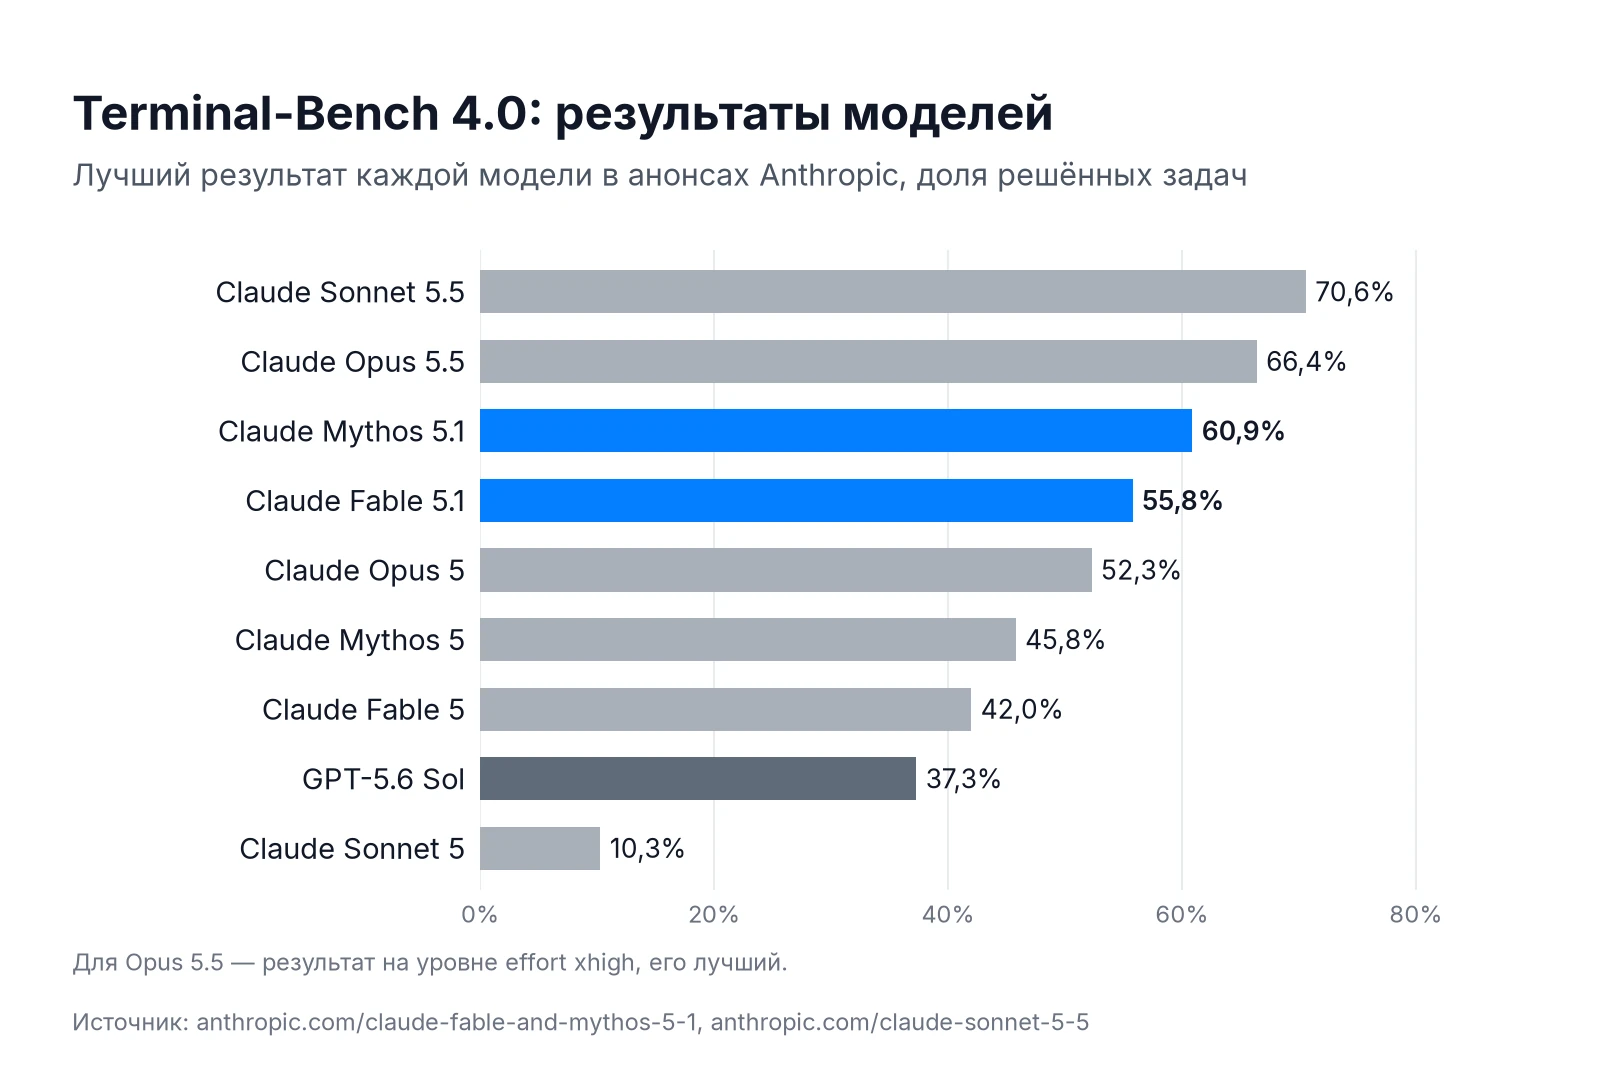
Terminal-Bench — открытый бенчмарк для оценки ИИ-моделей на реальных задачах в командной строке: отладке кода, работе с файловой системой и многошаговых агентных сценариях. Методология опубликована в официальном репозитории на GitHub. Claude Fable 5.1 набирает на этом тесте 55,8%, а лучшие результаты сейчас у Claude Sonnet 5.5 (70,6%) и Claude Opus 5.5 (66,4%). Что ещё умеет Клод, кроме терминальных задач, — в общем обзоре.
Что измеряет Terminal-Bench
Ключевая идея — проверять не знания, а способность действовать. Агент получает задачу в реальной Linux-среде: инструменты, терминал, объективный критерий успеха. Задача засчитана только при проверяемом результате — запустился ли скрипт, прошли ли тесты.
Бенчмарк охватывает:
- отладку и исправление кода в реальных репозиториях
- многошаговые сценарии с несколькими инструментами
- написание и запуск тестов с автоверификацией
- взаимодействие с внешними API и сервисами
Полный список поддерживаемых моделей и их идентификаторов — в обзоре моделей Anthropic.
Terminal-Bench 4.0: таблица результатов
Четвёртая версия — основной инструмент оценки агентного программирования с длинными цепочками инструментов и проверкой на устойчивость к ошибкам.
| Модель | Terminal-Bench 4.0 |
|---|---|
| Claude Sonnet 5.5 | 70,6% |
| Claude Opus 5.5 | 66,4% |
| Claude Mythos 5.1 | 60,9% |
| Claude Fable 5.1 | 55,8% |
| Opus 5 | 52,3% |
| Claude Fable 5 | 42,0% |
| GPT-5.6 Sol | 37,3% |
Прирост Fable 5.1 к предшественнику — 13,8 п.п. Официальные результаты опубликованы в анонсе Claude Fable 5.1.
Агентные бенчмарки на реальных задачах — единственный объективный способ сравнивать модели для инженерных сценариев.Anthropic, документация по tool use
Terminal-Bench-Science 0.1: наука и вычисления
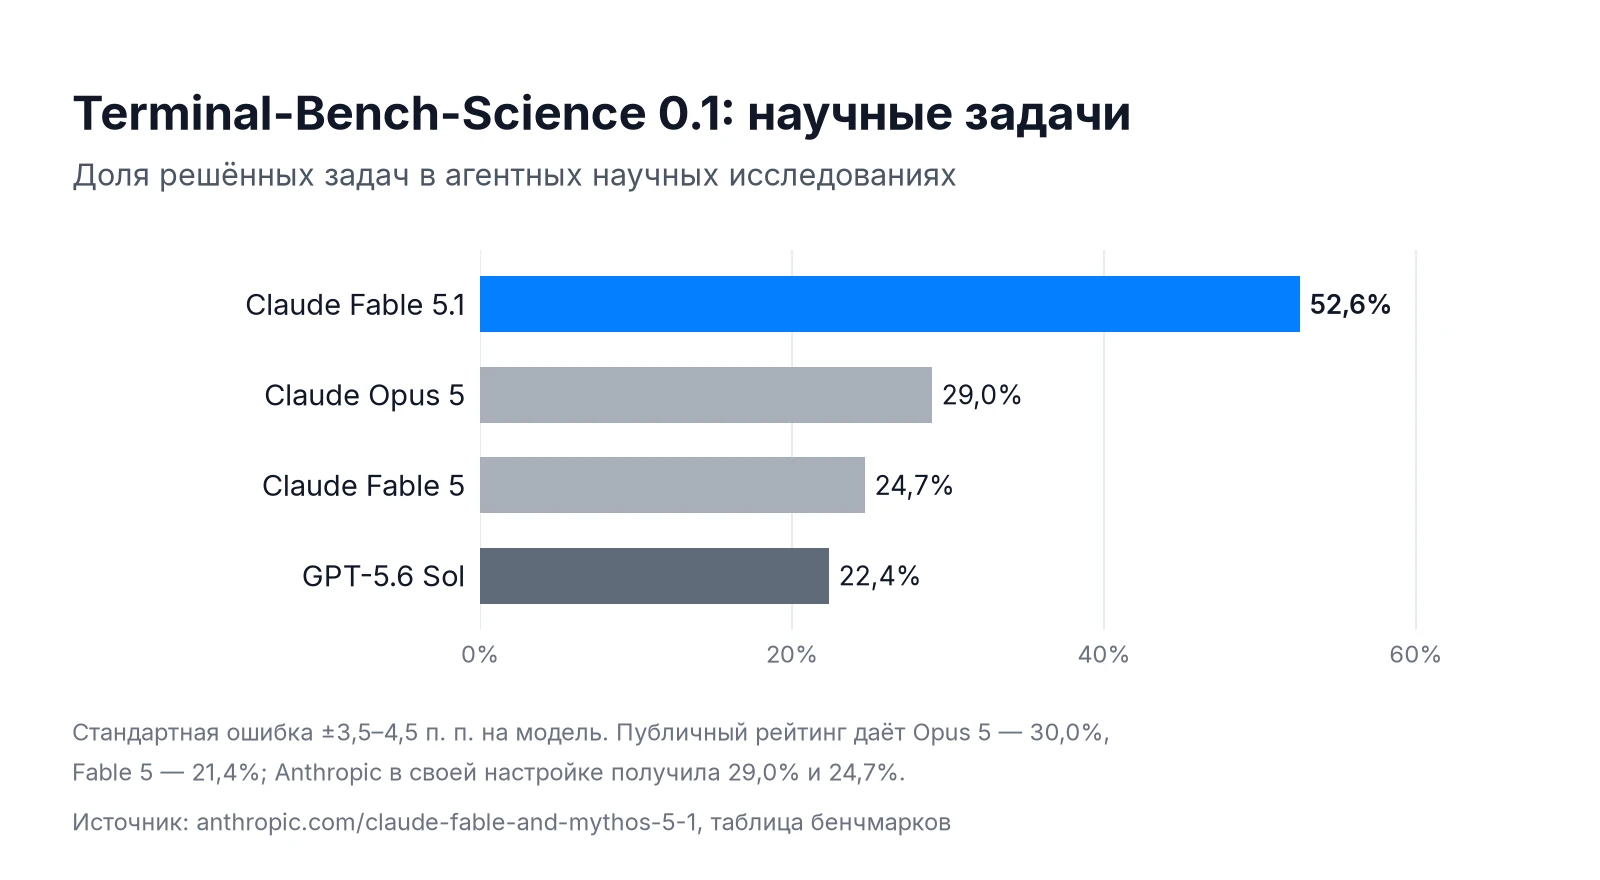
Научная версия — задачи по анализу данных, символьной математике и биоинформатике. Claude Fable 5.1 набирает 52,6%, тогда как Fable 5 остановился на 24,7% — рост почти вдвое.
| Модель | Terminal-Bench-Science 0.1 |
|---|---|
| Claude Fable 5.1 | 52,6% |
| Claude Fable 5 | 24,7% |
Если вас интересует, как эффорт-тиры влияют на качество агентных задач, читайте о системе управления усилиями модели.
Как выбирать модель по данным Terminal-Bench
Terminal-Bench — не единственный агентный тест: OSWorld 2.0 проверяет управление GUI (Fable 5.1 — 77,9%/41,7%), CursorBench 3.2.0 — IDE-ассистенты (73,4%), GDPval-AA v2 — аналитику (1853 балла). Бенчмарки задают ориентир, но поведение модели на своих задачах проще проверить самому: попробовать ИИ онлайн бесплатно можно в ограниченной версии. Вот практические советы:
- Смотрите на абсолютный процент, а не только на ранг: разница 55%→60% в продакшне — десятки лишних итераций в неделю.
- Science-версию проверяйте отдельно — она релевантна лишь при задачах с научными вычислениями.
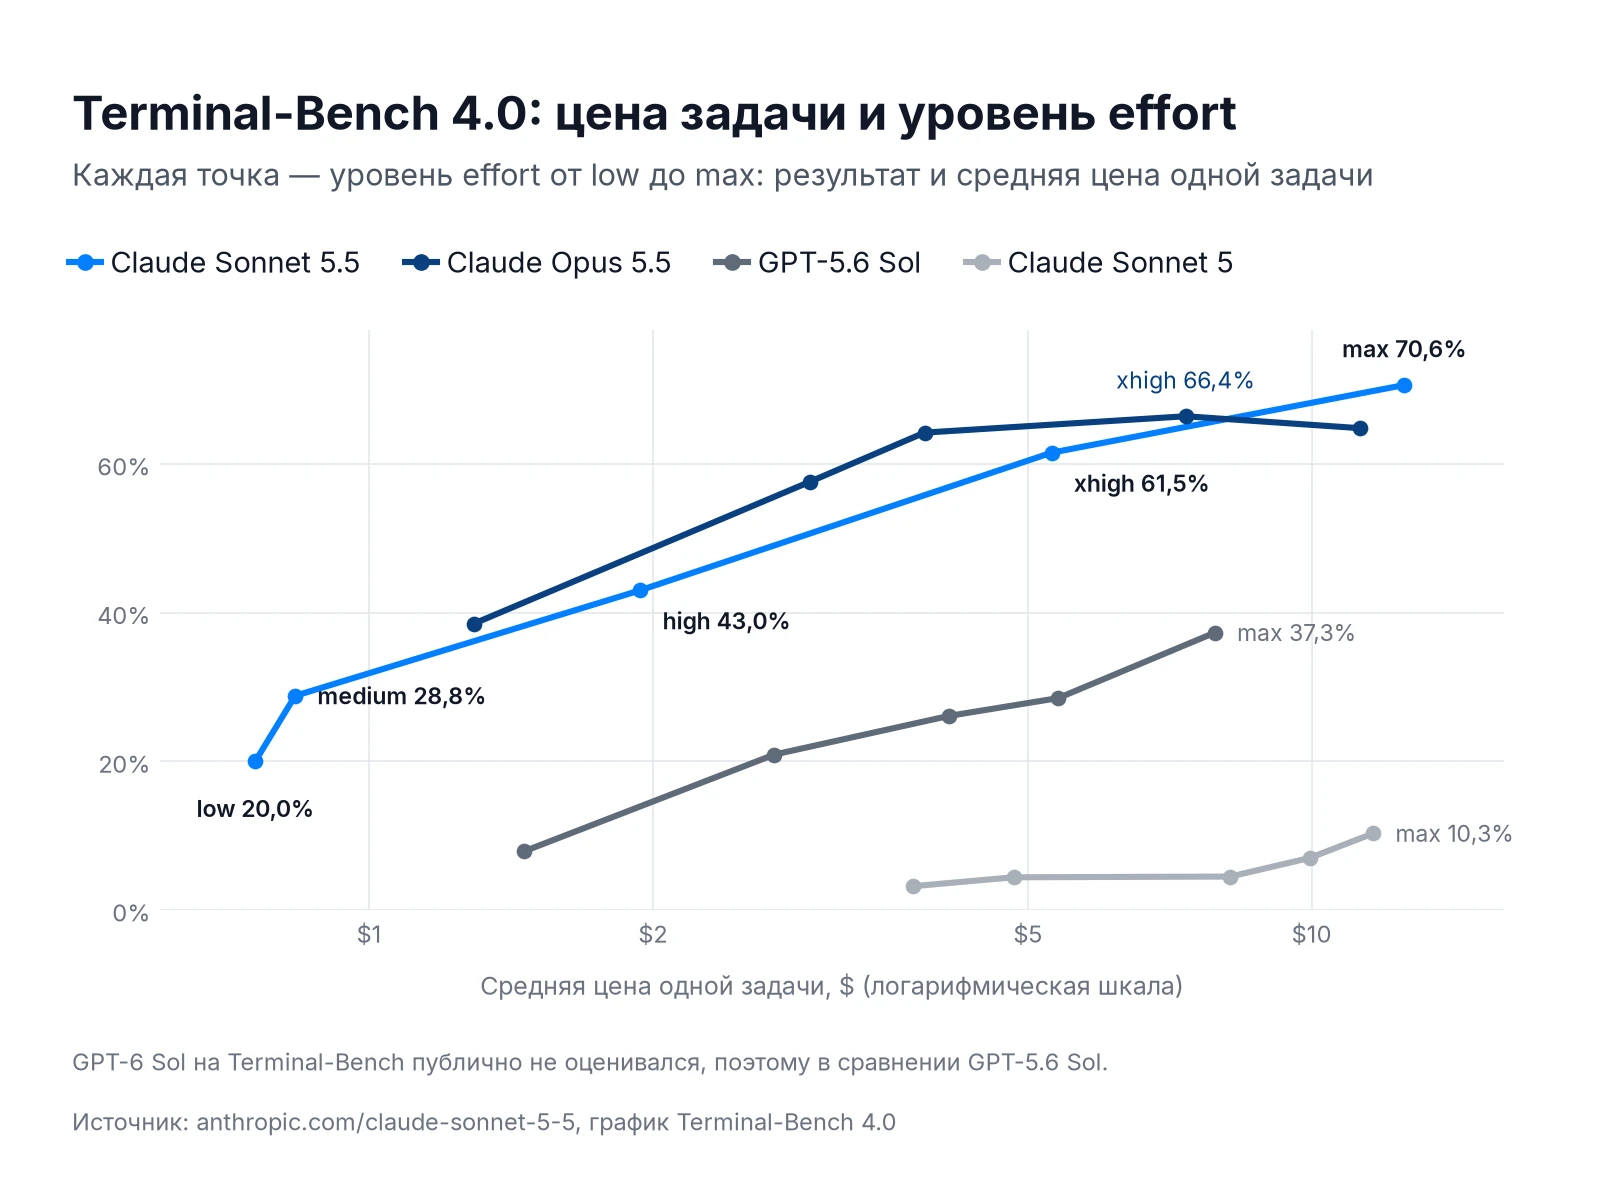
- Уточняйте, при каком режиме усилий получен результат: CursorBench —
effort=max, это влияет на стоимость. - Дополняйте Terminal-Bench данными из OSWorld 2.0, если задача включает GUI или браузер.
Модель доступна на AWS Bedrock, Google Cloud и Azure. Стоимость агентных прогонов сильно зависит от кэша — подробнее в статье о кэшировании промптов в Claude.
FAQ
Что такое Terminal-Bench?
Terminal-Bench — открытый бенчмарк для оценки ИИ-агентов на реальных задачах в командной строке: отладке кода, работе с файлами и многошаговых агентных сценариях. Задача считается решённой только при объективно проверяемом результате.
Что измеряет Terminal-Bench?
Бенчмарк измеряет способность ИИ-модели действовать в реальной Linux-среде: запускать команды, исправлять ошибки в коде, взаимодействовать с инструментами и завершать многоэтапные задачи с проверяемым результатом.
Какие версии Terminal-Bench существуют?
Основная версия — Terminal-Bench 4.0 (агентное программирование и DevOps-задачи). Отдельная ветка — Terminal-Bench-Science 0.1, нацеленная на научные вычисления, биоинформатику и численный анализ.
Какой результат показывает Claude Fable 5.1 на Terminal-Bench?
На Terminal-Bench 4.0 — 55,8% (против 42% у Fable 5). На Terminal-Bench-Science 0.1 — 52,6% (против 24,7% у Fable 5, рост почти вдвое). Лучшие результаты — у Claude Sonnet 5.5 (70,6%) и Claude Opus 5.5 (66,4%), у Claude Mythos 5.1 — 60,9%.
Чем Terminal-Bench отличается от других бенчмарков?
Terminal-Bench проверяет реальное выполнение задач в терминале, а не ответы с вариантами. Результат объективен — сработал код или нет. OSWorld 2.0 фокусируется на GUI, CursorBench — на IDE-ассистентах.
Почему Terminal-Bench важен для оценки ИИ-агентов?
Реальная полезность модели определяется способностью действовать, а не знаниями. Terminal-Bench — один из немногих тестов, где нельзя угадать правильный ответ: нужно выполнить задачу в реальной среде.
-
Маршрут от Claude привёл подростка на «Вдоводел»
![Подросток в синей куртке и шлеме радостно смотрит маршрут в телефоне на вершине горы над городом]()
16-летний Брайс из Ванкувера проложил с Claude новый для себя маршрут на гору Краун. ![Подросток с рюкзаком неуверенно пробирается между валунами к крутому гребню]()
Разметки не было: вместо кулуара он попал на гребень «Вдоводел», куда ходят с верёвками. ![Испуганный подросток прижался к отвесной скале на узком уступе и звонит по телефону]()
Брайс застрял на уступе шириной около полутора метров: сзади обрыв, впереди почти отвесная стена. ![Спасатель спускается по верёвке к подростку на уступе, рядом вертолёт]()
Вертолёт не мог подойти к скале: спасатель спустился к Брайсу по верёвке, и его подняли на борт. ![Подросток в спасательном одеяле сидит у тропы с бумажной картой, рядом компас]()
Брайс винит себя, но тропы через ИИ больше не прокладывает. Спасатель: «Claude никогда не был в этих местах». -
950 агентов Claude нашли в ДНК вирусов загадочную систему
![Учёная в лаборатории смотрит на монитор со спиралями ДНК]()
Anthropic поручила Claude найти в огромной базе ДНК необычные ферменты. ![Учёная с планшетом смотрит на стену из сотен мониторов с ДНК]()
Около 950 агентов за 21 час собрали больше 200 тысяч ферментов и написали 20 отчётов. ![Учёная взволнованно показывает на повторяющийся узор в цепочке ДНК на экране]()
Один агент «на глаз» заметил рядом с ферментом повторы, как у CRISPR. Систему назвали ART. ![Учёная поднимает пробирку к свету, коллега задумчиво смотрит рядом]()
Что она делает, пока неизвестно. Пионер CRISPR Фэн Чжан назвал находку «по-настоящему интригующей». -
Anthropic запретила издеваться над Claude
![Женщина в очках сердито кричит на ноутбук и стучит кулаком по столу]()
Anthropic запретила «длительное и бессмысленное» жестокое обращение с Claude. ![Женщина спокойно спорит, разводя рукой перед ноутбуком]()
Речь о крайних случаях. Раздражение, споры, мрачные сюжеты и тесты под запрет не попадают. ![Удивлённая женщина смотрит на ноутбук со значком закрытой двери на экране]()
Главная защита прежняя: Claude сам завершает такой диалог. ![Женщина прикрепляет к доске календарь с обведённым днём]()
Правила действуют с 12 ноября. За нарушения доступ могут ограничить или закрыть. -
ИИ-видео с погибшим в суде: срок назначат заново
![Женщина в зале суда показывает планшет с лицом мужчины]()
В Аризоне сестра погибшего показала в суде видео, где ИИ-аватар брата прощает убийцу. ![Растроганный судья с рукой на груди за судейским столом]()
Судья дал максимальные 10,5 года и сказал, что ему «понравилось это видео». ![Три судьи апелляционного суда изучают документы]()
Апелляционный суд счёл приговор несправедливым: видео «не отражает реальных событий». ![Женщина читает своё заявление с листов за трибуной, планшет выключен]()
Срок назначат заново, а свой текст сестра прочитает сама, без видео. -
Журналист выпустил ИИ-песню от имени чужой группы
![Журналист в наушниках с хитрой улыбкой работает за ноутбуком]()
Журналист 404 Media сгенерировал песню в Udio по простому запросу. ![Трое музыкантов панк-группы в шоке смотрят в телефон]()
Трек вышел на подтверждённой странице панк-группы Lathe of Heaven в Spotify без ведома музыкантов. ![Журналист удивлённо разводит руками, вокруг висят значки музыкальных сервисов]()
Песня попала и в Apple Music, Tidal и Amazon Music — через давнюю лазейку в дистрибуции. ![Довольный мошенник ловит монеты, сыплющиеся из наушников, слушательница расстроена]()
Так мошенники зарабатывают на чужой славе. Площадки и дистрибьюторы ответственность не берут. -
Нейросеть научилась играть в «Точки» и обыгрывает автора
![Разработчик держит тетрадь в клетку с партией в точки]()
Разработчик учил нейросеть игре в «Точки» из школьной тетради — по примеру AlphaZero. ![Разработчик ночью смотрит на два монитора с партиями в точки]()
Сеть играла сама с собой: 30 поколений за полтора месяца, однажды девять пришлось выбросить. ![Разработчик радостно подпрыгивает перед монитором с выигранной партией]()
Ученик обыграл учителя, только когда поиск подняли с 800 до 1600 симуляций на ход. ![Разработчик смеётся, проиграв нейросети партию в точки]()
Теперь сложный уровень игры Just Dots стабильно обыгрывает автора на поле 20×20.
























