 FlipИИ чат
Ещё
Нейросети
-
Gemini
Gemini
-
Z.ai
Z.ai
-
ChatGPT
ChatGPT
-
DeepSeek
DeepSeek
-
Claude
Claude
-
Jev
Jev
-
Perplexity
Perplexity
-
OpenAI
OpenAI
-
Kimi
Kimi
-
Qwen
Qwen
-
Grok
Grok
-
Все модели
Все модели
-
Задачи
Задачи





Как писать промпты для Claude: приёмы, которые дают разницу в ответе

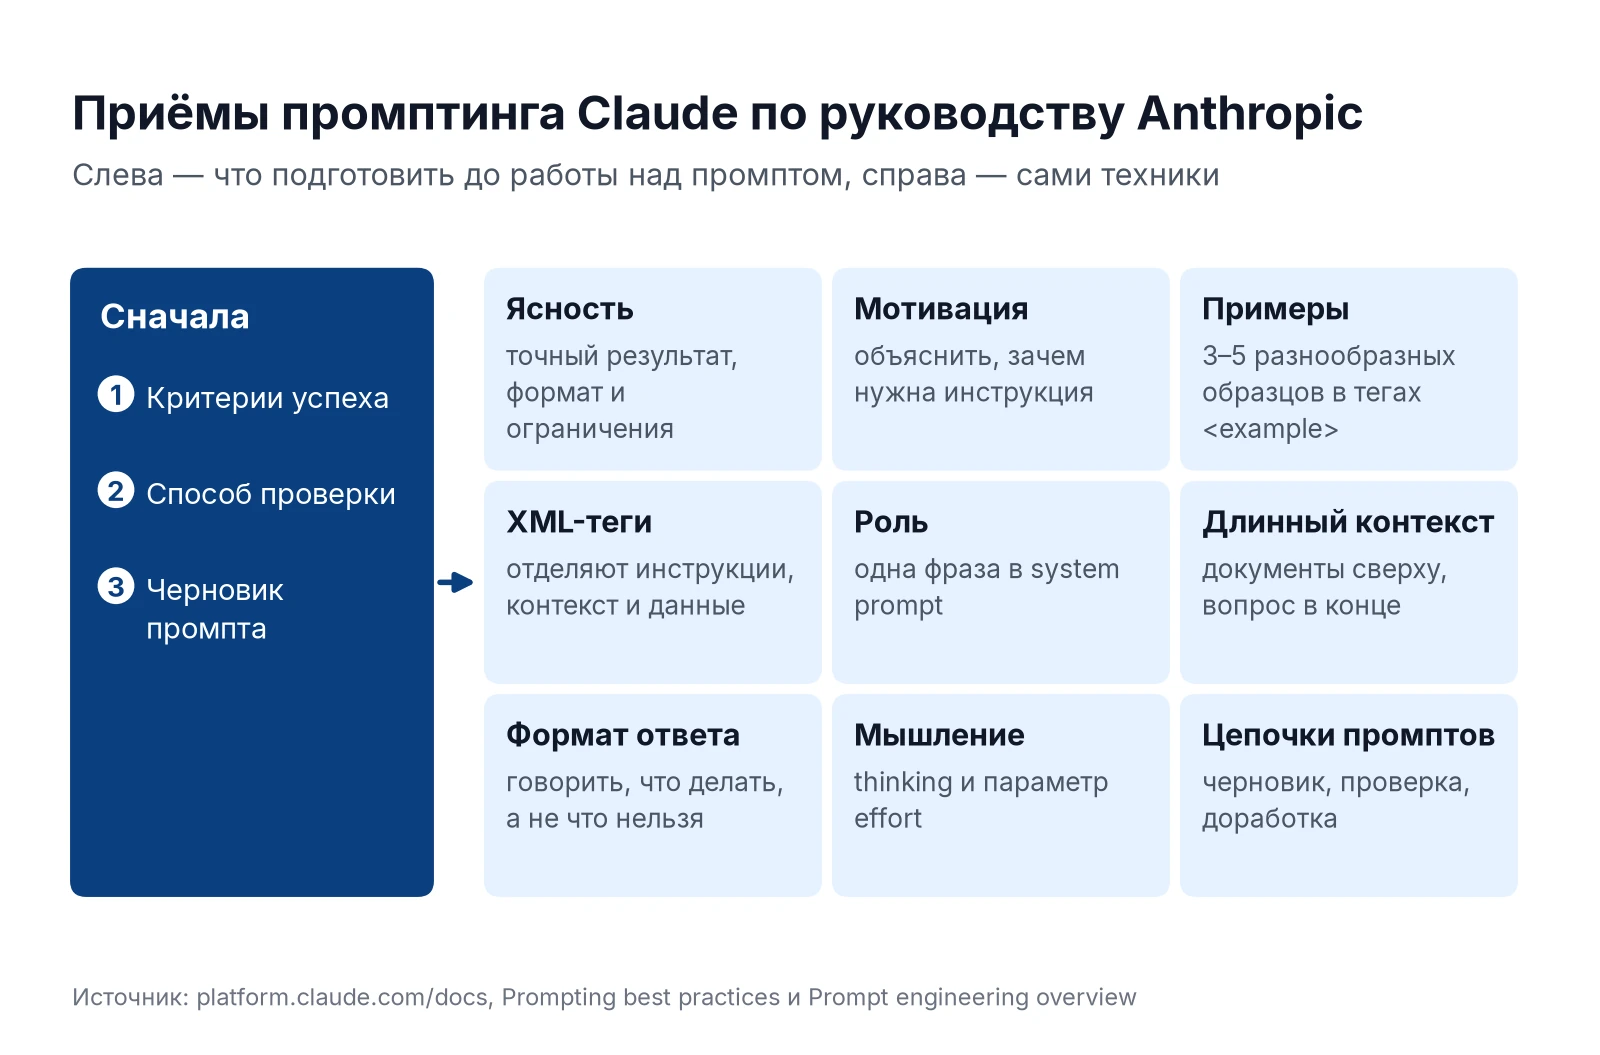
Умение составлять промпты для Claude — это не поиск магической фразы, а точная спецификация задачи: нужный результат, формат, контекст и примеры. В обзоре Claude AI собраны ключевые сведения о модели, а документация Anthropic описывает промпт-инжиниринг как набор техник — от ясности и примеров до XML-структурирования, ролей, пошагового мышления и цепочек промптов — и рекомендует начинать с определения критериев успеха и способа их измерения. Как начать работу и что ещё умеет нейросеть Клауд, рассказано в общем обзоре.
Claude читает промпт как единый документ и опирается на то, что явно указано: где инструкция, а где материал, какой формат нужен, зачем вообще делается задача. Чем меньше догадок остаётся модели, тем предсказуемее результат.
В статье разберём каждый приём по порядку — от базовой ясности до extended thinking и цепочек промптов — с конкретными примерами, готовым шаблоном и чек-листом ошибок. Отдельно отметим, что в новых версиях Claude уже устарело, например prefill.
Что такое промпт-инжиниринг для Claude и почему приёмы меняют ответ
Промпт-инжиниринг — это составление точной спецификации задачи для Claude, а не поиск волшебной фразы, поэтому формулировка напрямую определяет ответ. Промпт — входной текст-запрос, а практика его составления называется инженерией подсказок: цель не угадать нужное слово, а описать задачу так, чтобы у модели не оставалось пробелов для домыслов. Языковая модель Claude от Anthropic обрабатывает инструкцию, контекст и материал как единое целое, поэтому разные формулировки одного вопроса закономерно дают разные ответы.
Промпт как спецификация задачи
Хороший промпт работает как техническое задание: он сообщает, что нужно сделать, в каком виде выдать результат и что считается успехом. Именно поэтому Anthropic рекомендует до любой доработки запроса определить критерии успеха и способ их измерения — иначе итерации превращаются в угадывание.
Инженерия подсказок охватывает несколько техник, которые устраняют пробелы в задании:
- Ясность и конкретность инструкции
- Контекст и мотивация задачи
- Примеры желаемого результата (few-shot / multishot)
- XML-разметка для разделения блоков
- Роль и правила в system prompt
- Управление форматом и длиной вывода
- Пошаговое мышление и extended thinking
- Цепочки промптов для сложных задач
Как Claude читает промпт
Claude обрабатывает весь промпт как единый документ и опирается на явные указания — где инструкция, где данные, какой формат ожидается и зачем вообще выполняется задача. Если какой-то из этих элементов не указан явно, модель заполняет пробел своим предположением, и именно здесь качество ответа начинает расходиться с ожиданиями.
Приёмы промпт-инжиниринга не меняют саму модель — они убирают неоднозначность, и составление запроса становится управляемым процессом с предсказуемым результатом. Понимание этого механизма объясняет, почему даже небольшое уточнение инструкции нередко даёт качественный скачок в ответе.
Ясность и конкретность: приём, который даёт самую большую разницу
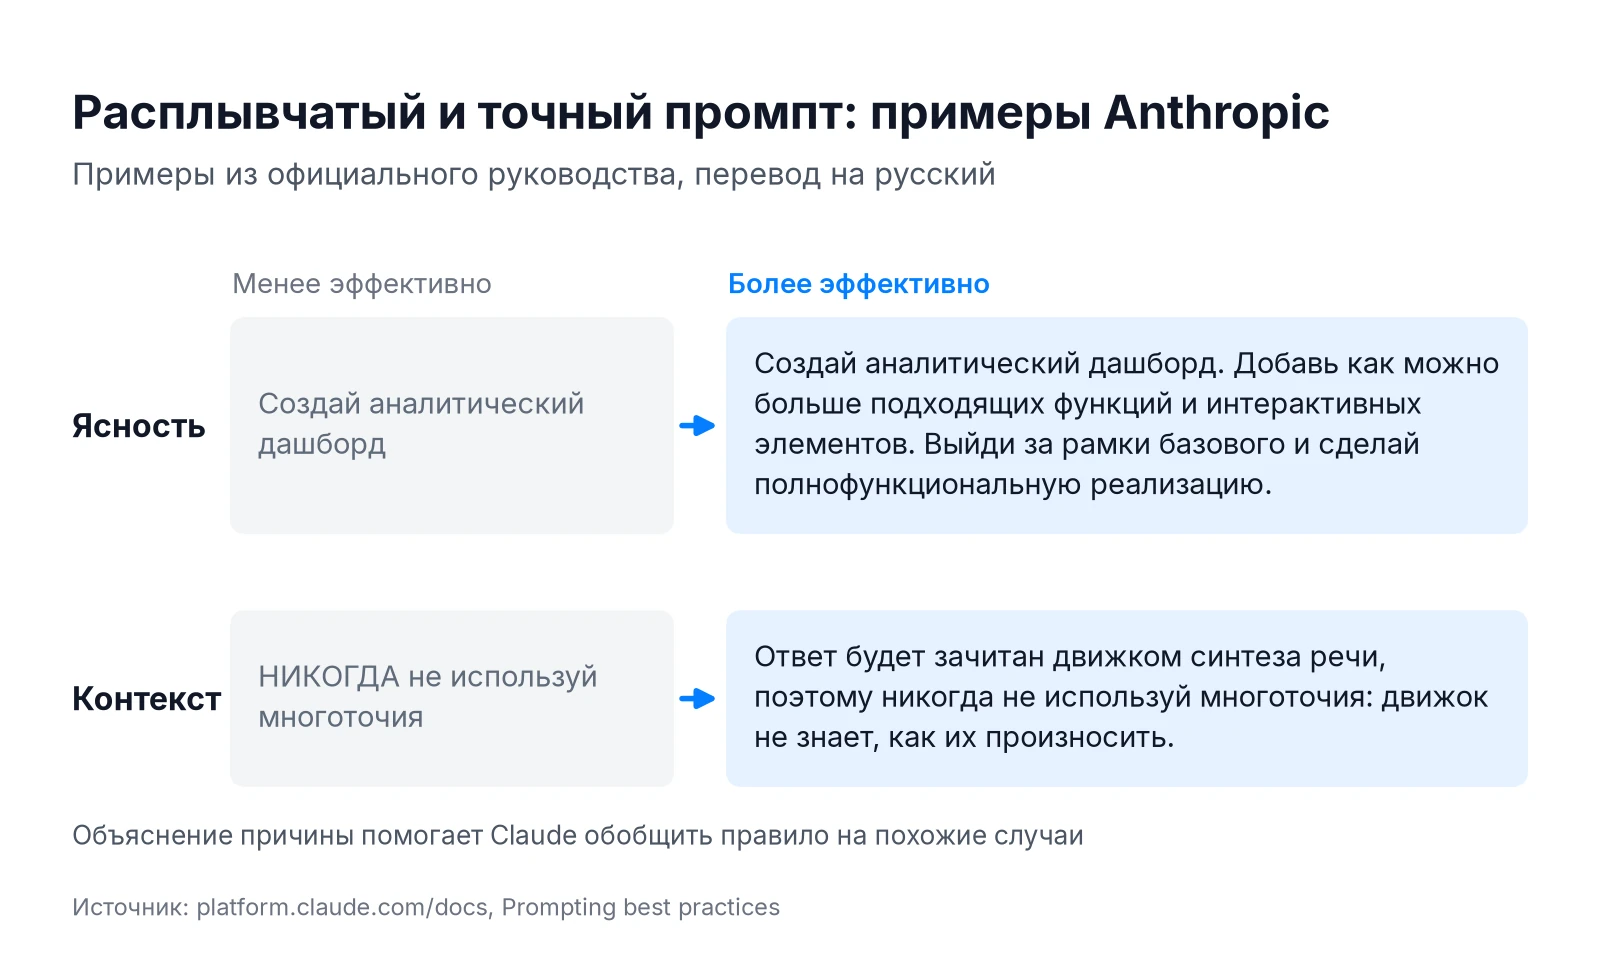
Самую большую разницу в ответе даёт ясность: точное описание результата, формата и ограничений превращает расплывчатый запрос в выполнимую задачу. Ясность инструкции даёт наибольший прирост качества ответа ещё до применения остальных техник, потому что без неё даже роль, примеры и XML-теги не спасают от неверного вывода.
Что конкретизировать: результат, формат, объём, ограничения
Конкретный запрос отвечает на четыре вопроса: что именно нужно на выходе, в каком формате это выдать, какой объём уместен и где границы задачи. Пример перехода от расплывчатого к точному: «напиши про маркетинг» → «напиши 5 пунктов списком: идеи постов для Telegram-канала о кофейне, тон дружелюбный, по одному предложению каждый».
Полезный чек-лист конкретики:
- Что именно нужно (текст, список, таблица, JSON, код)
- Формат вывода и структура
- Объём: число слов, пунктов, символов или предложений
- Ограничения: что нельзя включать, какой тон, уровень сложности
- Целевая аудитория или контекст использования
Одна задача — один явный результат
Склеенные задачи — частая причина неудовлетворительного ответа. Если целей несколько, перечислите их явно и по порядку: сначала проанализируй, затем сформулируй, наконец отформатируй. Модель исполняет написанное, а не угадывает подразумеваемое, и две неявно совмещённые цели дадут компромисс, а не решение каждой.
Избегайте двусмысленных формулировок вроде «сделай лучше» или «улучши стиль» — они не содержат критерия качества. Замените их на конкретное: «перепиши каждый абзац так, чтобы предложения не превышали двух строк, и замени пассивный залог активным».
Контекст и мотивация: зачем объяснять Claude причину задачи
Контекст и мотивация повышают точность: когда Claude знает, для кого и зачем делается задача, он выбирает уместные детали и тон лучше, чем по голому приказу. Контекст и мотивация задачи дают модели возможность самостоятельно принять верные решения там, где инструкция молчит.
Что дать в контексте: аудитория, цель, ограничения проекта
Релевантный контекст включает несколько компонентов: кто читатель ответа, где и как он будет использован, какой уровень сложности допустим, что уже известно исполнителю. Одна и та же задача «объясни принцип работы API» с контекстом «для разработчика, знакомого с REST» и «для менеджера без технического бэкграунда» даст принципиально разный ответ — и оба будут правильными.
Объём контекста важно держать под контролем: сообщайте то, что прямо влияет на выбор тона, структуры или содержания. Свалка деталей без связи с задачей засоряет промпт и рассеивает внимание модели по нерелевантным сведениям.
Мотивация работает лучше приказа
Короткое «зачем» направляет модель эффективнее сухой команды. Добавление «это пойдёт в письмо клиенту, поэтому нужен вежливый тон без профессионального жаргона» задаёт сразу три параметра: регистр, аудиторию и стиль — без явного перечисления каждого.
Мотивация особенно полезна при нестандартных требованиях. Если вы просите сделать что-то непривычным способом, объяснение причины снижает вероятность «исправления» модели и позволяет ей адаптироваться к реальным ограничениям проекта, а не к стандартному сценарию.
Примеры в промпте: few-shot и multishot
Примеры управляют форматом ответа надёжнее любых описаний: несколько образцов нужного результата показывают Claude, чего вы хотите, точнее, чем словесная инструкция. Few-shot примеры управляют форматом ответа надёжнее описаний именно потому, что модель видит конкретный желаемый паттерн, а не пытается угадать его по абстрактным словам.
Сколько примеров и какими они должны быть
Руководство Anthropic советует 3–5 примеров. Примеры должны быть разнообразными и репрезентативными: хорошо, если они покрывают граничные случаи — неожиданный формат входа, исключение из правила, нестандартную длину. Примеры должны совпадать по формату с желаемым выводом: если нужна таблица, показывайте таблицу, а не её словесное описание.
Однотипные примеры сужают диапазон генерации, и модель воспроизводит единственный паттерн вместо гибкого применения правила. Противоречивые образцы, где вход похож, а вывод разный без очевидной причины, сбивают модель и снижают стабильность результата.
Как оформлять примеры
Надёжнее всего оборачивать примеры в XML-теги: внешний тег <examples>, внутри пары <example> с явно выделенными <input> и <output>. Такая структура исключает случай, когда модель воспринимает демонстрацию как часть задания, а не как образец.
Для сложных задач внутри примера можно показать и ход рассуждения — это особенно полезно, когда нужен не просто нужный формат, но и нужный тип аргументации. Если вы добавляете рассуждение в образец, придерживайтесь той же структуры во всех примерах: непоследовательность в демонстрациях хуже, чем их отсутствие.
XML-теги: как отделить инструкцию от материала
XML-теги отделяют инструкцию от материала и данных, чтобы Claude не перепутал, где задание, а где текст, который нужно обработать. Когда в одном промпте смешаны инструкция, большой документ, примеры и требования к формату, без явных границ модель может трактовать части промпта неверно.
Какие теги использовать
Anthropic рекомендует несколько стандартных тегов для типовых блоков:
<instructions>— сама инструкция-задание<context>— фоновая информация и мотивация<document>или<input>— материал для обработки<examples>/<example>— демонстрационные пары<output_format>— требования к виду ответа
Имена тегов произвольны — главное, чтобы они были согласованными внутри одного промпта и системного набора. Если вы используете <doc> вместо <document>, модель поймёт, но смешивать разные имена для одного и того же блока не стоит.
Вот как выглядит типовая структура:
<instructions>Кратко резюмируй документ в 3 пунктах.</instructions>
<document>{{текст_документа}}</document>
<output_format>Маркированный список, каждый пункт — одно предложение.</output_format>
Когда теги обязательны
Применяйте теги всегда, когда промпт содержит хотя бы два разнородных блока. Для выбора ориентируйтесь на следующее правило:
- Определите, сколько смысловых блоков содержит промпт: инструкция, данные, примеры, формат.
- Если блоков два и больше, введите теги для каждого.
- Подберите согласованные имена тегов и зафиксируйте их для всего проекта.
- Оберните данные и документы в теги в первую очередь — именно они чаще всего смешиваются с инструкцией.
- Проверьте, что открывающий и закрывающий теги стоят правильно и не разбивают предложение пополам.
Для коротких запросов из одной инструкции теги избыточны. Чем длиннее и разнороднее промпт — особенно когда в него входит большой документ плюс примеры плюс требования к формату — тем больше пользы от явной разметки: она снижает число интерпретационных ошибок и делает промпт проще для итерации.
Роль и system prompt: как задать поведение Claude
Роль в system prompt задаёт тон и поведение Claude: указание «ты — редактор-корректор» фокусирует стиль и приоритеты ответа с первого же взаимодействия. Роль в system prompt задаёт тон и поведение Claude ещё до того, как пользователь пишет первое сообщение, и эффективнее переопределять её один раз глобально, чем повторять в каждом запросе.
Где писать роль и что в неё класть
Общее правило такое: роль и постоянные правила поведения идут в system prompt, конкретная задача — в сообщение пользователя. В системный промпт стоит включить экспертизу и область знаний, тон и регистр общения, ограничения поведения (что модель не делает), а также аудиторию, которой адресованы ответы. Для постоянных рабочих инструкций удобно использовать постоянные инструкции в Projects — они применяются автоматически без повторного ввода. Приёмы из этого раздела работают не только в Claude: их можно проверить на других моделях, если попробовать ИИ онлайн бесплатно в ограниченной версии.
Пример короткого системного промпта: «Ты — технический редактор SaaS-продукта. Пишешь на русском языке. Используешь активный залог, избегаешь канцелярита. Ответы лаконичны: если задача решена в двух абзацах, не растягивай на пять».
Роль плюс правила, а не только роль
Одна строка «ты — эксперт по маркетингу» без ясной задачи и требований к формату мало меняет качество ответа. Роль усиливает эффект в паре с конкретной инструкцией: она задаёт фрейм, а инструкция определяет действие внутри него.
Хорошо спроектированный системный промпт содержит роль, ограничения поведения и один-два примера типичного правильного ответа. Такой prompt сокращает расхождение между ожиданиями и результатом даже при вариативных пользовательских запросах — модель удерживает стиль и приоритеты, заданные один раз.
Мышление, формат ответа и длинный контекст
Пошаговое мышление и extended thinking
Пошаговое мышление улучшает решение сложных задач, а в новых моделях его берёт на себя встроенное адаптивное мышление, которое заменяет ручной chain of thought. Классический chain of thought и современный режим адаптивного мышления решают одну проблему — недостаточную глубину рассуждения — но принципиально разными способами.
Ручной chain of thought — запасной вариант для моделей, у которых мышление выключено: попросите Claude продумать задачу перед ответом, а финальный ответ выдать в тегах <answer>, чтобы его было удобно извлечь. На Fable 5.1, Opus 5.5, Opus 5 и Sonnet 5.5 полагайтесь на встроенное мышление (при необходимости с пониженным effort): просьбу выписать рассуждение, например в тегах <thinking>, модель может отклонить. Этот приём особенно полезен для логических задач, математики, юридического анализа и любой ситуации, где промежуточные шаги влияют на правильность вывода. Явное разделение рассуждения и ответа делает ошибку видимой и исправимой.
В актуальных моделях Anthropic пошаговое мышление встроено на уровне архитектуры. В моделях Claude 4.6 применяется адаптивное управление глубиной рассуждений, а глубина рассуждений управляется параметром effort вместо ручного budget_tokens. Это снижает порог входа: не нужно подбирать количество токенов, достаточно указать уровень усилий.
Anthropic рекомендует давать модели высокоуровневую инструкцию «подумай глубоко над задачей», а не прописывать пошаговый ход мысли — потому что модель может найти более удачный способ рассуждения, чем тот, который очевиден человеку. Жёсткое предписание шагов ограничивает это пространство.
| Приём | Когда применять | Как включить |
|---|---|---|
| Chain of thought (ручной) | Модели с выключенным мышлением | «продумай задачу перед ответом» + ответ в тегах <answer> |
| Extended thinking (адаптивный) | Сложные многошаговые задачи | thinking: adaptive, параметр effort |
| Высокоуровневая инструкция | Любая глубокая задача | «подумай глубоко перед ответом» |
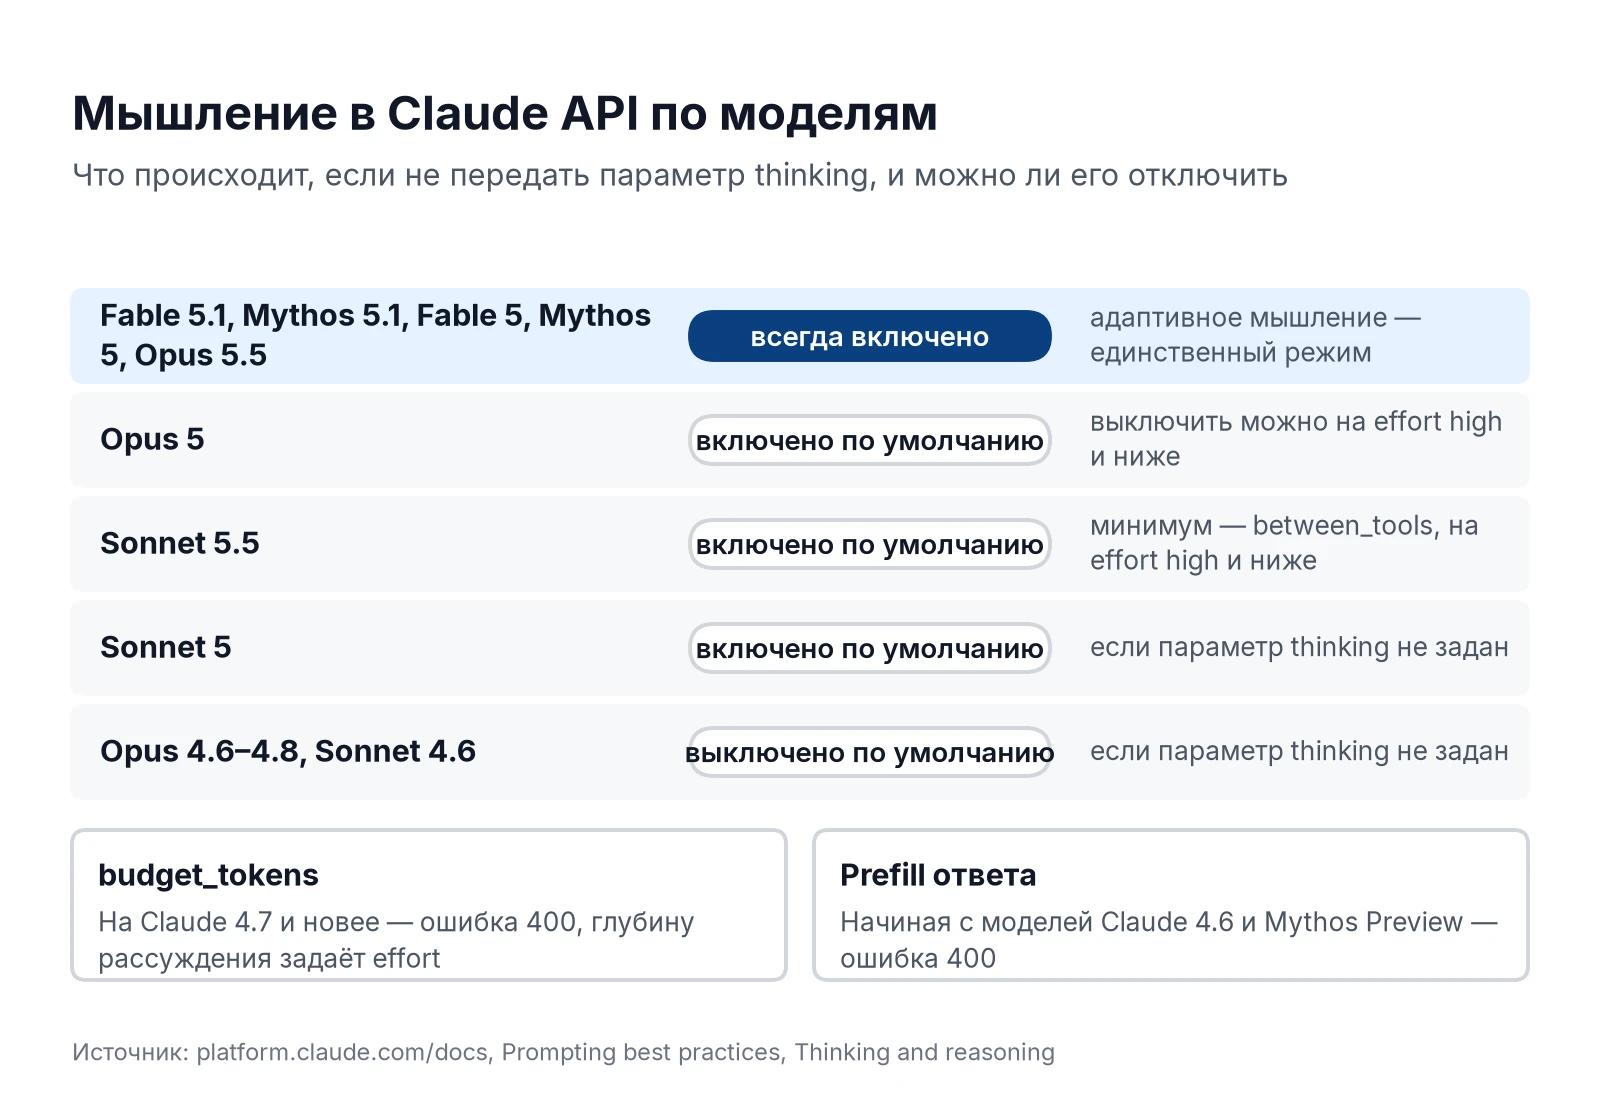
При включённом режиме thinking предзаполнение ответа (prefill) недоступно — эти два механизма несовместимы. Если задача требует глубокого рассуждения, пользуйтесь thinking вместо prefill. Возможности расширенного мышления наиболее полно реализованы во флагманском Opus 5.5, хотя адаптивный режим поддерживают и другие модели семейства Claude Sonnet 5.
Формат, длина и позитивные инструкции
Позитивная формулировка работает лучше запрета. Вместо «не используй markdown» напишите «пиши сплошными абзацами без заголовков и списков» — и заодно явно задайте формат и длину вывода. Позитивная формулировка работает лучше запрета что-то не делать, потому что она даёт модели конкретную цель, а не список исключений.
Формат нужно называть явно. Полезный набор инструкций по формату включает:
- Тип структуры: таблица, нумерованный список, маркированный список, JSON, проза
- Длина: число предложений, слов, пунктов или символов
- Пример-шаблон вывода, если структура нестандартная
- Тег
<output_format>для явного выделения требований в промпте
Хорошая практика — показать пустой шаблон вывода: «ответ должен выглядеть так: | Параметр | Значение |». Это точнее словесного описания.
Запреты без альтернативы хуже инструкции. «Не пиши длинно» не даёт модели цели — замените на «уложись в три предложения». «Не используй пассивный залог» менее эффективно, чем «переформулируй все глаголы в активный залог». Конкретная цель измерима, запрет — нет.
Если промпт содержит несколько требований к формату, перечислите их списком в одном блоке <output_format>, а не рассыпайте по тексту. Когда требования к формату разбросаны по промпту, часть из них теряется при обработке длинного контекста.
Длинный контекст и цепочки промптов
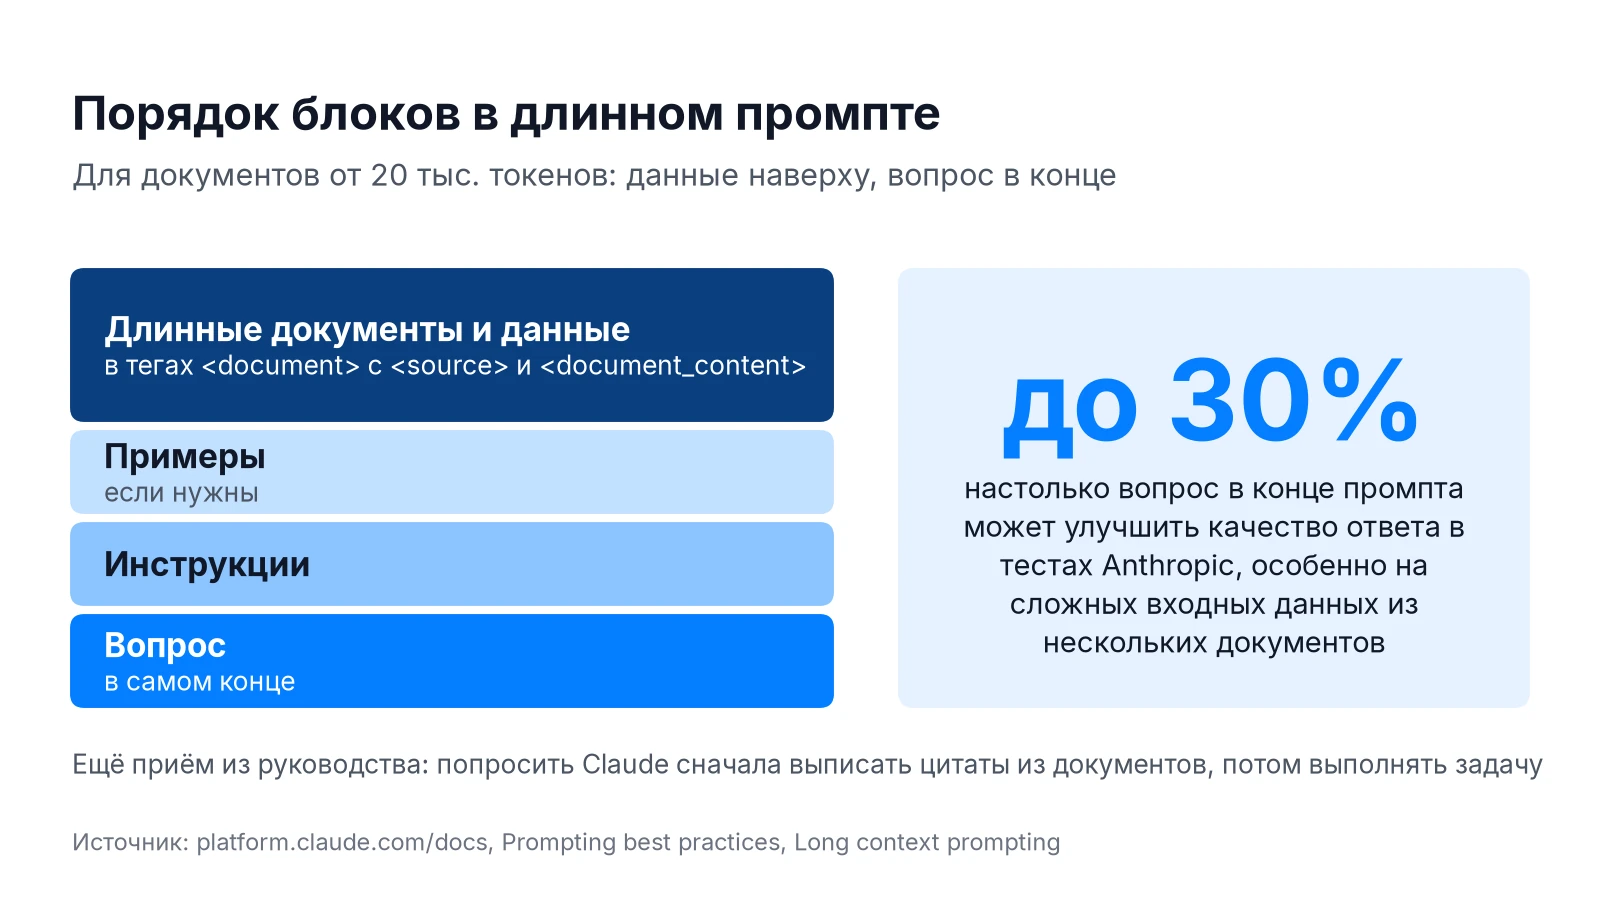
В длинном промпте данные ставят в начало, а вопрос — в конец, а по-настоящему сложную задачу разбивают цепочкой промптов на подзадачи. Данные в начале длинного промпта повышают качество ответа на вопрос в конце, а prompt chaining разбивает сложную задачу на подзадачи, каждая из которых получает полное внимание модели.
Возможности приёмов зависят в том числе от доступного размера контекстного окна — чем оно больше, тем длиннее документы и цепочки, с которыми можно работать без разбивки.
Порядок блоков в большом промпте
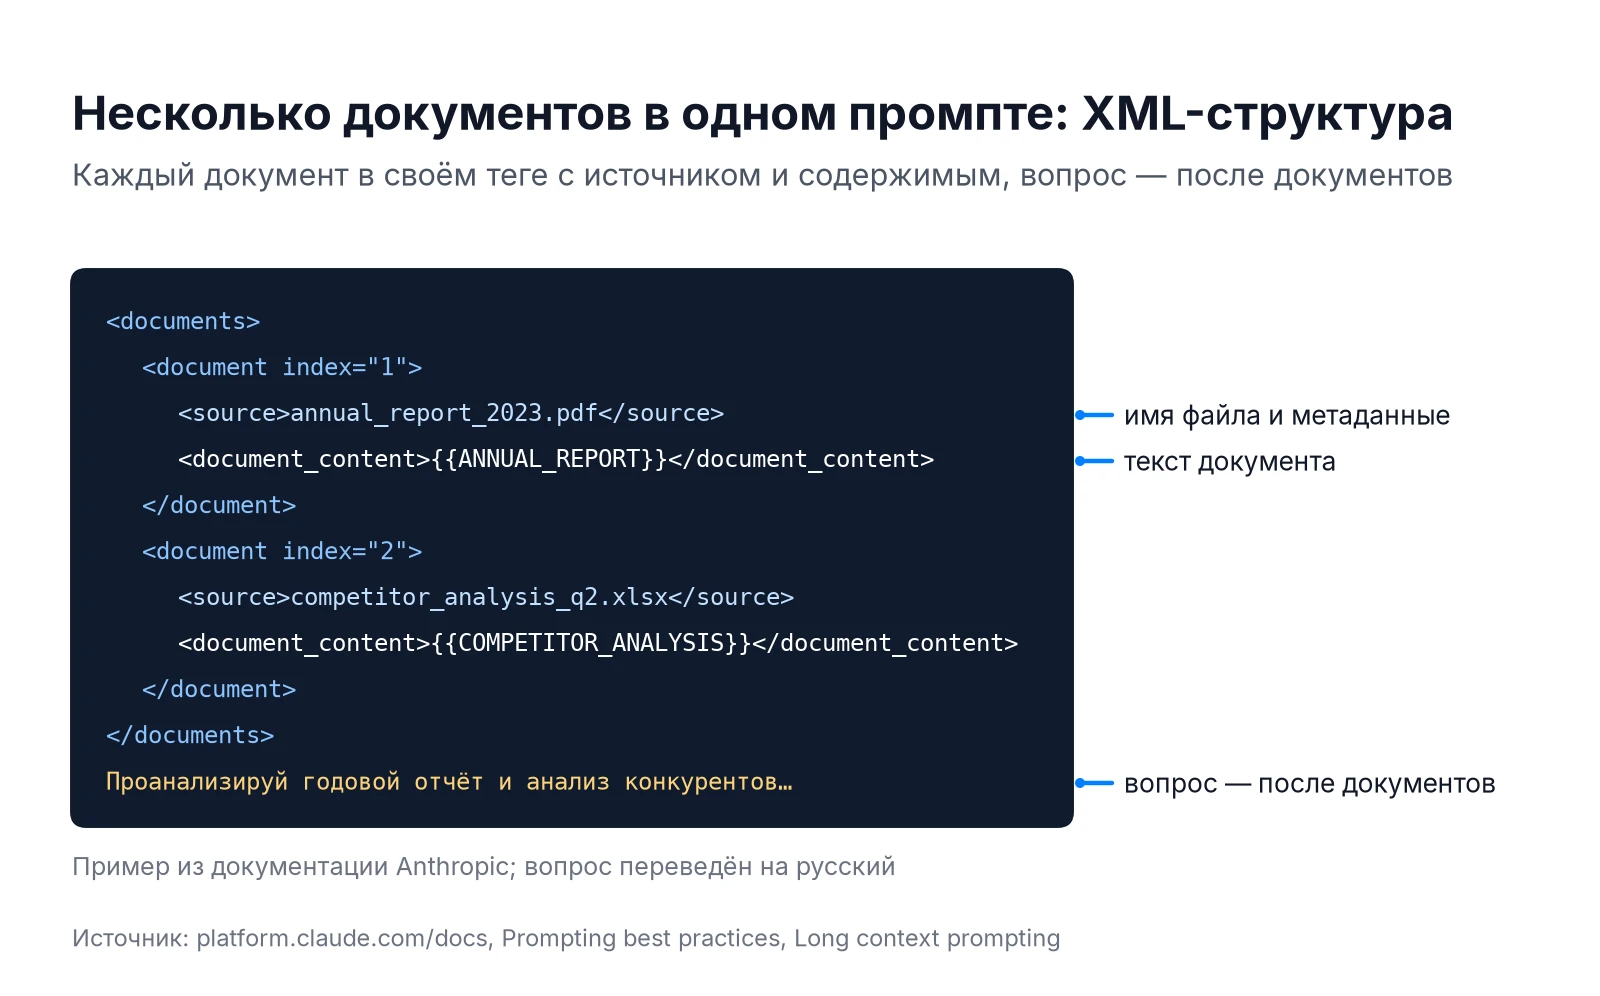
Стандартный порядок для длинного промпта: сначала документы и данные, затем примеры, в конце — инструкция и конкретный вопрос. Этот порядок обусловлен тем, как модель строит контекст: к моменту, когда она доходит до задания, весь материал уже загружен в рабочую память.
Оборачивайте документы в теги — например, <document id="1"> для каждого файла, если их несколько. Это помогает модели ссылаться на конкретный источник в ответе и снижает вероятность смешения данных из разных блоков.
| Порядок блоков | Структура промпта |
|---|---|
| 1 | Документы и данные (<document>) |
| 2 | Примеры (<examples>) |
| 3 | Инструкция (<instructions>) |
| 4 | Конкретный вопрос / задание |
Цепочки промптов вместо одного гигантского
Цепочки промптов (prompt chaining) разбивают сложную задачу на подзадачи, каждая из которых получает полное внимание модели, что снижает число ошибок и потерянных шагов. Практический пример трёхшагового pipeline: первый промпт извлекает релевантные факты из документа, второй структурирует их по разделам, третий пишет финальный текст на основе структуры.
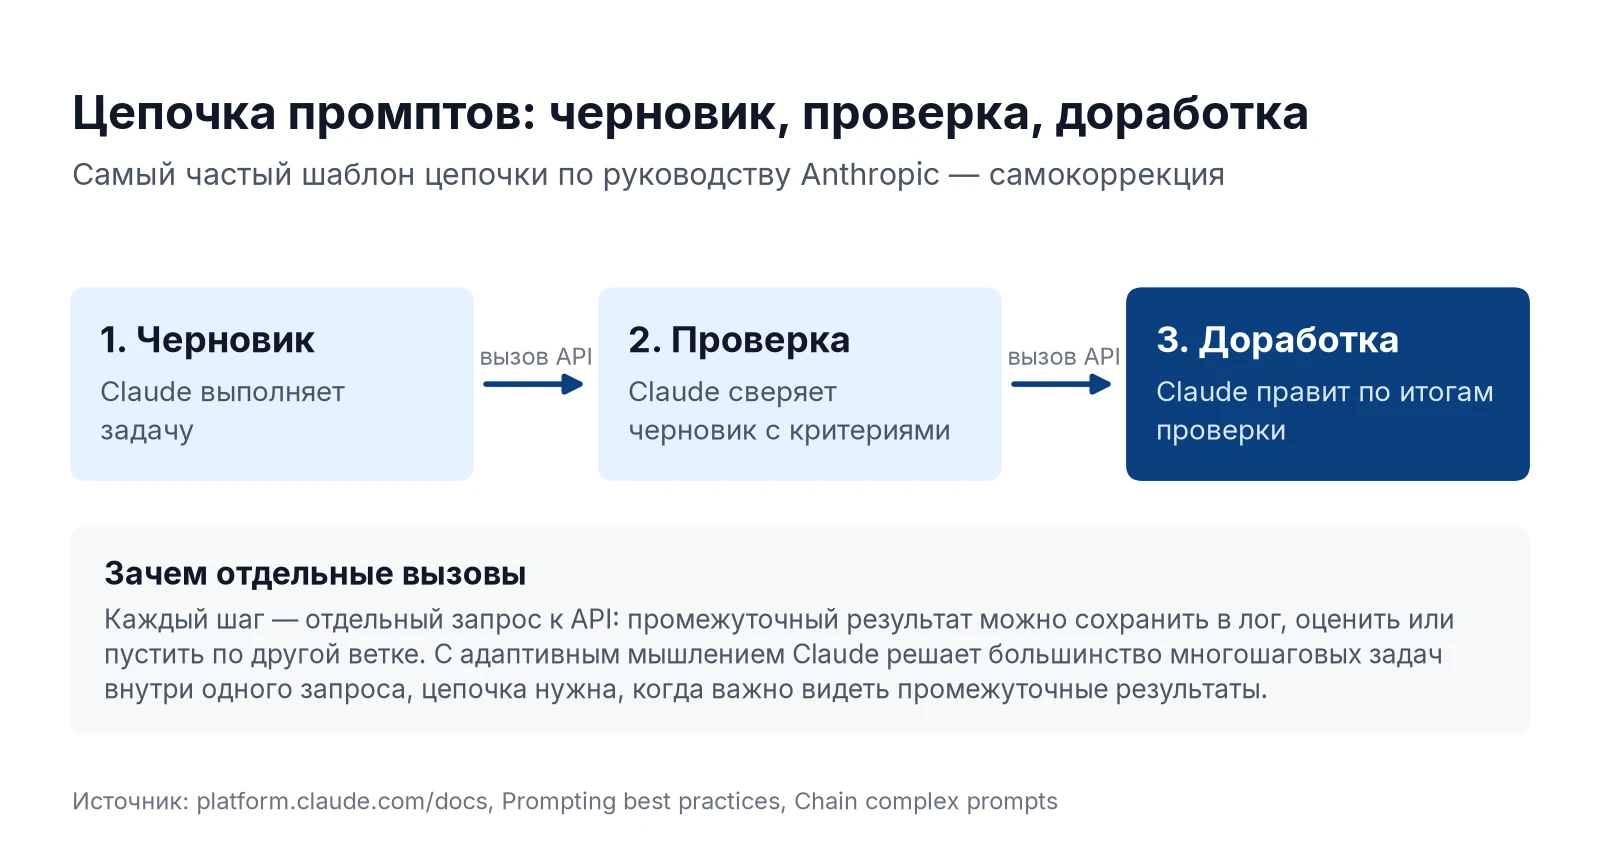
Такой подход проще отлаживать: если ошибка возникла на этапе структурирования, вы исправляете только второй промпт, не переделывая всю цепочку. Каждый шаг допускает независимую проверку и итерацию.
Prefill: что изменилось в новых моделях
Предзаполнение ответа (prefill) на последнем ходе ассистента больше не поддерживается в новых моделях Claude — такой запрос возвращает ошибку. Раньше prefill позволял задать начало ответа, управляя тем, как модель продолжит текст.
В актуальных версиях роль prefill закрывают другие инструменты: явная инструкция по формату в <output_format>, пример нужного вывода в <examples> и при необходимости включение адаптивного мышления. Если ваши промпты использовали prefill, перепишите их на явные инструкции по формату — это одновременно и обход ограничения, и улучшение читаемости промпта.
Как проверять промпт, частые ошибки и готовый шаблон
Промпт дорабатывают итерациями по заранее заданным критериям успеха, а типовые ошибки — расплывчатость, запреты и склеенные задачи — исправляют по чек-листу и готовому шаблону. Критерии успеха и evals нужны до доработки промпта: без них итерации превращаются в субъективное «нравится / не нравится».
Критерии успеха и итерации
До первой итерации ответьте на два вопроса: что конкретно считается хорошим ответом и как это проверить — на одном примере, наборе тест-кейсов или автоматическим eval. После этого цикл выглядит так: сформулировать промпт → проверить на нескольких разных примерах → изменить один параметр → проверить снова. Менять сразу несколько элементов не стоит: тогда непонятно, что именно дало улучшение.
Anthropic предоставляет два вспомогательных инструмента. Prompt Improver в консоли берёт ваш промпт и автоматически предлагает улучшенную версию с объяснением изменений. Метапромпт — генератор промптов, которому можно описать задачу на естественном языке, и он составит базовый промпт как отправную точку.
Частые ошибки, которые портят ответ
Большинство неудачных промптов повторяют один из нескольких паттернов. Расплывчатая цель без критерия результата, отсутствие явного формата вывода, запреты вместо позитивных инструкций, склеенные задачи без явного порядка — каждый из них в отдельности уже снижает качество. Свалка нерелевантного контекста рассеивает внимание модели; отсутствие примеров оставляет формат на усмотрение модели; агрессивные или угрожающие формулировки не повышают качество ответа, но нередко меняют его тон в нежелательную сторону.
Готовый шаблон промпта
Ниже — структура промпта, которая покрывает большинство задач. Не все блоки нужны всегда, но их порядок устойчив и помогает ничего не пропустить:
Системный промпт:<role> — кто Claude в этом контексте, экспертиза, тон, ограничения поведения
Сообщение пользователя:<context> — для кого, зачем, что уже известно<document> / <input> — материал для обработки (если есть)<examples> — несколько пар вход/выход (если нужны)<instructions> — конкретная задача, одна цель<output_format> — тип структуры, объём, шаблонФинальная строка: «Подумай глубоко перед ответом» — только для сложных многошаговых задач
Начните с минимального промпта — роль, инструкция, формат — и добавляйте блоки по мере необходимости. Простая задача решается тремя блоками; сложный pipeline потребует всех.
FAQ
Чем промпт для Claude отличается от промпта для ChatGPT?
Claude хорошо воспринимает XML-теги для разделения частей промпта и явный контекст с мотивацией задачи — это работает лучше, чем у большинства других моделей. Кроме того, Claude следует высокоуровневым инструкциям на рассуждение глубже, не требуя жёсткого пошагового скрипта.
Работает ли prefill (предзаполнение ответа) в новых моделях Claude?
Нет, в новых моделях Claude предзаполнение ответа на последнем ходе ассистента не поддерживается: такой запрос возвращает ошибку.
Сколько примеров нужно добавлять в промпт?
Руководство Anthropic советует 3–5 примеров. Важно, чтобы они покрывали разные случаи задачи и демонстрировали нужный формат и стиль ответа.
Нужно ли просить Claude думать шаг за шагом?
Anthropic рекомендует давать высокоуровневую инструкцию «подумай глубоко над задачей», а не прописывать пошаговый ход мысли — модель может найти более удачный способ рассуждения самостоятельно.
Куда класть большой документ в промпте?
Большой текст или документ лучше размещать перед инструкцией, оборачивая его в XML-теги. Так модель сначала получает весь материал, а затем понимает, что именно с ним нужно сделать.
Что такое цепочки промптов и зачем они нужны?
Цепочки промптов разбивают сложную задачу на подзадачи, каждая из которых обрабатывается отдельным запросом. Это снижает число ошибок и потерянных шагов, потому что каждая подзадача получает полное внимание модели.
Есть ли инструмент, который улучшит промпт автоматически?
Anthropic предлагает встроенный генератор промптов в Workbench: он создаёт структурированный system prompt на основе краткого описания задачи. Это хорошая отправная точка, которую затем стоит дорабатывать под конкретные критерии успеха.
Почему запреты в промпте работают хуже, чем позитивные инструкции?
Запрет описывает, чего не делать, но не подсказывает, что делать вместо этого. Позитивная инструкция даёт модели конкретное направление и снижает вероятность неожиданной интерпретации.
-
Маршрут от Claude привёл подростка на «Вдоводел»
![Подросток в синей куртке и шлеме радостно смотрит маршрут в телефоне на вершине горы над городом]()
16-летний Брайс из Ванкувера проложил с Claude новый для себя маршрут на гору Краун. ![Подросток с рюкзаком неуверенно пробирается между валунами к крутому гребню]()
Разметки не было: вместо кулуара он попал на гребень «Вдоводел», куда ходят с верёвками. ![Испуганный подросток прижался к отвесной скале на узком уступе и звонит по телефону]()
Брайс застрял на уступе шириной около полутора метров: сзади обрыв, впереди почти отвесная стена. ![Спасатель спускается по верёвке к подростку на уступе, рядом вертолёт]()
Вертолёт не мог подойти к скале: спасатель спустился к Брайсу по верёвке, и его подняли на борт. ![Подросток в спасательном одеяле сидит у тропы с бумажной картой, рядом компас]()
Брайс винит себя, но тропы через ИИ больше не прокладывает. Спасатель: «Claude никогда не был в этих местах». -
950 агентов Claude нашли в ДНК вирусов загадочную систему
![Учёная в лаборатории смотрит на монитор со спиралями ДНК]()
Anthropic поручила Claude найти в огромной базе ДНК необычные ферменты. ![Учёная с планшетом смотрит на стену из сотен мониторов с ДНК]()
Около 950 агентов за 21 час собрали больше 200 тысяч ферментов и написали 20 отчётов. ![Учёная взволнованно показывает на повторяющийся узор в цепочке ДНК на экране]()
Один агент «на глаз» заметил рядом с ферментом повторы, как у CRISPR. Систему назвали ART. ![Учёная поднимает пробирку к свету, коллега задумчиво смотрит рядом]()
Что она делает, пока неизвестно. Пионер CRISPR Фэн Чжан назвал находку «по-настоящему интригующей». -
Anthropic запретила издеваться над Claude
![Женщина в очках сердито кричит на ноутбук и стучит кулаком по столу]()
Anthropic запретила «длительное и бессмысленное» жестокое обращение с Claude. ![Женщина спокойно спорит, разводя рукой перед ноутбуком]()
Речь о крайних случаях. Раздражение, споры, мрачные сюжеты и тесты под запрет не попадают. ![Удивлённая женщина смотрит на ноутбук со значком закрытой двери на экране]()
Главная защита прежняя: Claude сам завершает такой диалог. ![Женщина прикрепляет к доске календарь с обведённым днём]()
Правила действуют с 12 ноября. За нарушения доступ могут ограничить или закрыть. -
ИИ-видео с погибшим в суде: срок назначат заново
![Женщина в зале суда показывает планшет с лицом мужчины]()
В Аризоне сестра погибшего показала в суде видео, где ИИ-аватар брата прощает убийцу. ![Растроганный судья с рукой на груди за судейским столом]()
Судья дал максимальные 10,5 года и сказал, что ему «понравилось это видео». ![Три судьи апелляционного суда изучают документы]()
Апелляционный суд счёл приговор несправедливым: видео «не отражает реальных событий». ![Женщина читает своё заявление с листов за трибуной, планшет выключен]()
Срок назначат заново, а свой текст сестра прочитает сама, без видео. -
Журналист выпустил ИИ-песню от имени чужой группы
![Журналист в наушниках с хитрой улыбкой работает за ноутбуком]()
Журналист 404 Media сгенерировал песню в Udio по простому запросу. ![Трое музыкантов панк-группы в шоке смотрят в телефон]()
Трек вышел на подтверждённой странице панк-группы Lathe of Heaven в Spotify без ведома музыкантов. ![Журналист удивлённо разводит руками, вокруг висят значки музыкальных сервисов]()
Песня попала и в Apple Music, Tidal и Amazon Music — через давнюю лазейку в дистрибуции. ![Довольный мошенник ловит монеты, сыплющиеся из наушников, слушательница расстроена]()
Так мошенники зарабатывают на чужой славе. Площадки и дистрибьюторы ответственность не берут. -
Нейросеть научилась играть в «Точки» и обыгрывает автора
![Разработчик держит тетрадь в клетку с партией в точки]()
Разработчик учил нейросеть игре в «Точки» из школьной тетради — по примеру AlphaZero. ![Разработчик ночью смотрит на два монитора с партиями в точки]()
Сеть играла сама с собой: 30 поколений за полтора месяца, однажды девять пришлось выбросить. ![Разработчик радостно подпрыгивает перед монитором с выигранной партией]()
Ученик обыграл учителя, только когда поиск подняли с 800 до 1600 симуляций на ход. ![Разработчик смеётся, проиграв нейросети партию в точки]()
Теперь сложный уровень игры Just Dots стабильно обыгрывает автора на поле 20×20.
























