 FlipИИ чат
Ещё
Нейросети
-
Gemini
Gemini
-
Z.ai
Z.ai
-
ChatGPT
ChatGPT
-
DeepSeek
DeepSeek
-
Claude
Claude
-
Jev
Jev
-
Perplexity
Perplexity
-
OpenAI
OpenAI
-
Kimi
Kimi
-
Qwen
Qwen
-
Grok
Grok
-
Все модели
Все модели
-
Задачи
Задачи





Контекстное окно в 1 миллион токенов: что это даёт на практике

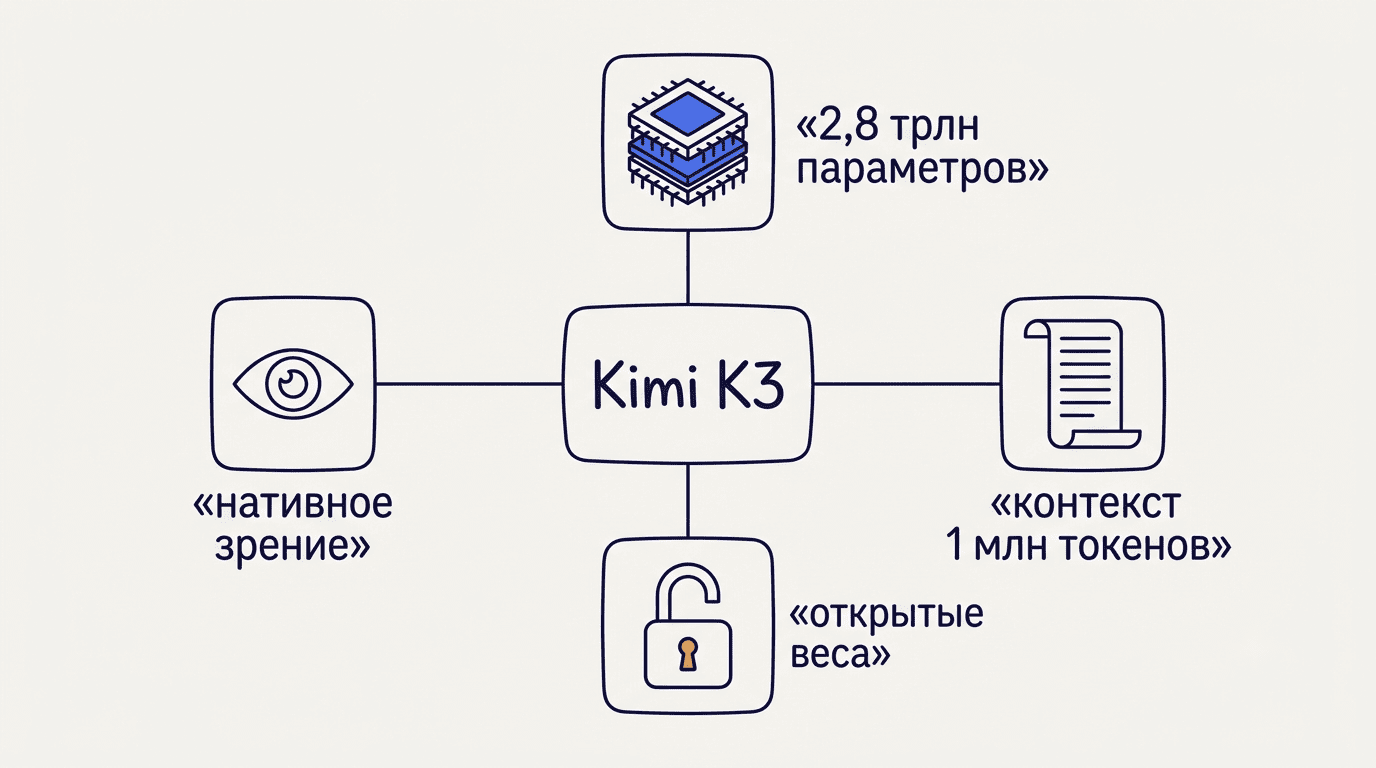
Контекстное окно объёмом 1 миллион токенов — одна из главных характеристик новой флагманской модели Moonshot AI. Согласно официальной документации platform.kimi.ai, это примерно в 4 раза больше, чем у предыдущей версии модели (256 тыс. токенов). Такой объём у Kimi K3 позволяет за один запрос удерживать в памяти целую кодовую базу, десятки документов или книгу среднего размера.
Ниже — точные лимиты по входу и выходу, архитектура, которая делает работу с таким контекстом быстрой, и практические примеры того, что реально помещается в 1 миллион токенов.
Точные лимиты: вход, выход и дефолт
Официальная документация platform.kimi.ai фиксирует контекстное окно флагманской модели Kimi ровно в 1 миллион токенов — весь этот объём доступен для входных данных: промпта, приложенных файлов и истории диалога.
Контекстное окно на входе
Ограничение в 1 000 000 токенов относится именно ко входу — сюда считается всё, что модель получает перед началом генерации ответа. Это не лимит на переписку в целом, а объём одного запроса: чем длиннее диалог или приложенные документы, тем ближе к потолку в 1 миллион токенов подходит запрос.
Лимит вывода — не путать с контекстом
Отдельно задаётся длина ответа: параметр max_completion_tokens можно поднять до 1 048 576 токенов, но по умолчанию модель отвечает в пределах 131 072 токенов. Для большинства задач дефолта достаточно — высокий лимит нужен, когда модель должна сгенерировать очень длинный текст или код целиком за один проход.
Три цифры, которые стоит зафиксировать:
- контекст на входе — 1 000 000 токенов;
- дефолтная длина вывода — 131 072 токена;
- максимальная длина вывода при явной настройке — 1 048 576 токенов.
| Параметр | Значение |
|---|---|
| Контекстное окно (вход) | 1 000 000 токенов |
| Длина вывода по умолчанию | 131 072 токена |
| Максимальная длина вывода | 1 048 576 токенов |
| Тарификация | pay-as-you-go, без надбавки за длину контекста |
Архитектура: почему миллион токенов не тормозит
Сам по себе рост контекста ничего не стоил бы без изменений в механизме внимания — без них декодировка на объёме в миллион токенов была бы слишком медленной для практического использования.
Kimi Delta Attention (KDA). Гибридный механизм линейного внимания — по данным технического разбора MarkTechPost, именно он даёт до 6,3 раза более быструю декодировку в контекстах на миллион токенов по сравнению со стандартным механизмом внимания. Без KDA миллионный контекст был бы практически неюзабелен по скорости.
Attention Residuals и MoE. Attention Residuals (AttnRes) заменяют стандартные остаточные соединения и дают около 25% прироста эффективности обучения. Отдельно архитектура MoE через фреймворк Stable LatentMoE активирует на каждый токен 16 из 896 экспертов — совокупно с KDA и AttnRes это дало прирост эффективности масштабирования примерно в 2,5 раза относительно Kimi K2.
Итог по трём компонентам архитектуры:
- Kimi Delta Attention — до 6,3x ускорение декодировки на контексте 1M;
- Attention Residuals — около 25% прироста эффективности обучения;
- Stable LatentMoE — 16 из 896 экспертов активны на каждый токен;
- совокупный эффект — рост эффективности масштабирования примерно в 2,5 раза к K2.
Модель предоставляет контекстное окно объёмом 1 миллион токенов. Максимальная длина вывода может быть установлена до 1 048 576 токенов, значение по умолчанию — 131 072 токена.Kimi API Platform, официальная документация
Модель также обладает нативным пониманием изображений и видео — эти данные тоже учитываются в общем лимите контекстного окна наравне с текстом. В официальном блоге Moonshot AI уточняется, что режим рассуждений при этом включён по умолчанию — контекст в 1 миллион токенов обрабатывается моделью в режиме мышления, а не в упрощённом «быстром» режиме.
Что реально помещается в 1 миллион токенов
Абстрактная цифра «миллион токенов» становится понятнее на конкретных примерах: это объём, в который помещаются задачи, ранее требовавшие ручного разбиения на части.
Код и разработка
В контекст помещается большая кодовая база целиком — модель может держать в памяти сотни файлов проекта одновременно, не теряя связи между модулями. Это делает работу с моделью удобной для долгосрочных задач программирования и ревью больших репозиториев.
Документы, книги и исследования
Миллион токенов — это десятки документов и отчётов, полная техническая документация продукта или книга среднего объёма. Для исследовательских задач это означает возможность загрузить весь массив материалов по теме в один запрос, а не резать его на части.
Длинные логи и переписки
Тот же объём покрывает длинные логи выполнения, историю переписки или серию встреч — всё это можно анализировать целиком, без потери контекста между фрагментами.
Чтобы быстро прикинуть, поместится ли задача в контекст без дробления на части:
- Оцените объём материала в словах или строках кода.
- Переведите объём в токены — для русского и английского текста ориентир около 1,3-1,5 токена на слово, для кода — примерно 1 токен на 3-4 символа.
- Прибавьте объём системного промпта и истории диалога, если запрос не первый.
- Сравните итоговую сумму с лимитом в 1 000 000 токенов.
- Если сумма близка к потолку — уберите из запроса не относящиеся к задаче файлы или сократите историю переписки.
Ограничения: большой контекст — не идеальная память
Даже при контексте в 1 миллион токенов модель не гарантирует идеальное удержание каждой детали — при работе с очень длинными документами есть риск, что часть информации будет пропущена или интерпретирована неточно. Это не специфика конкретной модели, а общее свойство работы с длинным контекстом у современных LLM: чем дальше от начала или конца запроса расположен фрагмент, тем выше шанс, что модель уделит ему меньше внимания при формировании ответа.
Практический вывод простой: важные факты, извлечённые моделью из большого контекста, стоит перепроверять отдельным запросом или сверкой с первоисточником, а не принимать на веру только потому, что документ был загружен целиком. В первую очередь это касается:
- точных цифр и дат из середины длинного документа;
- условий договоров и юридических формулировок;
- ссылок на конкретные страницы или разделы в объёмных техдокументах.
Контекст 1M против Kimi K2 (256K)
Предыдущее поколение — Kimi K2 — работало с контекстом порядка 256 тысяч токенов. благодаря переходу на открытые веса и новой архитектуре этот показатель вырос примерно в 4 раза, и это расширение стало возможным именно благодаря архитектурным изменениям, а не просто увеличением вычислительных мощностей. Что именно изменилось между поколениями:
- контекстное окно выросло с ~256 000 до 1 000 000 токенов;
- стандартный механизм внимания заменён на Kimi Delta Attention;
- добавлены Attention Residuals для более эффективного обучения;
- совокупная эффективность масштабирования выросла примерно в 2,5 раза.
| Параметр | Kimi K2 | Kimi K3 |
|---|---|---|
| Контекстное окно | ~256 000 токенов | 1 000 000 токенов |
| Механизм внимания | стандартный | Kimi Delta Attention |
| Рост относительно K2 | — | ~4x по контексту |
FAQ
Сколько токенов в контекстном окне Kimi K3?
1 миллион токенов — это официальная цифра из документации platform.kimi.ai, доступная для входных данных запроса.
Какая максимальная длина ответа у Kimi K3?
Максимум можно задать до 1 048 576 токенов, но по умолчанию модель отвечает в пределах 131 072 токенов.
Что можно поместить в контекст 1 миллион токенов?
Большую кодовую базу, десятки документов и отчётов, техническую документацию или книгу среднего размера, длинные логи и переписки.
Чем контекст Kimi K3 отличается от Kimi K2?
Контекст вырос примерно в 4 раза — с порядка 256 тысяч токенов у K2 до 1 миллиона у K3, благодаря архитектуре Kimi Delta Attention.
Что такое Kimi Delta Attention?
Гибридный механизм линейного внимания, который даёт до 6,3 раза более быструю декодировку в контекстах на миллион токенов — именно он делает работу с таким объёмом данных практичной по скорости.
Гарантирует ли большой контекст, что модель не забудет детали?
Нет — даже при 1 миллионе токенов есть риск, что часть деталей в очень длинном документе будет упущена, поэтому важные факты стоит перепроверять.
-
Маршрут от Claude привёл подростка на «Вдоводел»
![Подросток в синей куртке и шлеме радостно смотрит маршрут в телефоне на вершине горы над городом]()
16-летний Брайс из Ванкувера проложил с Claude новый для себя маршрут на гору Краун. ![Подросток с рюкзаком неуверенно пробирается между валунами к крутому гребню]()
Разметки не было: вместо кулуара он попал на гребень «Вдоводел», куда ходят с верёвками. ![Испуганный подросток прижался к отвесной скале на узком уступе и звонит по телефону]()
Брайс застрял на уступе шириной около полутора метров: сзади обрыв, впереди почти отвесная стена. ![Спасатель спускается по верёвке к подростку на уступе, рядом вертолёт]()
Вертолёт не мог подойти к скале: спасатель спустился к Брайсу по верёвке, и его подняли на борт. ![Подросток в спасательном одеяле сидит у тропы с бумажной картой, рядом компас]()
Брайс винит себя, но тропы через ИИ больше не прокладывает. Спасатель: «Claude никогда не был в этих местах». -
950 агентов Claude нашли в ДНК вирусов загадочную систему
![Учёная в лаборатории смотрит на монитор со спиралями ДНК]()
Anthropic поручила Claude найти в огромной базе ДНК необычные ферменты. ![Учёная с планшетом смотрит на стену из сотен мониторов с ДНК]()
Около 950 агентов за 21 час собрали больше 200 тысяч ферментов и написали 20 отчётов. ![Учёная взволнованно показывает на повторяющийся узор в цепочке ДНК на экране]()
Один агент «на глаз» заметил рядом с ферментом повторы, как у CRISPR. Систему назвали ART. ![Учёная поднимает пробирку к свету, коллега задумчиво смотрит рядом]()
Что она делает, пока неизвестно. Пионер CRISPR Фэн Чжан назвал находку «по-настоящему интригующей». -
Anthropic запретила издеваться над Claude
![Женщина в очках сердито кричит на ноутбук и стучит кулаком по столу]()
Anthropic запретила «длительное и бессмысленное» жестокое обращение с Claude. ![Женщина спокойно спорит, разводя рукой перед ноутбуком]()
Речь о крайних случаях. Раздражение, споры, мрачные сюжеты и тесты под запрет не попадают. ![Удивлённая женщина смотрит на ноутбук со значком закрытой двери на экране]()
Главная защита прежняя: Claude сам завершает такой диалог. ![Женщина прикрепляет к доске календарь с обведённым днём]()
Правила действуют с 12 ноября. За нарушения доступ могут ограничить или закрыть. -
ИИ-видео с погибшим в суде: срок назначат заново
![Женщина в зале суда показывает планшет с лицом мужчины]()
В Аризоне сестра погибшего показала в суде видео, где ИИ-аватар брата прощает убийцу. ![Растроганный судья с рукой на груди за судейским столом]()
Судья дал максимальные 10,5 года и сказал, что ему «понравилось это видео». ![Три судьи апелляционного суда изучают документы]()
Апелляционный суд счёл приговор несправедливым: видео «не отражает реальных событий». ![Женщина читает своё заявление с листов за трибуной, планшет выключен]()
Срок назначат заново, а свой текст сестра прочитает сама, без видео. -
Журналист выпустил ИИ-песню от имени чужой группы
![Журналист в наушниках с хитрой улыбкой работает за ноутбуком]()
Журналист 404 Media сгенерировал песню в Udio по простому запросу. ![Трое музыкантов панк-группы в шоке смотрят в телефон]()
Трек вышел на подтверждённой странице панк-группы Lathe of Heaven в Spotify без ведома музыкантов. ![Журналист удивлённо разводит руками, вокруг висят значки музыкальных сервисов]()
Песня попала и в Apple Music, Tidal и Amazon Music — через давнюю лазейку в дистрибуции. ![Довольный мошенник ловит монеты, сыплющиеся из наушников, слушательница расстроена]()
Так мошенники зарабатывают на чужой славе. Площадки и дистрибьюторы ответственность не берут. -
Нейросеть научилась играть в «Точки» и обыгрывает автора
![Разработчик держит тетрадь в клетку с партией в точки]()
Разработчик учил нейросеть игре в «Точки» из школьной тетради — по примеру AlphaZero. ![Разработчик ночью смотрит на два монитора с партиями в точки]()
Сеть играла сама с собой: 30 поколений за полтора месяца, однажды девять пришлось выбросить. ![Разработчик радостно подпрыгивает перед монитором с выигранной партией]()
Ученик обыграл учителя, только когда поиск подняли с 800 до 1600 симуляций на ход. ![Разработчик смеётся, проиграв нейросети партию в точки]()
Теперь сложный уровень игры Just Dots стабильно обыгрывает автора на поле 20×20.
























