 FlipИИ чат
Ещё
Нейросети
-
Gemini
Gemini
-
Z.ai
Z.ai
-
ChatGPT
ChatGPT
-
DeepSeek
DeepSeek
-
Claude
Claude
-
Jev
Jev
-
Perplexity
Perplexity
-
OpenAI
OpenAI
-
Kimi
Kimi
-
Qwen
Qwen
-
Grok
Grok
-
Все модели
Все модели
-
Задачи
Задачи





Kimi K3: разбор флагманской модели Moonshot AI — 2,8 триллиона параметров, контекст 1M и открытые веса

16 июля 2026 года китайская компания Moonshot AI представила флагманскую модель Kimi K3 — крупнейшую открытую языковую модель из когда-либо выпущенных публично.
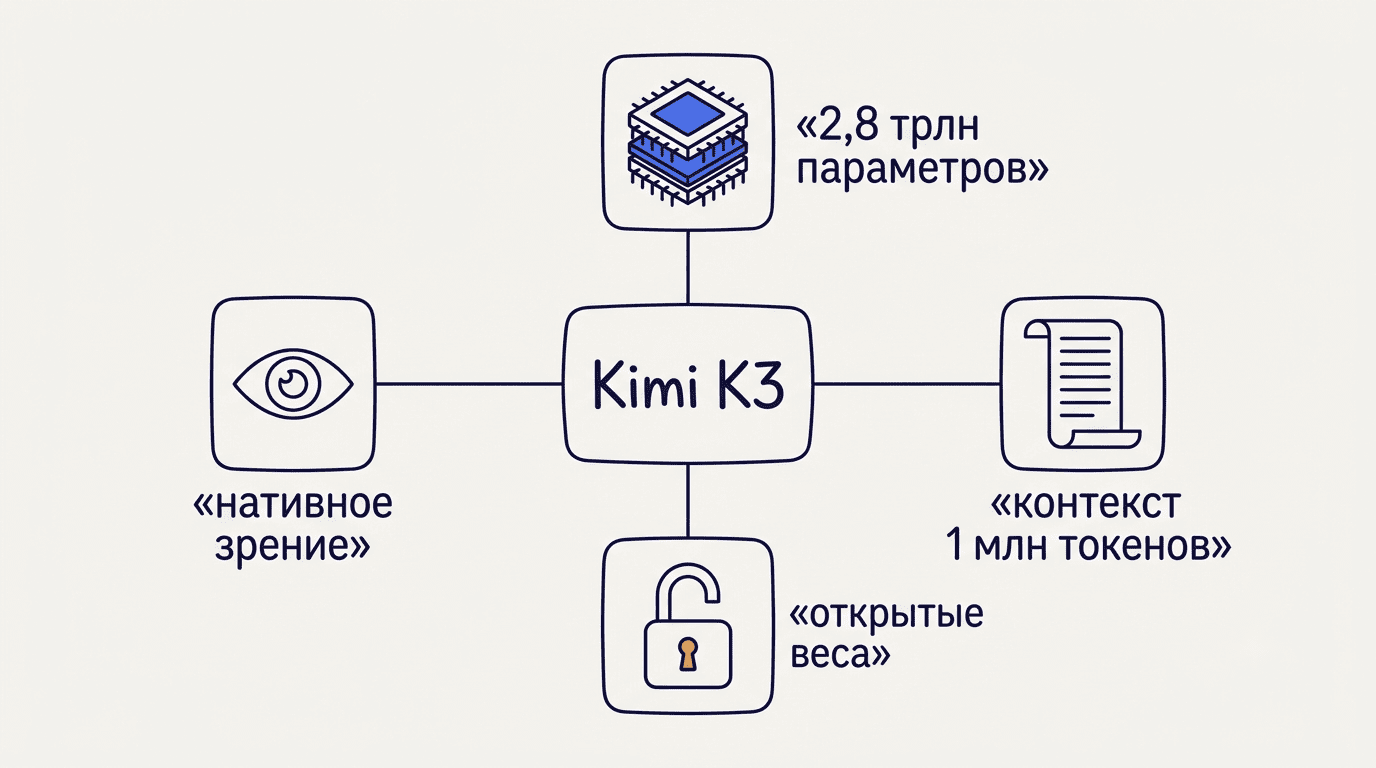
Kimi K3 (её также ищут как «Kimi 3») — это MoE-модель на 2,8 триллиона параметров с контекстом 1 миллион токенов, нативным зрением и открытыми весами. Подробности архитектуры и бенчмарков компания опубликовала в техноблоге Kimi K3. В независимых рейтингах модель заняла место сразу за Claude Fable 5 и GPT-5.6 Sol, заметно обойдя Claude Opus 4.8.
Что такое Kimi K3 и почему это важно
Kimi K3 — это официальное название модели, которую многие ищут как «Kimi 3». Путаницы здесь нет: речь об одной и той же флагманской системе Moonshot AI, анонсированной 16 июля 2026 года. Открытая модель Kimi K3 сразу заняла место среди систем мирового уровня, что для открытых весов раньше было редкостью.
Релиз уже называют «вторым DeepSeek-шоком». Так его окрестили после того, как китайская модель Kimi K3 от Moonshot AI приблизилась по качеству к топовым закрытым системам США, оставаясь при этом открытой. Реакция рынков оказалась резкой:
- акции TSMC — минус 7%;
- SoftBank — минус 9%;
- Nvidia — минус 1,2%;
- бумаги z.ai в Гонконге — минус 30%.
Moonshot AI основана в 2023 году под руководством Yang Zhilin и за три года превратилась в одну из главных китайских лабораторий ИИ наравне с DeepSeek и z.ai (создателем GLM-5.2).
Архитектура: 2,8 триллиона параметров и MoE
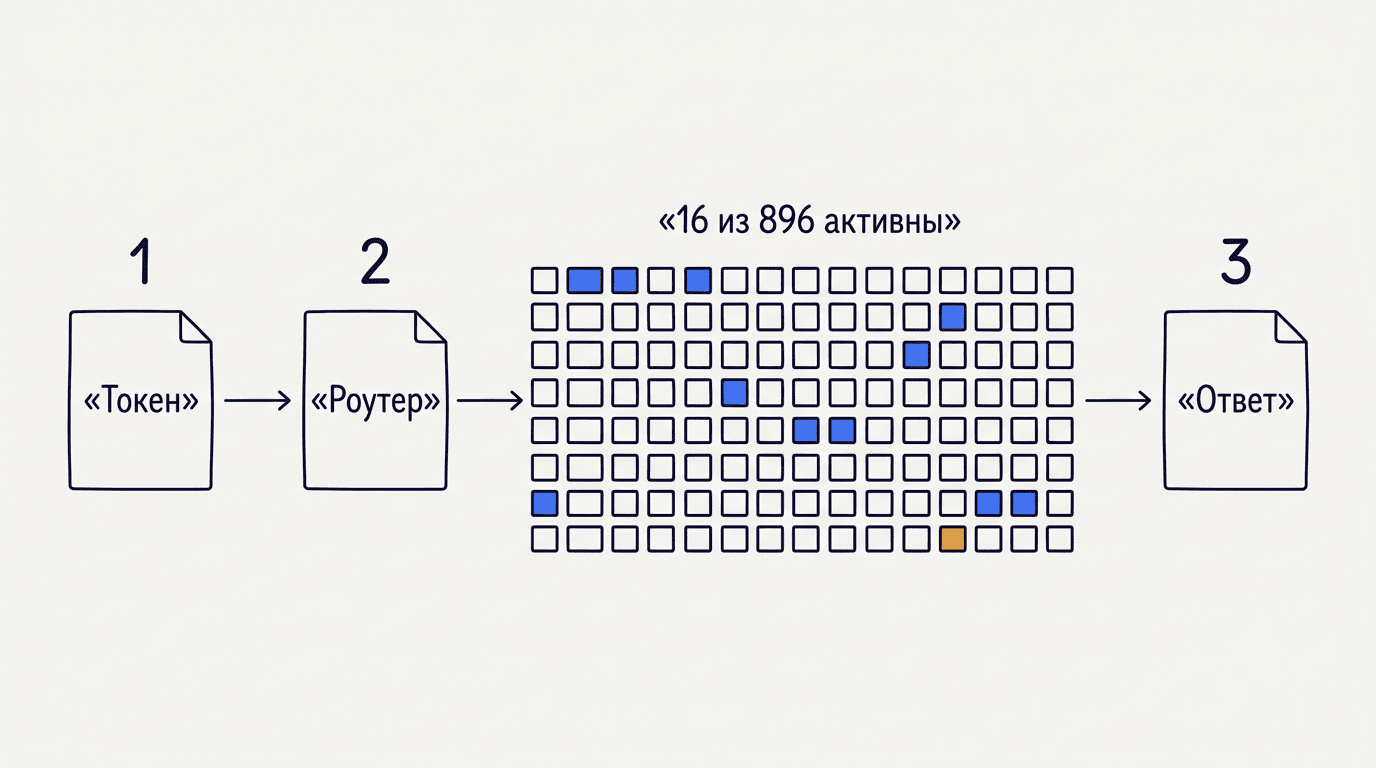
За компактную работу флагмана Kimi K3 отвечает разреженная архитектура Stable LatentMoE — она позволяет держать огромный суммарный объём параметров, но активировать на каждый токен лишь малую их часть. Сам принцип Mixture-of-Experts не нов, но именно в Kimi K3 его довели до масштаба, ранее недоступного открытым моделям.
2,8T параметров, но активны единицы процентов
Из 896 экспертов Stable LatentMoE на каждый токен включаются только 16 — это около 1,8% от общего числа, или порядка 50 миллиардов активных параметров. Формально Kimi K3 — первая открытая модель класса 3 триллионов параметров, доведённая до продакшена, а не оставшаяся исследовательским прототипом.
Что улучшилось по сравнению с Kimi K2
Moonshot AI заявляет примерно 2,5-кратный прирост масштабируемости обучения относительно предыдущего поколения Kimi K2. Из технических изменений, обеспечивших этот скачок, выделяются три:
- Quantile Balancing — убирает часть ручных эвристик балансировки нагрузки между экспертами;
- Per-Head Muon — покомпонентная оптимизация внимания на уровне отдельных голов;
- квантование MXFP4/MXFP8 — снижает вычислительные затраты при инференсе без ощутимой потери качества.
Kimi Delta Attention (KDA) и Attention Residuals
Главное архитектурное новшество Kimi K3 — механизм внимания, спроектированный специально под работу с очень длинным контекстом.
Что такое Kimi Delta Attention
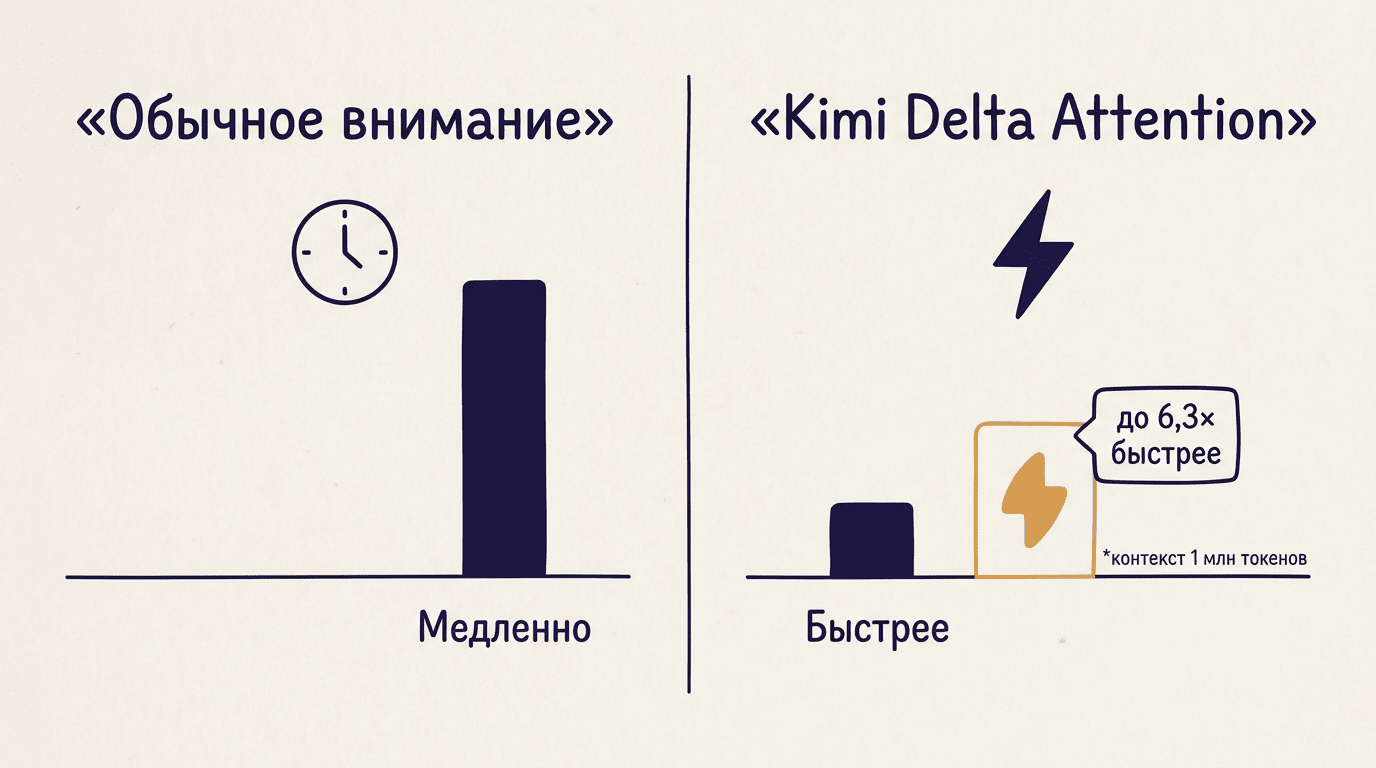
Kimi Delta Attention (KDA) — это гибридное линейное внимание, которое даёт до 6,3 раза более быстрое декодирование при работе с контекстом на миллион токенов. Простыми словами: обычное внимание трансформеров пересчитывает связи между всеми токенами заново, и чем длиннее текст, тем дороже становится каждый следующий шаг генерации. KDA частично заменяет этот пересчёт линейным механизмом, поэтому стоимость генерации на длинном контексте растёт медленнее.
Attention Residuals простыми словами
Attention Residuals (AttnRes) избирательно достаёт нужные представления по глубине сети, а не копит их равномерно на каждом слое, как это делают классические residual-связи. По данным Moonshot AI, это даёт примерно на 25% более высокую эффективность обучения при дополнительных затратах меньше 2%.
Контекст 1M токенов и нативное зрение
Второй столп Kimi K3 — по-настоящему длинный контекст в сочетании с мультимодальностью «из коробки». Максимальная длина контекстного окна — 1 миллион токенов, а стандартный лимит на генерацию по умолчанию составляет 131 072 токена, но его можно расширить до тех же 1 048 576. На практике в 1M токенов помещается:
- объёмная кодовая база из нескольких десятков файлов;
- несколько книг среднего размера целиком;
- многочасовая переписка или лог агентной сессии без потери связности между началом и концом;
- видеоряд вместе с сопроводительным текстом благодаря нативному зрению.
Модель понимает текст, изображения и видео без отдельных адаптеров, а режим рассуждений (thinking mode) в Kimi K3 включён по умолчанию — модель «думает» перед ответом на каждый запрос, а не только по специальной команде.
Бенчмарки и место в рейтинге
Ключевой вопрос для любой новой модели — как она соотносится с конкурентами. По данным независимых замеров, Kimi K3 занимает третье место в общем рейтинге, уступая только Claude Fable 5 и GPT-5.6 Sol, но существенно опережая Claude Opus 4.8.
Где Kimi K3 в рейтинге
Такое место в топ-3 — редкость для открытой модели: обычно open-weight системы отстают от закрытых флагманов на поколение. Kimi K3 сокращает этот разрыв почти до нуля, оставаясь при этом моделью со свободно скачиваемыми весами.
Конкретные баллы
| Бенчмарк | Kimi K3 | Что измеряет |
|---|---|---|
| GPQA-Diamond | 93,5 | экспертные научные вопросы |
| BrowseComp | 91,2 | поиск и работа с вебом |
| OmniDocBench | 91,1 | понимание документов |
| Program Bench | 77,8 | программирование |
Независимую агрегацию таких результатов ведёт Artificial Analysis — по их методике Kimi K3 закрепилась в тройке лидеров среди всех протестированных систем, включая закрытые. Отдельная деталь по методологии: результат 91,2 на BrowseComp получен с компакцией контекста, срабатывающей на отметке 300К токенов — без неё, на полном окне 1M, показатель модели составляет 90,4.
Open-weight: лицензия и дата весов
Kimi K3 — не просто доступная через API модель, а open-weight релиз: веса можно скачать, развернуть на собственной инфраструктуре и дообучить под свою задачу. Технически это стало возможным благодаря разреженной MoE-архитектуре (см. раздел выше), которую Moonshot AI оптимизировала для распределённого инференса, что снижает порог входа для локального хостинга по сравнению с плотными моделями сопоставимого размера.
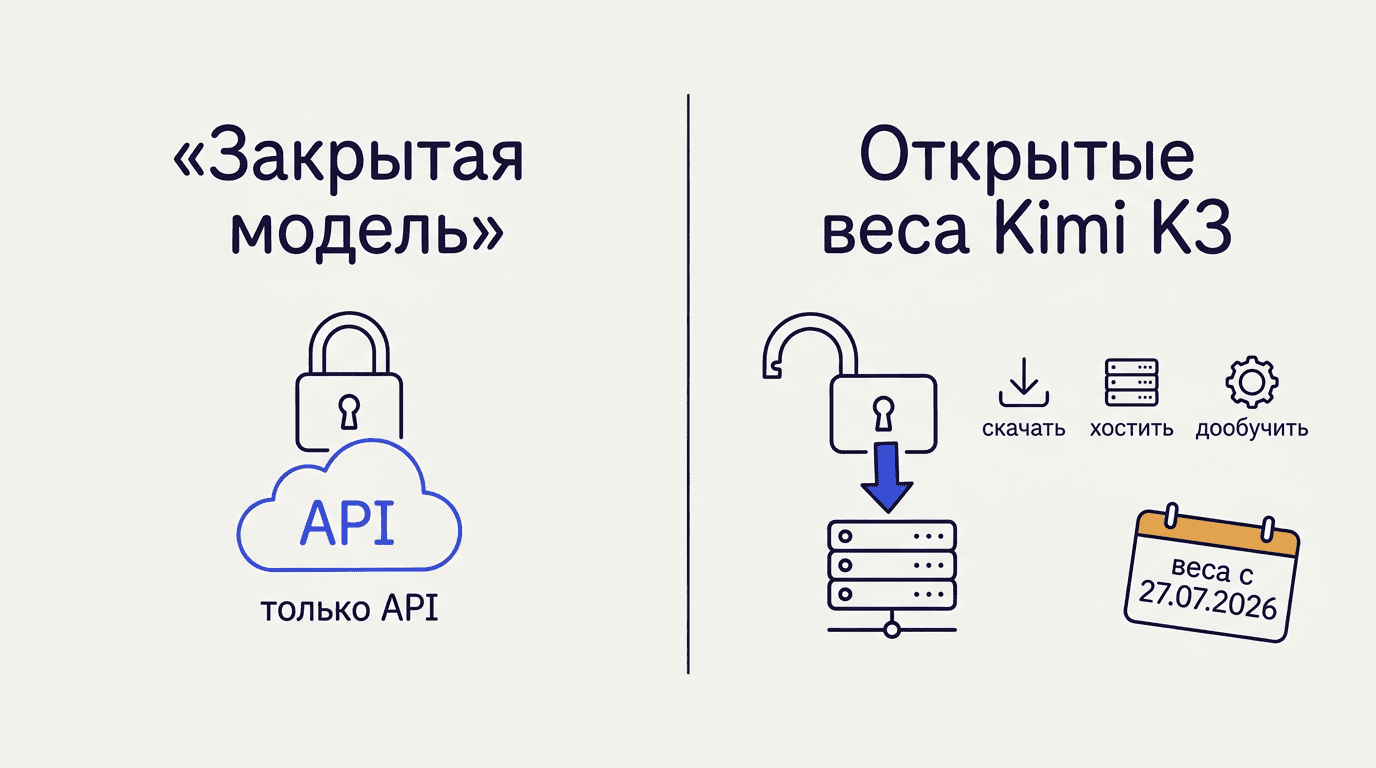
Полные веса Kimi K3 станут доступны для скачивания 27 июля 2026 года — на момент анонса доступ к модели открыт через веб-сервисы Moonshot AI и API. Сама компания описывает релиз так:
Kimi K3 — это открытый фронтир интеллекта: модель с 2,8 триллионами параметров, которую можно изучать, размещать на собственных серверах и дообучать самостоятельно.Техноблог Kimi K3, Moonshot AI
Это продолжает линию, начатую предыдущим поколением Kimi K2: Moonshot AI системно делает ставку на открытые веса вместо закрытой модели распространения, которую использует, например, Anthropic для линейки Claude.
Цена API и как попробовать
Разрыв в качестве между Kimi K3 и топовыми закрытыми моделями почти закрыт, а вот в цене разрыв остаётся огромным — и не в пользу американских конкурентов.
Сколько стоит
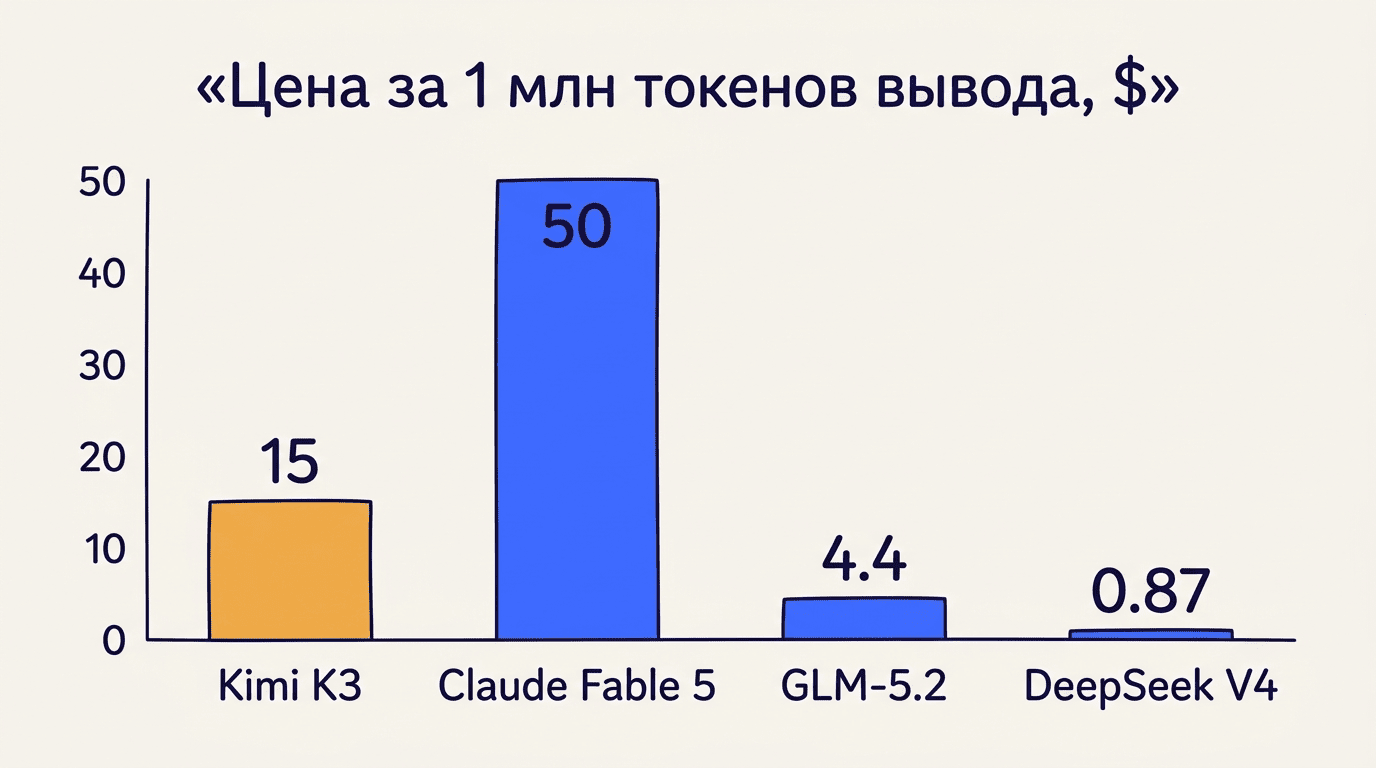
По документации Kimi API Platform, цена за миллион токенов входа составляет $3 при промахе кэша и $0,30 при попадании в кэш, а выход стоит $15 за миллион токенов. Для сравнения с ближайшими конкурентами по рейтингу:
| Модель | Цена выхода за 1M токенов |
|---|---|
| Kimi K3 | $15 |
| Claude Fable 5 | $50 |
| GLM-5.2 | $4,40 |
| DeepSeek V4 | $0,87 |
Даже без учёта скидки на кэш Kimi K3 более чем втрое дешевле Claude Fable 5 при сопоставимом месте в рейтинге качества.
Где попробовать
Опробовать модель можно несколькими способами:
- зайти на Kimi.com и выбрать модель Kimi K3 в чате;
- открыть Kimi Work — рабочее пространство для документов и агентных задач;
- запустить Kimi Code для программирования с длинным контекстом;
- получить ключ на Kimi API Platform и обратиться к модели по идентификатору
kimi-k3; - дождаться 27 июля 2026 года и развернуть открытые веса локально.
FAQ
Ключевые узлы Kimi K3 разбираем отдельно: механизм внимания KDA, контекстное окно 1M токенов, разреженную MoE-архитектуру, открытые веса и цену API за токены.
Что такое Kimi K3?
Флагманская open-weight MoE-модель Moonshot AI на 2,8 триллиона параметров, анонсированная 16 июля 2026 года. Её также ищут как «Kimi 3».
Kimi K3 — это open-source?
Это open-weight: веса открыты для скачивания, локального хостинга и дообучения, но полный релиз весов состоится 27 июля 2026 года.
Сколько параметров у Kimi K3?
2,8 триллиона параметров всего, из которых на каждый токен активны 16 из 896 экспертов — около 50 миллиардов активных параметров.
Что такое Kimi Delta Attention?
Гибридное линейное внимание, ускоряющее декодирование до 6,3 раза при контексте в 1 миллион токенов.
Чем Kimi K3 отличается от Kimi K2?
Примерно на 2,5 раза лучшей масштабируемостью обучения, новыми механизмами KDA, Attention Residuals и Quantile Balancing, а также контекстом 1M токенов и нативным зрением.
Сколько стоит Kimi K3 в API?
Вход $3 за 1M токенов (или $0,30 с попаданием в кэш), выход $15 за 1M токенов — заметно дешевле топовых моделей США вроде Claude Fable 5.
-
Маршрут от Claude привёл подростка на «Вдоводел»
![Подросток в синей куртке и шлеме радостно смотрит маршрут в телефоне на вершине горы над городом]()
16-летний Брайс из Ванкувера проложил с Claude новый для себя маршрут на гору Краун. ![Подросток с рюкзаком неуверенно пробирается между валунами к крутому гребню]()
Разметки не было: вместо кулуара он попал на гребень «Вдоводел», куда ходят с верёвками. ![Испуганный подросток прижался к отвесной скале на узком уступе и звонит по телефону]()
Брайс застрял на уступе шириной около полутора метров: сзади обрыв, впереди почти отвесная стена. ![Спасатель спускается по верёвке к подростку на уступе, рядом вертолёт]()
Вертолёт не мог подойти к скале: спасатель спустился к Брайсу по верёвке, и его подняли на борт. ![Подросток в спасательном одеяле сидит у тропы с бумажной картой, рядом компас]()
Брайс винит себя, но тропы через ИИ больше не прокладывает. Спасатель: «Claude никогда не был в этих местах». -
950 агентов Claude нашли в ДНК вирусов загадочную систему
![Учёная в лаборатории смотрит на монитор со спиралями ДНК]()
Anthropic поручила Claude найти в огромной базе ДНК необычные ферменты. ![Учёная с планшетом смотрит на стену из сотен мониторов с ДНК]()
Около 950 агентов за 21 час собрали больше 200 тысяч ферментов и написали 20 отчётов. ![Учёная взволнованно показывает на повторяющийся узор в цепочке ДНК на экране]()
Один агент «на глаз» заметил рядом с ферментом повторы, как у CRISPR. Систему назвали ART. ![Учёная поднимает пробирку к свету, коллега задумчиво смотрит рядом]()
Что она делает, пока неизвестно. Пионер CRISPR Фэн Чжан назвал находку «по-настоящему интригующей». -
Anthropic запретила издеваться над Claude
![Женщина в очках сердито кричит на ноутбук и стучит кулаком по столу]()
Anthropic запретила «длительное и бессмысленное» жестокое обращение с Claude. ![Женщина спокойно спорит, разводя рукой перед ноутбуком]()
Речь о крайних случаях. Раздражение, споры, мрачные сюжеты и тесты под запрет не попадают. ![Удивлённая женщина смотрит на ноутбук со значком закрытой двери на экране]()
Главная защита прежняя: Claude сам завершает такой диалог. ![Женщина прикрепляет к доске календарь с обведённым днём]()
Правила действуют с 12 ноября. За нарушения доступ могут ограничить или закрыть. -
ИИ-видео с погибшим в суде: срок назначат заново
![Женщина в зале суда показывает планшет с лицом мужчины]()
В Аризоне сестра погибшего показала в суде видео, где ИИ-аватар брата прощает убийцу. ![Растроганный судья с рукой на груди за судейским столом]()
Судья дал максимальные 10,5 года и сказал, что ему «понравилось это видео». ![Три судьи апелляционного суда изучают документы]()
Апелляционный суд счёл приговор несправедливым: видео «не отражает реальных событий». ![Женщина читает своё заявление с листов за трибуной, планшет выключен]()
Срок назначат заново, а свой текст сестра прочитает сама, без видео. -
Журналист выпустил ИИ-песню от имени чужой группы
![Журналист в наушниках с хитрой улыбкой работает за ноутбуком]()
Журналист 404 Media сгенерировал песню в Udio по простому запросу. ![Трое музыкантов панк-группы в шоке смотрят в телефон]()
Трек вышел на подтверждённой странице панк-группы Lathe of Heaven в Spotify без ведома музыкантов. ![Журналист удивлённо разводит руками, вокруг висят значки музыкальных сервисов]()
Песня попала и в Apple Music, Tidal и Amazon Music — через давнюю лазейку в дистрибуции. ![Довольный мошенник ловит монеты, сыплющиеся из наушников, слушательница расстроена]()
Так мошенники зарабатывают на чужой славе. Площадки и дистрибьюторы ответственность не берут. -
Нейросеть научилась играть в «Точки» и обыгрывает автора
![Разработчик держит тетрадь в клетку с партией в точки]()
Разработчик учил нейросеть игре в «Точки» из школьной тетради — по примеру AlphaZero. ![Разработчик ночью смотрит на два монитора с партиями в точки]()
Сеть играла сама с собой: 30 поколений за полтора месяца, однажды девять пришлось выбросить. ![Разработчик радостно подпрыгивает перед монитором с выигранной партией]()
Ученик обыграл учителя, только когда поиск подняли с 800 до 1600 симуляций на ход. ![Разработчик смеётся, проиграв нейросети партию в точки]()
Теперь сложный уровень игры Just Dots стабильно обыгрывает автора на поле 20×20.
























