 FlipИИ чат
Ещё
Нейросети
-
Gemini
Gemini
-
Z.ai
Z.ai
-
ChatGPT
ChatGPT
-
DeepSeek
DeepSeek
-
Claude
Claude
-
Jev
Jev
-
Perplexity
Perplexity
-
OpenAI
OpenAI
-
Kimi
Kimi
-
Qwen
Qwen
-
Grok
Grok
-
Все модели
Все модели
-
Задачи
Задачи





Цена API языковой модели за токены: как считается стоимость входа, выхода и кэша

Разработчики платят за API языковых моделей не за подписку, а за токены — единицы текста на входе и выходе запроса. В экосистеме Kimi K3 цена строится по той же логике: вход дешевле выхода, а повторное использование контекста через кэш снижает счёт в разы. Официальную схему тарификации провайдер публикует в документации на platform.kimi.ai.
Ниже — формула расчёта, разница между входными и выходными токенами, механика кэширования и сравнение тарифов на конкретных цифрах.
Как считается цена токена в API
Итоговая цена запроса складывается из двух отдельных ставок: (число входных токенов × цена за вход) + (число выходных токенов × цена за выход). Провайдеры публикуют цену за 1 миллион токенов (1M) отдельно для входа и выхода — это два разных тарифа, а не единая ставка за весь запрос.
Генерация каждого выходного токена требует полного прохода модели вперёд, тогда как входные токены модель обрабатывает параллельно за один проход. Поэтому у большинства провайдеров выход стоит в 2-5 раз дороже входа: разброс от Gemini Flash-Lite (около 4x) до Claude Opus (5x).
Из чего складывается итоговая стоимость вызова API:
- количество входных токенов промпта — системная инструкция, история диалога, документы;
- количество выходных токенов — видимый ответ модели и служебные токены рассуждений;
- статус кэша — cache-hit или cache-miss для повторяющейся части запроса;
- размер контекстного окна модели, который ограничивает максимальный объём одного вызова.
Как считаются токены входа и выхода
Токенизация — это разбиение текста на фрагменты через алгоритм BPE-токенизации (byte pair encoding), по которым и считается тариф. Русский текст занимает в 1,5-2 раза больше токенов, чем английский эквивалент того же смысла, поэтому один и тот же запрос на русском обойдётся дороже.
Что попадает во входные токены
Во входные токены засчитывается весь промпт: системная инструкция, история диалога, вложенные документы и текущий вопрос пользователя. Чем длиннее история чата, тем больше входных токенов на каждый следующий запрос — если её не обрезать или не кэшировать.
В расчёт входных токенов провайдер включает:
- системный промпт и инструкции агента;
- предыдущие сообщения диалога;
- прикреплённые файлы и документы;
- текущее сообщение пользователя.
Что попадает в выходные токены
Выходные токены — это сгенерированный моделью ответ, включая служебные токены рассуждений (reasoning tokens) у «думающих» моделей. У моделей с расширенным reasoning счёт за выход может вырасти даже при коротком видимом ответе — рассуждения тоже тарифицируются наравне с финальным текстом.
Кэш и cache-hit rate: как снизить цену входа
Кэш промпта — это повторное использование уже обработанной части запроса (системный промпт, длинная история, документ) вместо полного пересчёта на каждый вызов. Провайдер хранит промежуточное состояние модели для повторяющегося префикса запроса, поэтому второй и последующие вызовы с тем же началом обходятся дешевле.
При попадании в кэш (cache-hit) цена входных токенов падает в разы — иногда до 90%+ от базовой ставки cache-miss. У моделей с частыми повторными вызовами (агенты, чат-боты с системным промптом) высокий cache-hit rate становится главным рычагом экономии, часто важнее выбора самой дешёвой модели на бумаге.
Cache-hit rate растёт быстрее всего в сценариях с повторяющимся началом запроса:
- у чат-ботов с фиксированным системным промптом на каждый вызов;
- у агентов, которые многократно обращаются к одному и тому же документу или базе знаний;
- у RAG-пайплайнов с постоянным префиксом инструкций перед вставкой контекста.
Позиционирование модели и подход к тарификации Moonshot AI описывает в техническом блоге kimi.com: дешёвый повторный проход по контексту рассчитан на агентные сценарии с длинной историей, где один и тот же префикс запроса обрабатывается десятки раз.
Разница между тарифами cache-hit и cache-miss хорошо видна на графике сравнения цен вывода между провайдерами.
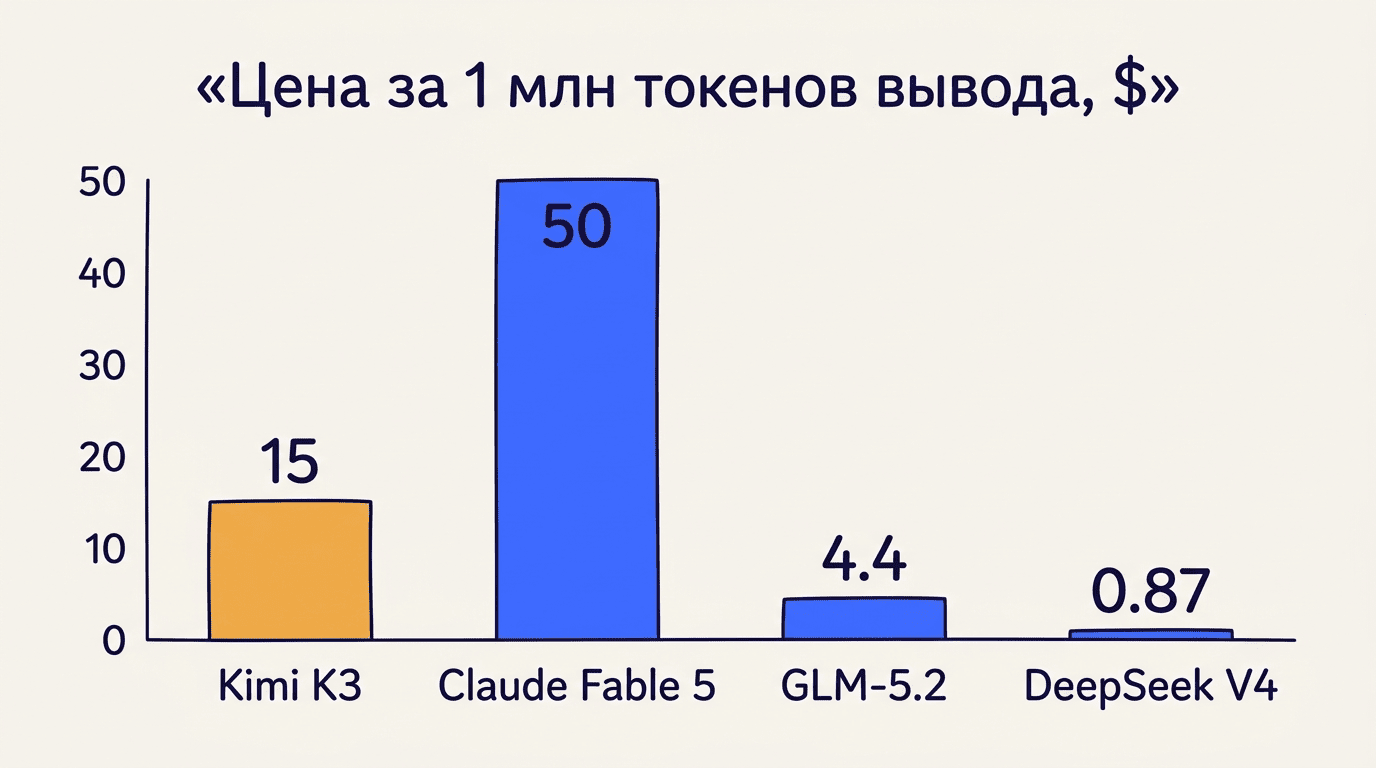
Именно такое соотношение цен вывода задаёт масштаб экономии, о которой пойдёт речь в разделе с тарифами конкретной модели.
Тарифы актуальной модели Moonshot AI на platform.kimi.ai
Вход и кэш. Официальный прайс модели kimi-k3 на platform.kimi.ai — $3 за 1M токенов при cache-miss и $0,30 за 1M при cache-hit, то есть снижение в 10 раз. Такой разрыв рассчитан на длинный системный контекст — здесь помогает архитектура Kimi Delta Attention, снижающая стоимость обработки длинного контекста 1M токенов.
Выход. Цена генерации — $15 за 1M токенов. Соотношение вход/выход здесь примерно 1:5 при cache-miss, что типично для линейки топовых моделей.
| Параметр | Цена |
|---|---|
| Вход, cache-miss | $3 за 1M токенов |
| Вход, cache-hit | $0,30 за 1M токенов |
| Выход | $15 за 1M токенов |
Прежде чем сравнивать цену выхода с конкурентами, стоит зафиксировать, что учитывает сам тариф:
- ставка привязана к конкретной модели и может отличаться у разных версий одной линейки;
- разработчик платит по факту использования, без минимального месячного платежа;
- при превышении контекстного окна модель либо обрежет историю, либо запрос завершится ошибкой.
Сравнение цены выхода с конкурентами
$15 за 1M выходных токенов — заметно дешевле топовых моделей уровня Claude, но дороже узкоспециализированных бюджетных вариантов. Полная картина по цене выхода — в таблице ниже.
| Модель | Цена выхода, $/1M токенов |
|---|---|
| Claude Fable 5 | $50,00 |
| Модель Moonshot AI | $15,00 |
| GLM-5.2 | $4,40 |
| DeepSeek V4 | $0,87 |
Итог: модель занимает среднюю ценовую позицию — дороже узкоспециализированных дешёвых конкурентов, но существенно дешевле топ-флагманов уровня Claude. Многие из этих моделей — Claude, DeepSeek, GLM — можно предварительно сравнить в интерфейсе нейросетей онлайн, не подключая платный API.
Пример расчёта стоимости запроса
Формулу проще всего проверить на конкретных цифрах — сначала без кэша, затем с ним.
Как посчитать стоимость своего запроса к API:
- Определите число входных токенов запроса (промпт + история + документы).
- Определите ожидаемое число выходных токенов ответа.
- Проверьте статус контекста — cache-hit или cache-miss.
- Умножьте входные токены на ставку входа для нужного статуса кэша.
- Умножьте выходные токены на ставку выхода.
- Сложите обе суммы — это цена одного вызова API.
Запрос без кэша
Запрос на 100 000 входных токенов (cache-miss) и 2 000 выходных токенов: вход — 100 000 × $3 / 1 000 000 = $0,30; выход — 2 000 × $15 / 1 000 000 = $0,03. Итого около $0,33 за один вызов.
Тот же запрос с cache-hit
Если тот же 100-тысячный контекст уже в кэше (cache-hit), вход обойдётся в 100 000 × $0,30 / 1 000 000 = $0,03 — экономия примерно в 10 раз на входной части запроса при неизменной стоимости выхода.
FAQ
Как считается цена токена в API?
Итоговая цена = (входные токены × ставка за вход) + (выходные токены × ставка за выход); ставки указываются провайдером за 1 миллион токенов отдельно для входа и выхода.
Что такое входные и выходные токены?
Входные токены — это весь промпт (инструкция, история, документы, вопрос), выходные — сгенерированный моделью ответ вместе со служебными токенами рассуждений.
Почему выходные токены дороже входных?
Генерация каждого токена ответа требует отдельного прохода модели, тогда как входные токены обрабатываются параллельно — поэтому выход обычно в 2-5 раз дороже входа.
Что такое кэширование промпта и cache-hit rate?
Кэш промпта — это повторное использование уже обработанного контекста без полного пересчёта; высокий cache-hit rate снижает цену входа до 90%+ и особенно выгоден агентам с длинным системным промптом.
Сколько стоит API последней модели Moonshot AI?
Вход — $3 за 1M токенов (cache-miss) или $0,30 за 1M (cache-hit), выход — $15 за 1M токенов; подробности — в документации на platform.kimi.ai.
-
Маршрут от Claude привёл подростка на «Вдоводел»
![Подросток в синей куртке и шлеме радостно смотрит маршрут в телефоне на вершине горы над городом]()
16-летний Брайс из Ванкувера проложил с Claude новый для себя маршрут на гору Краун. ![Подросток с рюкзаком неуверенно пробирается между валунами к крутому гребню]()
Разметки не было: вместо кулуара он попал на гребень «Вдоводел», куда ходят с верёвками. ![Испуганный подросток прижался к отвесной скале на узком уступе и звонит по телефону]()
Брайс застрял на уступе шириной около полутора метров: сзади обрыв, впереди почти отвесная стена. ![Спасатель спускается по верёвке к подростку на уступе, рядом вертолёт]()
Вертолёт не мог подойти к скале: спасатель спустился к Брайсу по верёвке, и его подняли на борт. ![Подросток в спасательном одеяле сидит у тропы с бумажной картой, рядом компас]()
Брайс винит себя, но тропы через ИИ больше не прокладывает. Спасатель: «Claude никогда не был в этих местах». -
950 агентов Claude нашли в ДНК вирусов загадочную систему
![Учёная в лаборатории смотрит на монитор со спиралями ДНК]()
Anthropic поручила Claude найти в огромной базе ДНК необычные ферменты. ![Учёная с планшетом смотрит на стену из сотен мониторов с ДНК]()
Около 950 агентов за 21 час собрали больше 200 тысяч ферментов и написали 20 отчётов. ![Учёная взволнованно показывает на повторяющийся узор в цепочке ДНК на экране]()
Один агент «на глаз» заметил рядом с ферментом повторы, как у CRISPR. Систему назвали ART. ![Учёная поднимает пробирку к свету, коллега задумчиво смотрит рядом]()
Что она делает, пока неизвестно. Пионер CRISPR Фэн Чжан назвал находку «по-настоящему интригующей». -
Anthropic запретила издеваться над Claude
![Женщина в очках сердито кричит на ноутбук и стучит кулаком по столу]()
Anthropic запретила «длительное и бессмысленное» жестокое обращение с Claude. ![Женщина спокойно спорит, разводя рукой перед ноутбуком]()
Речь о крайних случаях. Раздражение, споры, мрачные сюжеты и тесты под запрет не попадают. ![Удивлённая женщина смотрит на ноутбук со значком закрытой двери на экране]()
Главная защита прежняя: Claude сам завершает такой диалог. ![Женщина прикрепляет к доске календарь с обведённым днём]()
Правила действуют с 12 ноября. За нарушения доступ могут ограничить или закрыть. -
ИИ-видео с погибшим в суде: срок назначат заново
![Женщина в зале суда показывает планшет с лицом мужчины]()
В Аризоне сестра погибшего показала в суде видео, где ИИ-аватар брата прощает убийцу. ![Растроганный судья с рукой на груди за судейским столом]()
Судья дал максимальные 10,5 года и сказал, что ему «понравилось это видео». ![Три судьи апелляционного суда изучают документы]()
Апелляционный суд счёл приговор несправедливым: видео «не отражает реальных событий». ![Женщина читает своё заявление с листов за трибуной, планшет выключен]()
Срок назначат заново, а свой текст сестра прочитает сама, без видео. -
Журналист выпустил ИИ-песню от имени чужой группы
![Журналист в наушниках с хитрой улыбкой работает за ноутбуком]()
Журналист 404 Media сгенерировал песню в Udio по простому запросу. ![Трое музыкантов панк-группы в шоке смотрят в телефон]()
Трек вышел на подтверждённой странице панк-группы Lathe of Heaven в Spotify без ведома музыкантов. ![Журналист удивлённо разводит руками, вокруг висят значки музыкальных сервисов]()
Песня попала и в Apple Music, Tidal и Amazon Music — через давнюю лазейку в дистрибуции. ![Довольный мошенник ловит монеты, сыплющиеся из наушников, слушательница расстроена]()
Так мошенники зарабатывают на чужой славе. Площадки и дистрибьюторы ответственность не берут. -
Нейросеть научилась играть в «Точки» и обыгрывает автора
![Разработчик держит тетрадь в клетку с партией в точки]()
Разработчик учил нейросеть игре в «Точки» из школьной тетради — по примеру AlphaZero. ![Разработчик ночью смотрит на два монитора с партиями в точки]()
Сеть играла сама с собой: 30 поколений за полтора месяца, однажды девять пришлось выбросить. ![Разработчик радостно подпрыгивает перед монитором с выигранной партией]()
Ученик обыграл учителя, только когда поиск подняли с 800 до 1600 симуляций на ход. ![Разработчик смеётся, проиграв нейросети партию в точки]()
Теперь сложный уровень игры Just Dots стабильно обыгрывает автора на поле 20×20.
























