 FlipИИ чат
Ещё
Нейросети
-
Gemini
Gemini
-
Z.ai
Z.ai
-
ChatGPT
ChatGPT
-
DeepSeek
DeepSeek
-
Claude
Claude
-
Jev
Jev
-
Perplexity
Perplexity
-
OpenAI
OpenAI
-
Kimi
Kimi
-
Qwen
Qwen
-
Grok
Grok
-
Все модели
Все модели
-
Задачи
Задачи





Kimi Delta Attention (KDA): что это за механизм внимания и как он ускоряет декодирование

Kimi Delta Attention (KDA) — гибридный механизм линейного внимания, который лежит в основе Kimi K3, флагманской модели Moonshot AI с 2,8 триллиона параметров. По данным официального техноблога компании, KDA позволяет модели декодировать текст до 6,3 раза быстрее в контексте на миллион токенов — именно этот механизм и разбираем ниже.
KDA работает в паре со вторым компонентом архитектуры — Attention Residuals (AttnRes), который даёт около 25% прироста эффективности обучения при менее чем 2% дополнительных вычислительных затрат.
Что такое Kimi Delta Attention простыми словами
Классическое внимание трансформера считает связи между каждой парой токенов — при росте контекста до миллиона токенов вычисления и память растут квадратично. KDA заменяет это состоянием фиксированного размера и обучаемыми гейтами, которые решают, что помнить, а что забыть.
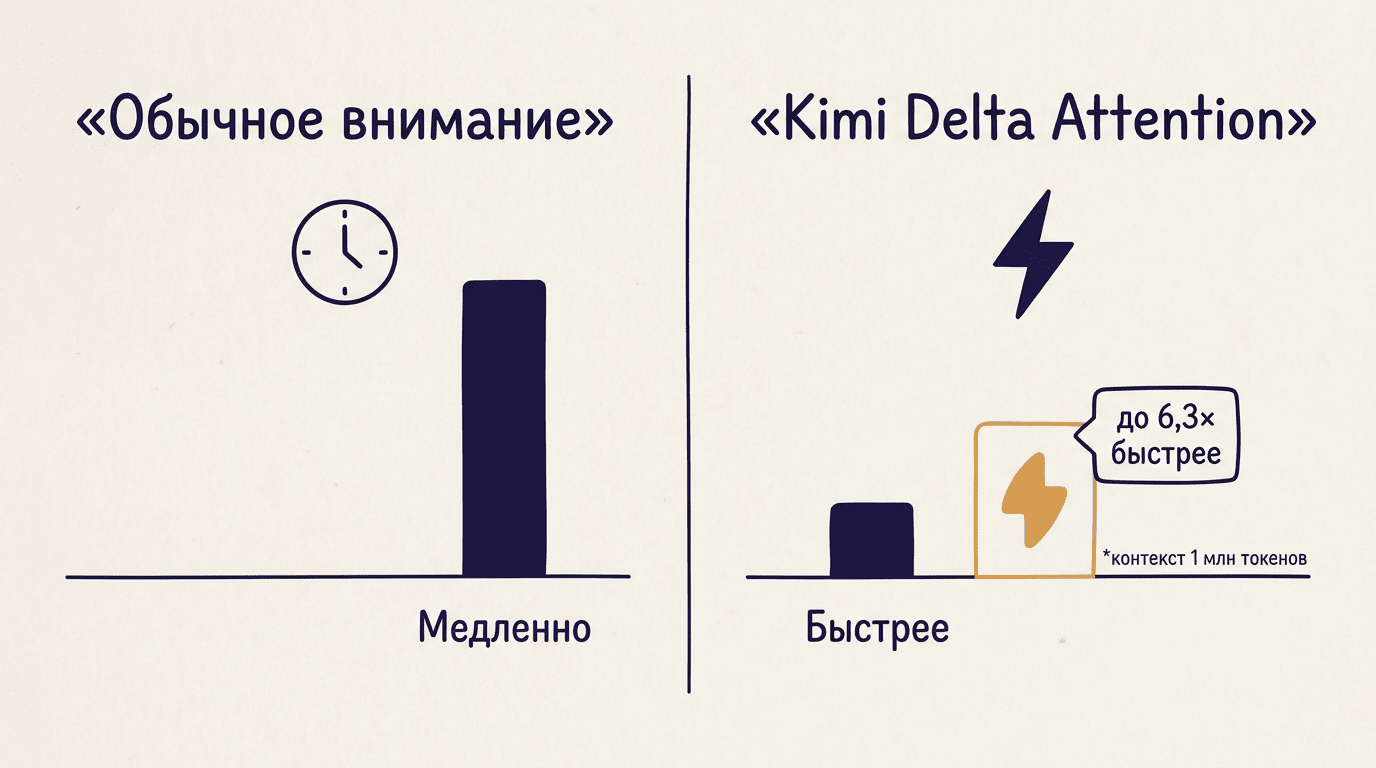
В техническом блоге релиза Moonshot AI описывает KDA как «эффективный фундамент для масштабирования внимания» — механизм, который улучшает информационный поток через длину последовательности вместо того, чтобы линейно наращивать объём хранимых данных вместе с длиной контекста.
Место KDA в архитектуре Kimi K3
Гибридное линейное внимание KDA работает в паре с Attention Residuals. Вместе эти два компонента дают 2,5-кратный прирост общей эффективности масштабирования по сравнению с предыдущей моделью Kimi K2 — так утверждает сама компания в техническом блоге о релизе.
Как KDA развивает идею Gated DeltaNet
Предшественник механизма внимания Kimi Delta Attention — Gated DeltaNet — использует один общий забывающий гейт на весь вектор состояния: все измерения памяти забываются или сохраняются синхронно. KDA идёт дальше и разбивает это решение на уровень отдельных измерений.
Посимвольный (channel-wise) гейтинг. KDA заменяет скалярный гейт Gated DeltaNet диагональной матрицей гейтов — каждое измерение памяти независимо решает, сохранять информацию или забывать её, вместо единого решения на весь вектор состояния.
Delta update rule. Гейтинг в KDA комбинируется с правилом обновления по дельте — состояние переписывается на основе разницы между новым и предсказанным значением, что даёт точную, а не приблизительную перезапись памяти.
Аппаратная оптимизация чанками. Для скорости KDA использует DPLR-матрицы и разбивает рекуррентное вычисление на независимые блоки (чанки) — то, что раньше считалось строго последовательно, теперь параллелится на Tensor Cores современных ускорителей.
Как отмечает разбор архитектуры на DigitalOcean, именно такое сочетание тонкого посимвольного контроля памяти и аппаратно-дружественного параллелизма отличает KDA от более ранних вариантов линейного внимания:
Kimi Delta Attention сочетает channel-wise gating с delta update rule и хардвер-эффективным чанкованием, что делает линейное внимание практически применимым на масштабе миллиона токенов.DigitalOcean, разбор архитектуры Kimi Linear
Из-за этого гибридный механизм внимания KDA обходится дешевле по памяти на длинных последовательностях, но требует более сложного обучения гейтов на этапе тренировки модели.
Ключевые отличия KDA от Gated DeltaNet сводятся к трём пунктам:
- гейтинг переходит от одного скалярного значения к диагональной матрице на всё измерение состояния;
- обновление памяти построено на delta update rule, а не на простом накоплении;
- вычисление разбито на чанки, что позволяет загружать Tensor Cores параллельно, а не последовательно.
Разница между двумя механизмами линейного внимания видна в сводной таблице.
| Характеристика | Gated DeltaNet | Kimi Delta Attention |
|---|---|---|
| Тип гейта забывания | Скалярный (общий на весь вектор) | Диагональная матрица (посимвольный) |
| Правило обновления | Delta update rule | Delta update rule + channel-wise гейтинг |
| Аппаратная оптимизация | Последовательное вычисление | Чанкованное, параллельное на Tensor Cores |
Гибридная схема: KDA плюс полное внимание
Линейное внимание слабее полного внимания на очень дальних, точных зависимостях между токенами, расположенными далеко друг от друга в тексте. Поэтому чистое линейное внимание в Kimi K3 не используют одно.
Причины, по которым архитектура остаётся гибридной, а не полностью линейной:
- фиксированное состояние KDA теряет часть точности на очень длинных, разреженных зависимостях;
- MLA восстанавливает эту точность за счёт полного пересчёта связей между токенами в своём слое;
- соотношение 3:1 подобрано так, чтобы издержки полного внимания оставались минимальными, а качество — сопоставимым с чистым MLA.
Соотношение слоёв в архитектуре Kimi Linear
В архитектуре Kimi Linear на каждые три слоя KDA приходится один слой полного внимания MLA, которое компенсирует эту слабость на длинных, точных зависимостях. Ниже — сводка того, что даёт такая комбинация на практике.
| Параметр | Классическое внимание | Гибрид KDA + MLA (Kimi Linear) |
|---|---|---|
| Рост вычислений с длиной контекста | Квадратичный | Практически линейный |
| Использование KV-кэша | Базовый уровень (100%) | Минус 75% |
| Скорость декодирования на 1M токенов | Базовый уровень (1x) | До 6x быстрее |
| Соотношение слоёв | Только полное внимание | 3 слоя KDA : 1 слой MLA |
Комбинация KDA и MLA снижает использование KV-кэша на 75% и увеличивает пропускную способность декодирования до 6 раз на контексте в 1 миллион токенов — это контекстное окно на 1 миллион токенов становится практически применимым, а не только заявленным числом.
Attention Residuals: второй компонент архитектуры
Если KDA отвечает за эффективность по длине последовательности, то Attention Residuals работает по глубине сети — выборочно извлекает представления слоёв, а не накапливает их равномерно, как это делают обычные residual-соединения в трансформере.
Два компонента архитектуры дополняют друг друга по разным осям:
- KDA оптимизирует работу с длиной контекста — от коротких запросов до 1 миллиона токенов;
- Attention Residuals оптимизирует работу с глубиной сети — сколько слоёв нужно пройти сигналу до финального представления.
Как устроено извлечение представлений
Вместо того чтобы прибавлять выход каждого слоя к общему потоку по одинаковой схеме, Attention Residuals выбирает, какие представления из глубины сети действительно полезны для текущего вычисления, и передаёт дальше именно их.
Цена и эффект
По данным независимого разбора релиза, AttnRes даёт около 25% более высокую эффективность обучения при менее чем 2% дополнительных вычислительных затрат — почти бесплатный прирост качества относительно стоимости тренировки модели.
Что это значит для модели Kimi K3 в цифрах
KDA и AttnRes — часть архитектуры модели Kimi K3 на 2,8 триллиона параметров, где MoE-часть (Stable LatentMoE) активирует лишь 16 из 896 экспертов на токен. Открытые веса модели делают архитектуру KDA проверяемой независимыми исследователями — подробнее в разборе открытых весов и их проверяемости.
Благодаря KDA и связанной оптимизации кэша скорость декодирования в целевой конфигурации достигает 8700 токенов в секунду, а коэффициент попадания кэша в задачах кодирования превышает 90% — по данным независимого разбора релиза MarkTechPost. Kimi K3 запущена 16 июля 2026 года, открытые веса модели ожидаются 27 июля 2026 года.
Проверить, как гибридное линейное внимание Kimi K3 отражается на скорости конкретной задачи, можно по шагам:
- Определите длину контекста задачи — эффект KDA заметен от десятков тысяч токенов и растёт к отметке 1M.
- Сравните KV-кэш до и после — на длинных контекстах гибрид KDA + MLA экономит до 75% памяти под кэш.
- Проверьте задержку первого токена — она снижается за счёт фиксированного размера состояния KDA вместо растущего KV-кэша.
- Оцените скорость декодирования — в целевой конфигурации Moonshot AI заявляет до 8700 токенов в секунду.
- Для кодовых задач учтите коэффициент попадания кэша — у Kimi K3 он превышает 90%, что снижает стоимость повторных запросов.
Все технические разборы релизов моделей Moonshot AI и других лабораторий собраны на AI-Flip — там же следите за обновлениями по теме.
Основные архитектурные компоненты Kimi K3, о которых стоит помнить:
- Kimi Delta Attention (KDA) — гибридное линейное внимание с посимвольным гейтингом.
- Attention Residuals (AttnRes) — селективное извлечение представлений по глубине сети.
- MLA — слой полного внимания, компенсирующий слабость KDA на дальних зависимостях.
- Stable LatentMoE — MoE-фреймворк, активирующий 16 из 896 экспертов на токен.
FAQ
Что такое Kimi Delta Attention?
Гибридный механизм линейного внимания в модели Kimi K3, который заменяет квадратично растущий KV-кэш классического внимания состоянием фиксированного размера с обучаемыми посимвольными гейтами.
Чем KDA отличается от обычного внимания трансформера?
Классическое внимание пересчитывает связи между всеми парами токенов (квадратичная сложность), KDA использует фиксированное состояние и гейты забывания, что даёт до 6,3x ускорение декодирования на контексте 1M токенов.
Что такое Attention Residuals в Kimi K3?
Второй архитектурный компонент Kimi K3, который выборочно извлекает представления по глубине сети и даёт около 25% прироста эффективности обучения при менее чем 2% дополнительных затрат.
Насколько KDA быстрее классического внимания?
По данным Moonshot AI и независимого разбора MarkTechPost, KDA даёт до 6,3 раза более быстрое декодирование на контексте в миллион токенов и снижает использование KV-кэша на 75% в гибридной архитектуре Kimi Linear.
Что такое Gated DeltaNet и как KDA его развивает?
Gated DeltaNet — более ранний механизм линейного внимания со скалярным гейтом забывания. KDA заменяет его посимвольным (channel-wise) гейтингом — диагональной матрицей, где каждое измерение памяти управляется независимо.
Используется ли в Kimi K3 только линейное внимание?
Нет. Архитектура гибридная: на каждые три слоя KDA приходится один слой полного внимания (MLA), который компенсирует слабость линейного внимания на очень дальних зависимостях.
-
Маршрут от Claude привёл подростка на «Вдоводел»
![Подросток в синей куртке и шлеме радостно смотрит маршрут в телефоне на вершине горы над городом]()
16-летний Брайс из Ванкувера проложил с Claude новый для себя маршрут на гору Краун. ![Подросток с рюкзаком неуверенно пробирается между валунами к крутому гребню]()
Разметки не было: вместо кулуара он попал на гребень «Вдоводел», куда ходят с верёвками. ![Испуганный подросток прижался к отвесной скале на узком уступе и звонит по телефону]()
Брайс застрял на уступе шириной около полутора метров: сзади обрыв, впереди почти отвесная стена. ![Спасатель спускается по верёвке к подростку на уступе, рядом вертолёт]()
Вертолёт не мог подойти к скале: спасатель спустился к Брайсу по верёвке, и его подняли на борт. ![Подросток в спасательном одеяле сидит у тропы с бумажной картой, рядом компас]()
Брайс винит себя, но тропы через ИИ больше не прокладывает. Спасатель: «Claude никогда не был в этих местах». -
950 агентов Claude нашли в ДНК вирусов загадочную систему
![Учёная в лаборатории смотрит на монитор со спиралями ДНК]()
Anthropic поручила Claude найти в огромной базе ДНК необычные ферменты. ![Учёная с планшетом смотрит на стену из сотен мониторов с ДНК]()
Около 950 агентов за 21 час собрали больше 200 тысяч ферментов и написали 20 отчётов. ![Учёная взволнованно показывает на повторяющийся узор в цепочке ДНК на экране]()
Один агент «на глаз» заметил рядом с ферментом повторы, как у CRISPR. Систему назвали ART. ![Учёная поднимает пробирку к свету, коллега задумчиво смотрит рядом]()
Что она делает, пока неизвестно. Пионер CRISPR Фэн Чжан назвал находку «по-настоящему интригующей». -
Anthropic запретила издеваться над Claude
![Женщина в очках сердито кричит на ноутбук и стучит кулаком по столу]()
Anthropic запретила «длительное и бессмысленное» жестокое обращение с Claude. ![Женщина спокойно спорит, разводя рукой перед ноутбуком]()
Речь о крайних случаях. Раздражение, споры, мрачные сюжеты и тесты под запрет не попадают. ![Удивлённая женщина смотрит на ноутбук со значком закрытой двери на экране]()
Главная защита прежняя: Claude сам завершает такой диалог. ![Женщина прикрепляет к доске календарь с обведённым днём]()
Правила действуют с 12 ноября. За нарушения доступ могут ограничить или закрыть. -
ИИ-видео с погибшим в суде: срок назначат заново
![Женщина в зале суда показывает планшет с лицом мужчины]()
В Аризоне сестра погибшего показала в суде видео, где ИИ-аватар брата прощает убийцу. ![Растроганный судья с рукой на груди за судейским столом]()
Судья дал максимальные 10,5 года и сказал, что ему «понравилось это видео». ![Три судьи апелляционного суда изучают документы]()
Апелляционный суд счёл приговор несправедливым: видео «не отражает реальных событий». ![Женщина читает своё заявление с листов за трибуной, планшет выключен]()
Срок назначат заново, а свой текст сестра прочитает сама, без видео. -
Журналист выпустил ИИ-песню от имени чужой группы
![Журналист в наушниках с хитрой улыбкой работает за ноутбуком]()
Журналист 404 Media сгенерировал песню в Udio по простому запросу. ![Трое музыкантов панк-группы в шоке смотрят в телефон]()
Трек вышел на подтверждённой странице панк-группы Lathe of Heaven в Spotify без ведома музыкантов. ![Журналист удивлённо разводит руками, вокруг висят значки музыкальных сервисов]()
Песня попала и в Apple Music, Tidal и Amazon Music — через давнюю лазейку в дистрибуции. ![Довольный мошенник ловит монеты, сыплющиеся из наушников, слушательница расстроена]()
Так мошенники зарабатывают на чужой славе. Площадки и дистрибьюторы ответственность не берут. -
Нейросеть научилась играть в «Точки» и обыгрывает автора
![Разработчик держит тетрадь в клетку с партией в точки]()
Разработчик учил нейросеть игре в «Точки» из школьной тетради — по примеру AlphaZero. ![Разработчик ночью смотрит на два монитора с партиями в точки]()
Сеть играла сама с собой: 30 поколений за полтора месяца, однажды девять пришлось выбросить. ![Разработчик радостно подпрыгивает перед монитором с выигранной партией]()
Ученик обыграл учителя, только когда поиск подняли с 800 до 1600 симуляций на ход. ![Разработчик смеётся, проиграв нейросети партию в точки]()
Теперь сложный уровень игры Just Dots стабильно обыгрывает автора на поле 20×20.
























