 FlipИИ чат
Ещё
Нейросети
-
Gemini
Gemini
-
Z.ai
Z.ai
-
ChatGPT
ChatGPT
-
DeepSeek
DeepSeek
-
Claude
Claude
-
Jev
Jev
-
Perplexity
Perplexity
-
OpenAI
OpenAI
-
Kimi
Kimi
-
Qwen
Qwen
-
Grok
Grok
-
Все модели
Все модели
-
Задачи
Задачи





Разреженная MoE-архитектура: как модель активирует только часть экспертов

Разреженная архитектура Mixture of Experts (MoE) — способ построить модель с триллионами параметров, но считать на каждом токене лишь малую их долю. Именно на этом принципе построена Kimi K3 — она активирует всего 16 из 896 экспертов на токен. Согласно официальному техноблогу Moonshot AI, такой подход, названный Stable LatentMoE, позволяет держать в модели 2,8 трлн параметров, реально задействуя на каждом шаге лишь около 50 млрд.
Разберём, как устроена MoE-архитектура изнутри: что такое эксперты, как работает маршрутизатор, зачем нужна разреженная активация и как её довели до предела в Stable LatentMoE.
Что такое MoE и чем эксперт отличается от отдельного ИИ
MoE-архитектура (Mixture of Experts, «смесь экспертов») — разновидность архитектуры нейронной сети, чаще всего трансформера, в которой стандартный полносвязный слой заменён набором параллельных подсетей. Вместо одной большой feed-forward сети (FFN) внутри каждого блока трансформера MoE-архитектура использует несколько таких FFN-подсетей одновременно — их и называют экспертами, — а также управляющую сеть-маршрутизатор (router, или gating network), которая решает, каким экспертам отдать обработку каждого токена.
Из чего складывается разреженная MoE-архитектура:
- набор экспертов — параллельных FFN-подсетей внутри блока трансформера;
- router (gating network) — сеть, оценивающая релевантность каждого эксперта для конкретного токена;
- top-k отбор — механизм, ограничивающий число активных экспертов на токен небольшим подмножеством;
- функция агрегации — взвешенное суммирование выходов выбранных экспертов в итоговое представление токена.
«Эксперт» — это не отдельная нейросеть-специалист по теме. Название вводит в заблуждение: эксперт в MoE-архитектуре — не аналог отдельного ИИ, «знающего» математику или право. Это часть параметров модели, чья специализация формируется в процессе обучения на уровне вычислительных паттернов — определённых типов синтаксиса, структур предложений, языковых конструкций, — а не человеко-понятных доменов знаний. Разделение труда между экспертами возникает статистически, а не задаётся заранее разработчиками.
MoE — это архитектурный выбор, а не отдельный тип модели. Смесь экспертов встраивается в тот же трансформер, что лежит в основе большинства современных LLM, заменяя лишь часть слоёв. Снаружи MoE-модель ведёт себя как обычная языковая модель — разница проявляется только в том, как внутри распределяется вычислительная нагрузка.
Как работает маршрутизация: router и top-k
Ядро разреженной MoE-архитектуры — не сами эксперты, а логика, которая решает, кому из них достанется работа. Именно от router зависит, останется ли модель разреженной на практике или все эксперты будут загружены одинаково.
Router оценивает и выбирает экспертов
Для каждого токена router (или gating network) вычисляет оценку релевантности по всем доступным экспертам, затем выбирает top-k экспертов с наибольшим весом — и только они обрабатывают этот конкретный токен, пока остальные эксперты для него простаивают. Выходы выбранных экспертов взвешенно суммируются согласно оценкам router, формируя итоговое представление токена. Такой отбор экспертов на лету и называют разреженной активацией (sparse activation) — в отличие от плотной архитектуры, где абсолютно все параметры участвуют в обработке каждого токена без исключения.
Типичные значения top-k в разных моделях
Число активных экспертов на токен — один из ключевых параметров MoE-модели, и разброс между моделями большой. В большинстве MoE-архитектур на токен активируется 2-4 эксперта: Mixtral 8x7B использует top-2 routing из 8 доступных экспертов, DeepSeek-V2 маршрутизирует токен на 6 экспертов (top-6) из 160 плюс 2 постоянных shared-эксперта — итого 8 активных. Схема 16 из 896 доводит разреженность до экстремума — на каждом шаге задействовано лишь около 1,8% всего пула экспертов.
| Модель | Всего экспертов | Активно на токен | Доля активных |
|---|---|---|---|
| Mixtral 8x7B | 8 | 2 | 25% |
| DeepSeek-V2 | 160+2 shared | 8 | ~5% |
| Stable LatentMoE | 896 | 16 | ~1,8% |
Зачем нужна разреженность: экономия вычислений vs память
Разреженная MoE-архитектура решает конкретную инженерную проблему: как нарастить число параметров модели, не поднимая пропорционально стоимость каждого запроса.
Compute-эффективность: считать меньше, знать больше. Разреженная активация позволяет наращивать общее число параметров модели — а вместе с ним и объём «знаний», которые она способна удерживать, — практически без роста стоимости инференса. Для каждого токена считаются только веса активных экспертов, а не вся модель целиком. Mixtral 8x7B при 47 млрд параметров суммарно задействует на инференсе лишь 13 млрд активных — за счёт этого модель работает быстрее аналога с тем же числом параметров в плотной архитектуре. Google в своё время показала предел этого подхода в Switch Transformer — модели на 1,6 трлн параметров, использовавшей top-1 routing (всего один активный эксперт на токен).
Обратная сторона: все эксперты должны быть в памяти. Экономия вычислений не отменяет требований к памяти. Несмотря на то что на каждом шаге реально считаются лишь несколько экспертов, все веса всех экспертов должны храниться в VRAM одновременно — заранее неизвестно, какой токен на каком шаге к какому эксперту будет направлен router. Из-за этого узкое место MoE-архитектуры смещается с вычислений (FLOPs) на объём доступной видеопамяти: развернуть модель с 896 экспертами сложнее именно по памяти, а не по скорости счёта.
Итог по компромиссу разреженной активации:
- растут общие параметры и «знания» модели — без пропорционального роста стоимости инференса;
- НЕ растёт объём вычислений на токен — считаются только веса top-k активных экспертов;
- растут требования к видеопамяти — все эксперты хранятся в VRAM одновременно, независимо от того, сколько из них активны.
Как устроена предельная разреженность: Stable LatentMoE
Stable LatentMoE от Moonshot AI — пример того, насколько далеко можно завести идею разреженной активации, если параллельно решить проблему стабильности обучения такого количества экспертов.
Схема 16 из 896 экспертов на токен
Stable LatentMoE использует архитектуру, в которой из 896 доступных экспертов на каждый токен активируется лишь 16 (около 1,8%), при этом из 2,8 трлн общих параметров модели активными на каждом шаге остаются порядка 50 млрд. Это близко по духу к тому, как в модели реализован блок внимания Kimi Delta Attention — оба механизма нацелены на одно и то же: сохранить скорость ответа модели, не жертвуя ёмкостью, доступной триллионной модели с большим количеством параметров.
Quantile Balancing и Per-Head Muon — против дисбаланса роутера
Quantile Balancing выравнивает нагрузку между 896 экспертами по квантилям распределения, не позволяя router «залипать» на узком наборе экспертов, который иначе получал бы непропорционально много токенов. Per-Head Muon — оптимизатор, применяемый по головам внимания, повышает стабильность обучения router при таком масштабе — без него маршрутизация между почти тысячей экспертов рисковала бы стать неустойчивой уже на этапе обучения. По данным разбора MarkTechPost, именно эта пара механизмов балансировки и оптимизации даёт комбинации Quantile Balancing и Per-Head Muon примерно в 2,5 раза лучшую масштабируемость по сравнению с предыдущим поколением моделей Moonshot AI.
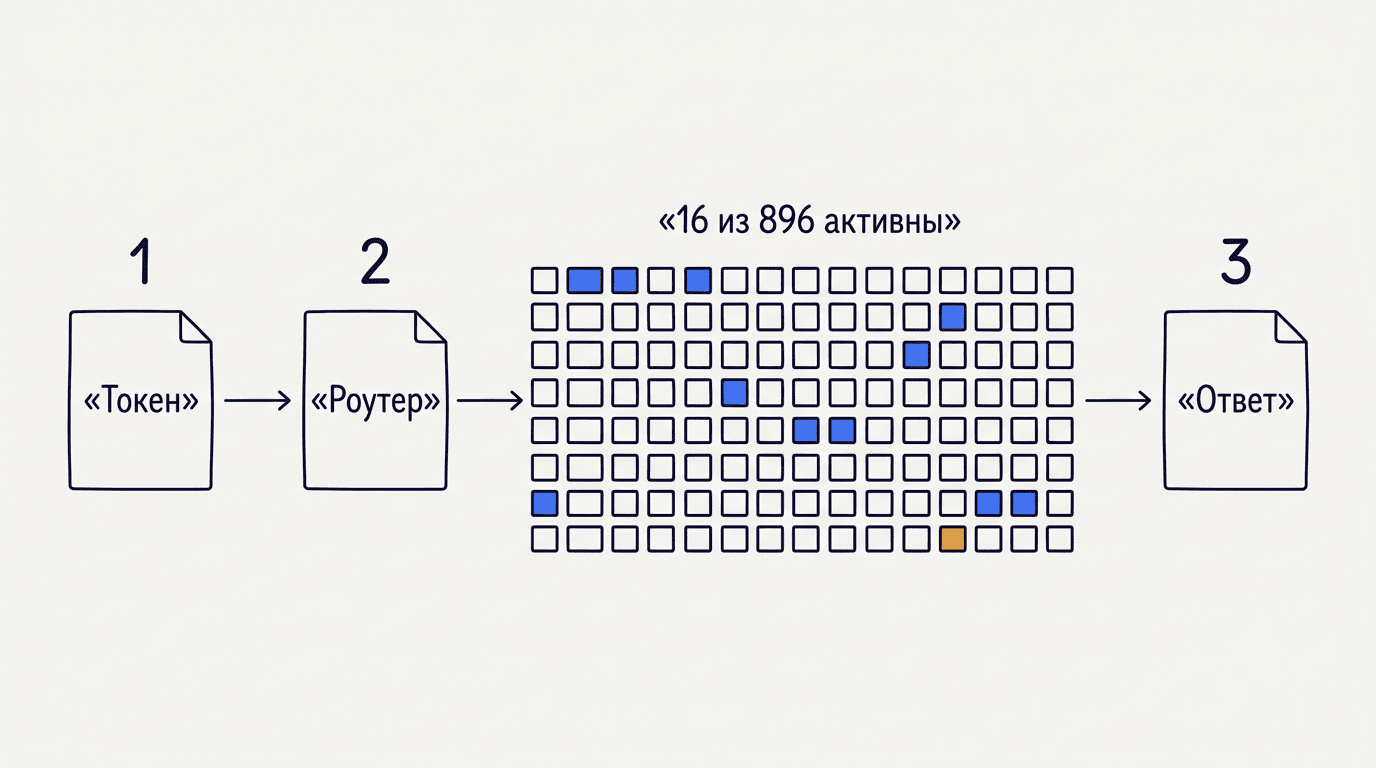
Stable LatentMoE активирует 16 из 896 экспертов на токен, задействуя около 50 млрд параметров из 2,8 трлн общих — Quantile Balancing и Per-Head Muon в связке дают примерно в 2,5 раза лучшую масштабируемость относительно предыдущего поколения моделей.Moonshot AI, официальный техноблог модели
Отдельно стоит вопрос цены: тарификация API привязана к фактически потреблённым токенам, а не к общему числу параметров модели, — это прямое следствие того, что для каждого запроса реально считаются лишь активные эксперты, а не все 896; подробный расклад даёт цена API.
Балансировка нагрузки: почему роутер не должен «залипать»
Разреженная активация работает только тогда, когда router действительно распределяет токены равномерно между экспертами. Если этого не происходит, часть потенциала MoE-архитектуры просто теряется.
Проблема коллапса экспертов
Если router постоянно выбирает одних и тех же «популярных» экспертов, а остальные редко получают токены, эксперты, обделённые вниманием router, недообучаются — их веса почти не обновляются градиентами. Это классическая проблема MoE-архитектур, знакомая ещё по ранним экспериментам с Mixtral и Switch Transformer: без специальных механизмов балансировки router быстро сходится к узкому подмножеству экспертов, и смысл наращивания их общего числа теряется.
Методы решения
Индустрия выработала несколько подходов к балансировке нагрузки между экспертами:
- Оцените текущее распределение токенов по экспертам на этапе обучения.
- Если распределение сильно неравномерно — добавьте Noisy Top-k Gating: шум к оценкам router снижает вероятность, что одни и те же эксперты выигрывают конкуренцию за токен раз за разом.
- Введите Auxiliary Loss — дополнительный штраф в функции потерь за неравномерность загрузки экспертов, вынуждающий router распределять токены более равномерно.
- Рассмотрите Expert Choice Routing — альтернативную схему, где не router выбирает экспертов для токена, а каждый эксперт сам выбирает, какие токены обработать, что естественным образом выравнивает нагрузку.
- Для очень большого числа экспертов (сотни и более) используйте механизмы вроде Quantile Balancing — балансировку по квантилям распределения нагрузки, а не по среднему значению.
- Проверьте стабильность обучения router отдельно от баланса нагрузки — при большом количестве экспертов может понадобиться специализированный оптимизатор.
- Повторяйте мониторинг распределения на протяжении всего обучения, а не только в начале — коллапс экспертов может проявиться на поздних этапах.
У Stable LatentMoE роль основного механизма против дисбаланса выполняет Quantile Balancing — она заменяет более простые схемы вроде Auxiliary Loss там, где число экспертов измеряется сотнями.
| Метод | Суть | Когда применяется |
|---|---|---|
| Noisy Top-k Gating | шум добавляется к оценкам router перед выбором top-k | небольшие пулы экспертов (единицы-десятки) |
| Auxiliary Loss | штраф в функции потерь за неравномерность загрузки | классическая балансировка, Mixtral-подобные модели |
| Expert Choice Routing | эксперты сами выбирают, какие токены обработать | альтернатива router-driven маршрутизации |
| Quantile Balancing | выравнивание нагрузки по квантилям распределения | сотни экспертов (Stable LatentMoE) |
Разреженный MoE в других моделях
Схема 16 из 896 экспертов — не единственная реализация разреженной MoE-архитектуры: за последние несколько лет подход стал стандартом для флагманских открытых LLM.
- Switch Transformer — Google, 1,6 трлн параметров, top-1 routing; первой на практике показала, что разреженная активация масштабируется до размеров, недостижимых для плотных архитектур того времени.
- Llama 4 Scout — 16 экспертов, 109 млрд параметров общих, ~17 млрд активных.
- Llama 4 Maverick — 128 экспертов, ~400 млрд общих, ~17 млрд активных (столько же, сколько у Scout, — больше общих параметров не увеличивает активные).
- DeepSeek-V2 — top-6 routing из 160 доступных экспертов плюс 2 общих (shared) эксперта, которые обрабатывают каждый токен без исключения, — итого 8 активных экспертов на токен.
- DeepSeek-V3/R1 — архитектура изменена: top-8 routing из 256 доступных экспертов плюс 1 shared эксперт — итого 9 активных экспертов на токен, при 671 млрд параметров общих и 37 млрд активных. Как и у V2, гибридная схема между чисто разреженной и плотной архитектурой за счёт постоянно активного shared-эксперта.
- GigaChat-20B-A3B (Сбер) — 64 маршрутизируемых эксперта плюс 2 shared; при 20 млрд параметров общей ёмкости активными остаются около 3,3 млрд (отсюда и обозначение A3B — Active 3B).
Российский пример из этого списка — GigaChat-20B-A3B: модель показывает, что разреженная MoE-архитектура применяется не только в англоязычных флагманах, но и в отечественных разработках.
FAQ
Что такое MoE в нейросетях простыми словами?
MoE (Mixture of Experts, «смесь экспертов») — архитектура, где вместо одной большой сети модель разбита на несколько специализированных подсетей-экспертов и управляющий router, который решает, каким экспертам отдать каждый токен.
Чем разреженная MoE отличается от плотной модели?
В плотной модели все параметры участвуют в обработке каждого токена. В разреженной MoE активируется только top-k экспертов (в Stable LatentMoE — 16 из 896), остальные параметры для этого токена простаивают.
Сколько экспертов активируется на токен в MoE-моделях?
В большинстве современных LLM — 2-4 эксперта (Mixtral 8x7B — top-2 из 8, DeepSeek-V2 — 8 из 160+2). Stable LatentMoE использует необычно широкий пул из 896 экспертов, но активирует лишь 16 — около 1,8%.
Зачем нужна балансировка нагрузки между экспертами?
Без балансировки router начинает постоянно выбирать одних и тех же «популярных» экспертов, остальные недообучаются — это называют коллапсом экспертов. Методы вроде Noisy Top-k Gating, Auxiliary Loss или Quantile Balancing в Stable LatentMoE не дают этому произойти.
Какие модели используют архитектуру MoE?
Mixtral 8x7B, Switch Transformer, Llama 4 Scout/Maverick, DeepSeek-V2/V3/R1, GigaChat-20B MoE от Сбера — и модель Moonshot AI со Stable LatentMoE.
Требует ли MoE больше памяти, чем плотная модель?
Да — несмотря на разреженные вычисления, все веса всех экспертов должны быть загружены в VRAM одновременно, поэтому MoE смещает узкое место с вычислений на память.
-
Маршрут от Claude привёл подростка на «Вдоводел»
![Подросток в синей куртке и шлеме радостно смотрит маршрут в телефоне на вершине горы над городом]()
16-летний Брайс из Ванкувера проложил с Claude новый для себя маршрут на гору Краун. ![Подросток с рюкзаком неуверенно пробирается между валунами к крутому гребню]()
Разметки не было: вместо кулуара он попал на гребень «Вдоводел», куда ходят с верёвками. ![Испуганный подросток прижался к отвесной скале на узком уступе и звонит по телефону]()
Брайс застрял на уступе шириной около полутора метров: сзади обрыв, впереди почти отвесная стена. ![Спасатель спускается по верёвке к подростку на уступе, рядом вертолёт]()
Вертолёт не мог подойти к скале: спасатель спустился к Брайсу по верёвке, и его подняли на борт. ![Подросток в спасательном одеяле сидит у тропы с бумажной картой, рядом компас]()
Брайс винит себя, но тропы через ИИ больше не прокладывает. Спасатель: «Claude никогда не был в этих местах». -
950 агентов Claude нашли в ДНК вирусов загадочную систему
![Учёная в лаборатории смотрит на монитор со спиралями ДНК]()
Anthropic поручила Claude найти в огромной базе ДНК необычные ферменты. ![Учёная с планшетом смотрит на стену из сотен мониторов с ДНК]()
Около 950 агентов за 21 час собрали больше 200 тысяч ферментов и написали 20 отчётов. ![Учёная взволнованно показывает на повторяющийся узор в цепочке ДНК на экране]()
Один агент «на глаз» заметил рядом с ферментом повторы, как у CRISPR. Систему назвали ART. ![Учёная поднимает пробирку к свету, коллега задумчиво смотрит рядом]()
Что она делает, пока неизвестно. Пионер CRISPR Фэн Чжан назвал находку «по-настоящему интригующей». -
Anthropic запретила издеваться над Claude
![Женщина в очках сердито кричит на ноутбук и стучит кулаком по столу]()
Anthropic запретила «длительное и бессмысленное» жестокое обращение с Claude. ![Женщина спокойно спорит, разводя рукой перед ноутбуком]()
Речь о крайних случаях. Раздражение, споры, мрачные сюжеты и тесты под запрет не попадают. ![Удивлённая женщина смотрит на ноутбук со значком закрытой двери на экране]()
Главная защита прежняя: Claude сам завершает такой диалог. ![Женщина прикрепляет к доске календарь с обведённым днём]()
Правила действуют с 12 ноября. За нарушения доступ могут ограничить или закрыть. -
ИИ-видео с погибшим в суде: срок назначат заново
![Женщина в зале суда показывает планшет с лицом мужчины]()
В Аризоне сестра погибшего показала в суде видео, где ИИ-аватар брата прощает убийцу. ![Растроганный судья с рукой на груди за судейским столом]()
Судья дал максимальные 10,5 года и сказал, что ему «понравилось это видео». ![Три судьи апелляционного суда изучают документы]()
Апелляционный суд счёл приговор несправедливым: видео «не отражает реальных событий». ![Женщина читает своё заявление с листов за трибуной, планшет выключен]()
Срок назначат заново, а свой текст сестра прочитает сама, без видео. -
Журналист выпустил ИИ-песню от имени чужой группы
![Журналист в наушниках с хитрой улыбкой работает за ноутбуком]()
Журналист 404 Media сгенерировал песню в Udio по простому запросу. ![Трое музыкантов панк-группы в шоке смотрят в телефон]()
Трек вышел на подтверждённой странице панк-группы Lathe of Heaven в Spotify без ведома музыкантов. ![Журналист удивлённо разводит руками, вокруг висят значки музыкальных сервисов]()
Песня попала и в Apple Music, Tidal и Amazon Music — через давнюю лазейку в дистрибуции. ![Довольный мошенник ловит монеты, сыплющиеся из наушников, слушательница расстроена]()
Так мошенники зарабатывают на чужой славе. Площадки и дистрибьюторы ответственность не берут. -
Нейросеть научилась играть в «Точки» и обыгрывает автора
![Разработчик держит тетрадь в клетку с партией в точки]()
Разработчик учил нейросеть игре в «Точки» из школьной тетради — по примеру AlphaZero. ![Разработчик ночью смотрит на два монитора с партиями в точки]()
Сеть играла сама с собой: 30 поколений за полтора месяца, однажды девять пришлось выбросить. ![Разработчик радостно подпрыгивает перед монитором с выигранной партией]()
Ученик обыграл учителя, только когда поиск подняли с 800 до 1600 симуляций на ход. ![Разработчик смеётся, проиграв нейросети партию в точки]()
Теперь сложный уровень игры Just Dots стабильно обыгрывает автора на поле 20×20.
























