 FlipИИ чат
Ещё
Нейросети
-
Gemini
Gemini
-
Z.ai
Z.ai
-
ChatGPT
ChatGPT
-
DeepSeek
DeepSeek
-
Claude
Claude
-
Jev
Jev
-
Perplexity
Perplexity
-
OpenAI
OpenAI
-
Kimi
Kimi
-
Qwen
Qwen
-
Grok
Grok
-
Все модели
Все модели
-
Задачи
Задачи





OpenAI API: ключи, запросы, вызов инструментов, кэширование и официальные SDK

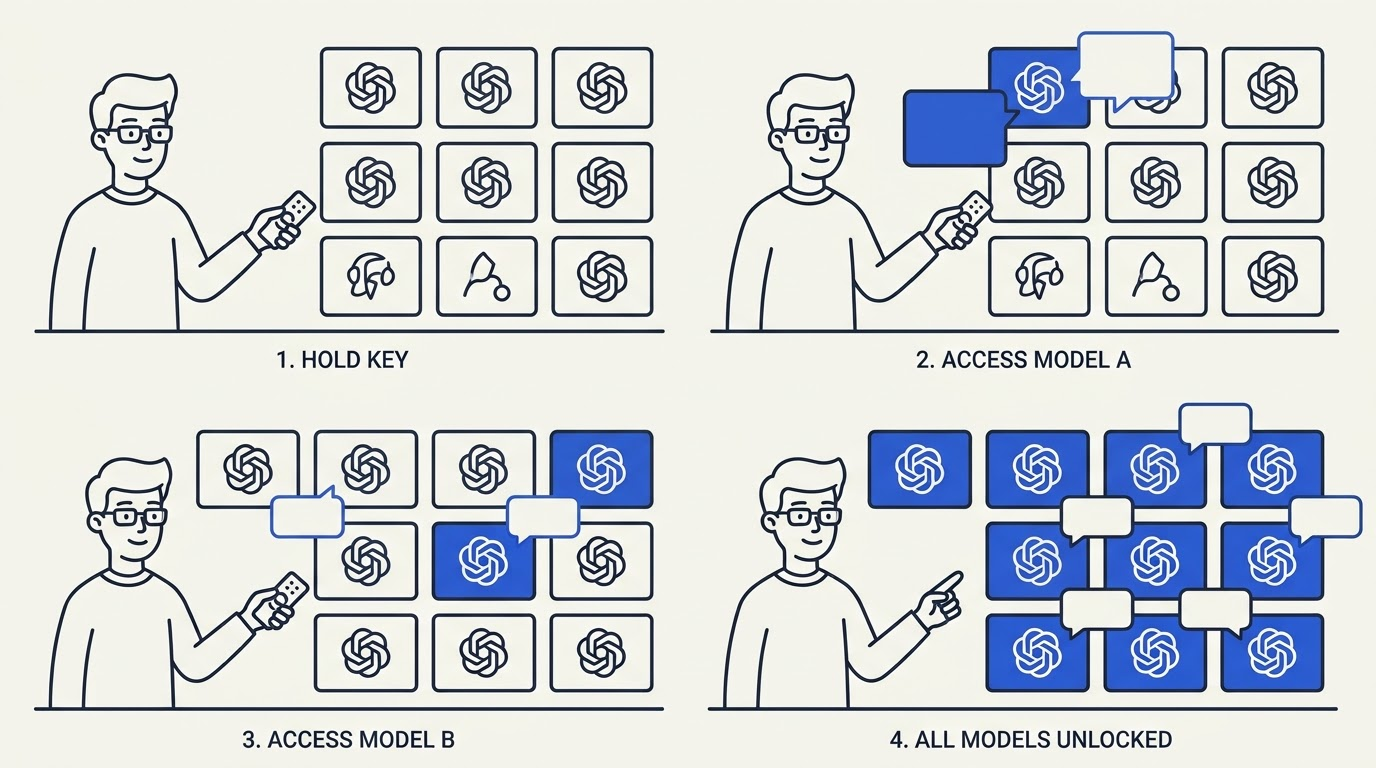
OpenAI API открывает программный доступ к моделям GPT-4o, GPT-4.1 и другим через обычные HTTP-запросы с секретным ключом в заголовке и структурированным JSON в ответе. Официальная библиотека OpenAI для Python устанавливается командой pip install openai, для Node.js/TypeScript — npm install openai; обе читают ключ из окружения и скрывают детали HTTP. Если вы только начинаете — регистрация в ChatGPT и аккаунт разработчика существуют на одном сайте OpenAI, но баланс API и подписка ChatGPT — отдельные сущности с раздельной оплатой.
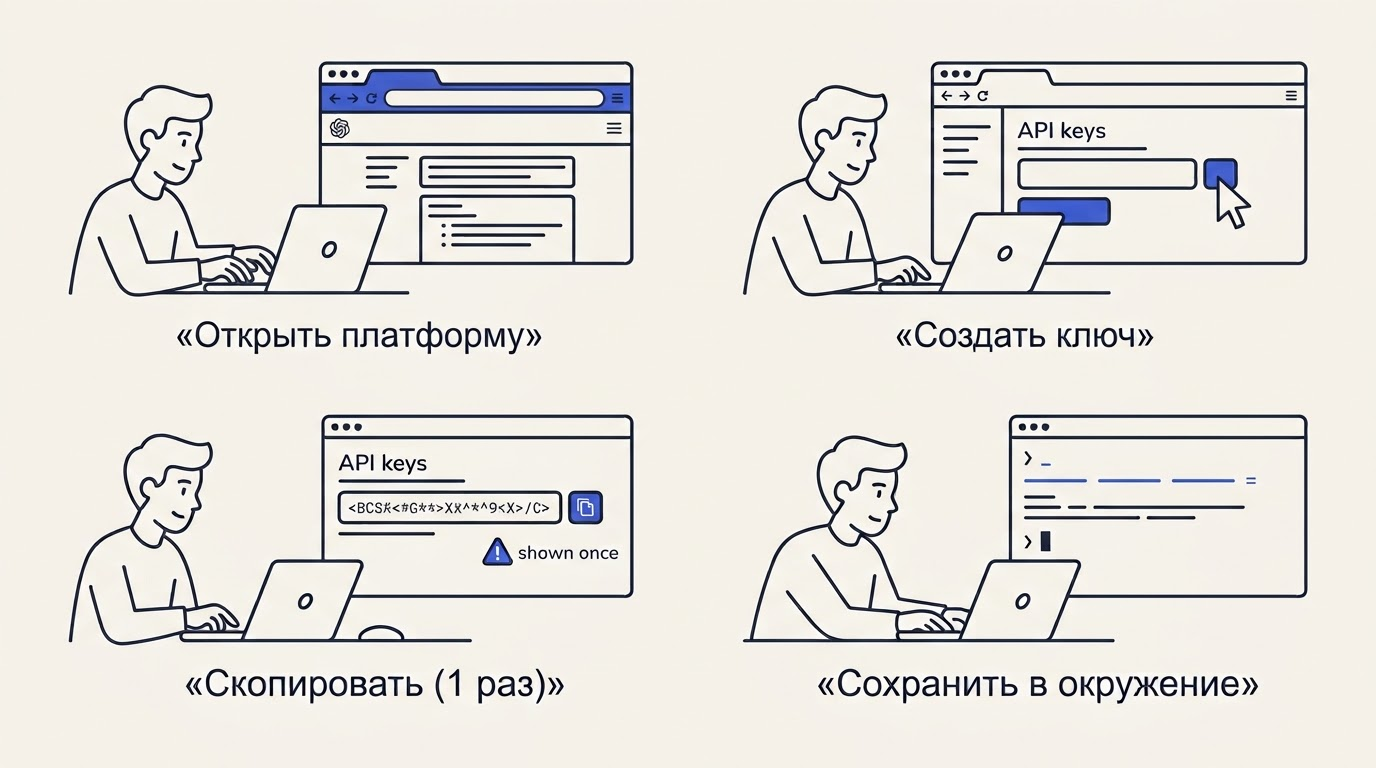
Ключ создаётся в разделе API keys на platform.openai.com и передаётся в заголовке Authorization: Bearer; он показывается ровно один раз, поэтому его сразу сохраняют в переменную окружения OPENAI_API_KEY или секрет-менеджер.
В этой статье разбираем всё по шагам: как создать и защитить ключ, как выглядит первый запрос к Chat Completions и Responses API, как настроить вызов инструментов через tools и tool_calls, при каком размере промпта включается кэширование и какую даёт скидку, а также как работают лимиты RPM/TPM, ошибка 429, цены на токены и особенности доступа к api.openai.com из России.
Что такое OpenAI API и из чего он состоит
OpenAI API — это HTTP-интерфейс, который даёт программный доступ к моделям OpenAI через эндпоинты Chat Completions и Responses по секретному ключу. В отличие от готового веб-приложения ChatGPT, OpenAI API встраивается в собственный код: вы формируете запрос, получаете JSON и сами управляете логикой приложения. API ChatGPT и веб-интерфейс оплачиваются независимо друг от друга.
API против ChatGPT: в чём разница
ChatGPT — это готовый продукт OpenAI с подпиской, диалоговым интерфейсом и собственной инфраструктурой. API OpenAI — интерфейс для разработчиков: вы обращаетесь к тем же моделям, но из своего кода, платите только за потреблённые токены по схеме pay-as-you-go и не привязаны к UI.
Важно понимать, что подписка ChatGPT Plus не даёт никакого баланса API — это полностью отдельный продукт. Для работы с API нужен отдельный платёжный метод на platform.openai.com.
Основные эндпоинты и модели
Ключевые эндпоинты API OpenAI для разработчиков:
/v1/chat/completions— классический Chat Completions API для диалогов с моделью/v1/responses— новый Responses API с встроенными инструментами и хранением состояния/v1/embeddings— векторные представления текста/v1/images/generations— генерация изображений/v1/audio/transcriptions— транскрипция аудио/v1/moderations— проверка контента на соответствие политике
Актуальные флагманские модели — GPT-4o и GPT-4.1, а GPT-4o mini закрывает задачи, где важна скорость и низкая цена. Responses API — рекомендуемый современный интерфейс: в него встроены инструменты веб-поиска, поиска по файлам и интерпретатор кода, а состояние диалога можно хранить на стороне OpenAI.
Как модель считает работу: токены
Токен — базовая единица измерения в API OpenAI: несколько символов английского текста или меньше для русского языка (кириллица токенизируется менее эффективно). Цена запроса, лимиты и контекстное окно модели — всё измеряется в токенах.
Подсчитать токены заранее поможет библиотека tiktoken от OpenAI: она воспроизводит токенизацию конкретной модели и позволяет оценить стоимость до отправки запроса. Поле usage в ответе возвращает фактическое количество prompt_tokens и completion_tokens.
Как получить и защитить API-ключ
API-ключ создаётся в разделе API keys на platform.openai.com, начинается с sk-, показывается один раз и передаётся в заголовке Authorization: Bearer. Это единственный способ аутентификации: без корректного ключа любой запрос вернёт статус 401. Компания OpenAI выпустила публичный API в 2020 году, и с тех пор архитектура ключей практически не изменилась.
Пошагово: создание ключа
- Зарегистрируйтесь или войдите на platform.openai.com под своим аккаунтом.
- Подтвердите e-mail и, при необходимости, номер телефона — без этого аккаунт ограничен.
- Перейдите в раздел Billing → Add payment method, привяжите карту и пополните баланс.
- Откройте Dashboard → API keys → Create new secret key, выберите проект и нажмите «Create».
- Скопируйте ключ вида
sk-proj-...немедленно: повторно показать его невозможно.
Если ключ потерян — его удаляют кнопкой Revoke и создают новый. Ключ sk- показывается единственный раз при создании и не восстанавливается ни через UI, ни через API.
Организации, проекты и права ключей
Один аккаунт OpenAI может содержать несколько проектов, у каждого — собственный ключ, лимиты и бюджет. Проектные ключи (sk-proj-...) предпочтительнее устаревших пользовательских (sk-...): они изолируют расходы и права между разными приложениями или командами.
При работе с несколькими организациями или проектами в одном HTTP-запросе передаются заголовки OpenAI-Organization и OpenAI-Project — это позволяет явно указать, к какому проекту относится вызов и на чей баланс он спишется.
Хранение ключа и защита от утечки
Ключ нельзя коммитить в git, вставлять в клиентский JavaScript или публиковать в открытом доступе. Правильное хранение — переменная окружения OPENAI_API_KEY или секрет-менеджер (например, AWS Secrets Manager, HashiCorp Vault). Рекомендуется также выставить usage limit и бюджет проекта в панели, чтобы при утечке ущерб был ограничен.
Если ключ всё же утёк — немедленно нажмите Revoke в разделе API keys и создайте новый. Проверить, не используется ли скомпрометированный ключ, можно в разделе Usage.
Передача ключа в запросе
Ключ передаётся в HTTP-заголовке: Authorization: Bearer sk-proj-.... Пример с curl:
curl https://api.openai.com/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -d '{"model":"gpt-4o","messages":[{"role":"user","content":"Hello"}]}'
SDK Python и Node.js подставляют этот заголовок автоматически из переменной окружения — явно передавать его в коде не нужно.
Первый запрос: структура запроса и ответа
Первый запрос — это POST на /v1/chat/completions (или /v1/responses) с телом, где указаны model и messages, а ответ приходит в JSON с полем choices и usage. OpenAI API предоставляет доступ к моделям через оба эндпоинта: Chat Completions остаётся широко используемым, Responses — рекомендован для новых проектов.
Chat Completions: тело запроса
Минимальный запрос к Chat Completions содержит два поля: model (например, gpt-4o или gpt-4.1) и messages — массив объектов с ролями system, user и assistant. Дополнительные параметры — temperature (случайность ответа), max_tokens (лимит на выход), response_format (например, {"type": "json_object"}).
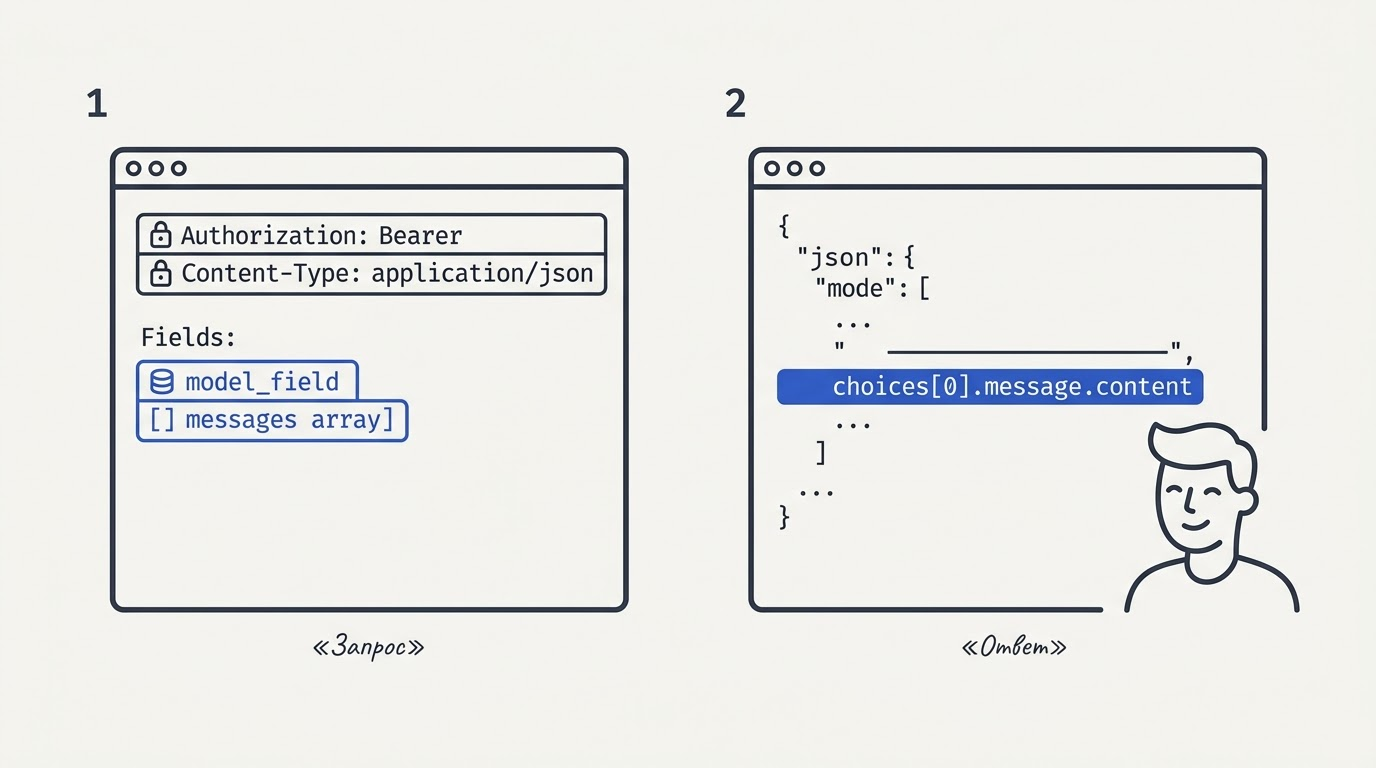
Ответ имеет следующую структуру:
choices[0].message.content— текст ответа моделиchoices[0].finish_reason— причина остановки (stop,length,tool_calls)usage.prompt_tokens— токены входаusage.completion_tokens— токены выходаusage.total_tokens— сумма
Поле usage критично для контроля расходов: именно оно показывает фактическую стоимость каждого вызова.
Responses API: чем отличается
Responses API использует поле input вместо messages и возвращает ответ в поле output. Главное отличие — встроенные инструменты: web_search_preview, file_search и code_interpreter доступны без дополнительных вызовов.
OpenAI рекомендует Responses для всех новых проектов, так как он проще управляет многоходовыми диалогами: состояние сессии можно хранить на стороне платформы, не передавая всю историю в каждом запросе.
Потоковая передача (streaming)
При stream: true ответ приходит фрагментами в формате Server-Sent Events (SSE): каждый чанк содержит дельту текста, что позволяет отображать ответ по мере генерации. В Python SDK используется контекстный менеджер client.chat.completions.stream() или параметр stream=True, в Node.js — аналогичный метод .stream(). Streaming удобен для чат-интерфейсов, где пользователь видит ответ немедленно, не ожидая полной генерации.
Вызов инструментов (function calling)
Function calling работает так: вы описываете функции в параметре tools через JSON Schema, модель возвращает намерение вызвать их в поле tool_calls, вы выполняете код и отправляете результат обратно. Функции для вызова инструментов описываются как объекты JSON Schema в параметре tools, а намерение модели вызвать функцию возвращается в поле tool_calls. Схожий механизм — tool use в Claude API — работает по той же идее, но с иным синтаксисом.
Как описать инструмент в tools
Каждый инструмент в массиве tools — объект вида {"type": "function", "function": {...}}. Обязательные поля функции:
name— уникальное имя функции (латиница, цифры, подчёркивание)description— подробное описание; именно от него зависит, когда модель решит вызвать инструментparameters— JSON Schema сproperties, типами полей и массивомrequired
Качество поля description напрямую влияет на поведение модели: чем точнее сформулировано назначение функции, тем реже возникают ложные вызовы или пропуски.
Полный цикл вызова
Цикл вызова инструмента состоит из пяти шагов. Первый — отправить запрос с заполненным массивом tools. Второй — модель возвращает tool_calls: массив с id, name и arguments (строка в формате JSON). Третий — распарсить arguments и выполнить свою функцию. Четвёртый — добавить в массив messages сообщение с role: "tool", tool_call_id и результатом выполнения. Пятый — повторный запрос к API: теперь модель формирует финальный ответ с учётом результата инструмента.
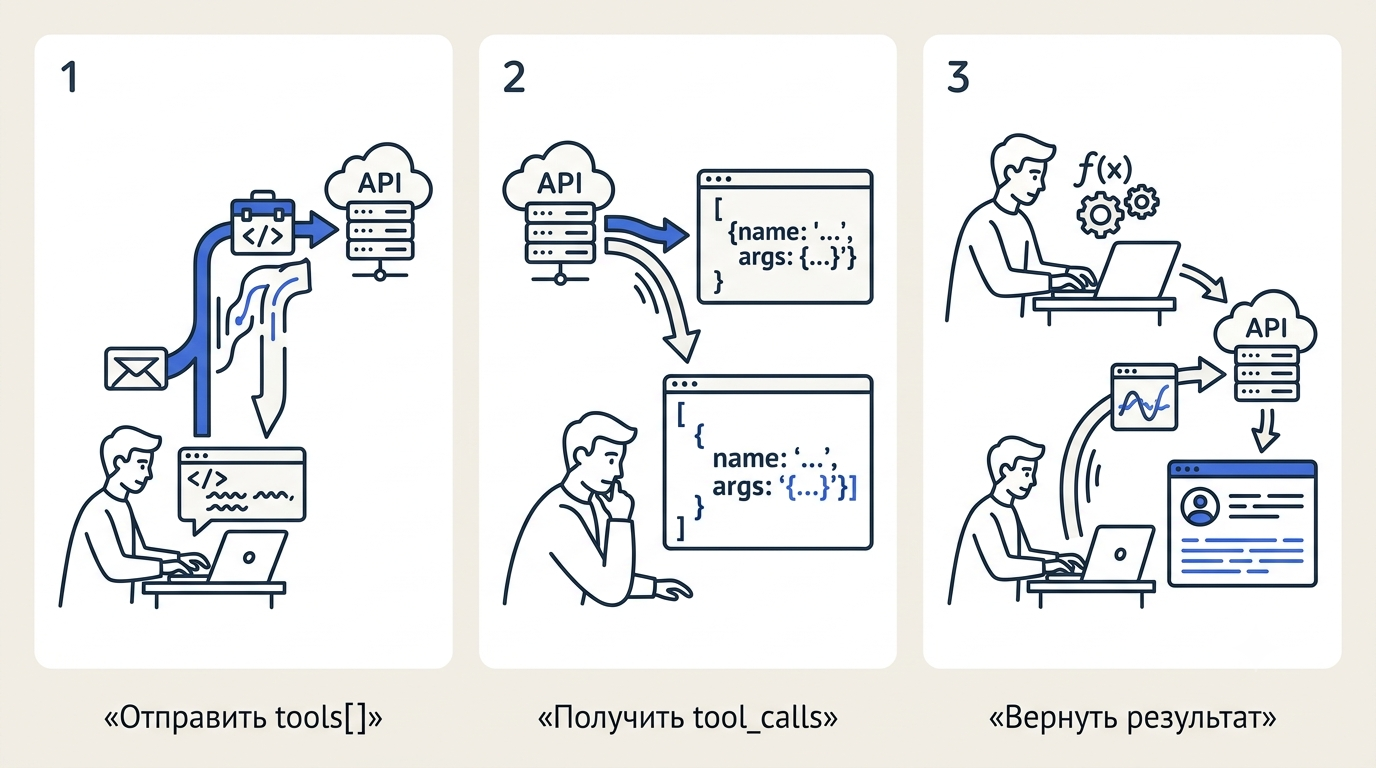
Важно сохранять tool_call_id точно: ошибка в идентификаторе приведёт к отказу.
Управление выбором: tool_choice
Параметр tool_choice управляет тем, как модель выбирает инструменты. Значение auto (по умолчанию) позволяет модели самой решить, вызывать ли функцию. required обязывает модель вызвать хотя бы один инструмент. none полностью отключает вызов. Можно также явно указать конкретную функцию: {"type": "function", "function": {"name": "get_weather"}}.
При нескольких инструментах в запросе модель по умолчанию может вернуть несколько tool_calls за один ответ — это поведение контролируется параметром parallel_tool_calls.
Structured Outputs и строгий JSON
Флаг strict: true в описании функции включает режим Structured Outputs: ответ модели гарантированно соответствует переданной JSON Schema. Это распространяется как на function calling, так и на поле response_format, что делает парсинг ответа надёжным — исключения JSONDecodeError из-за неверной структуры становятся невозможными.
Structured Outputs особенно полезны в production-пайплайнах: можно передавать Python-датакласс или TypeScript-интерфейс и получать типизированный объект без ручной валидации.
Кэширование промптов: как экономить на токенах
Кэширование промптов включается автоматически для запросов длиннее 1024 токенов, переиспользует совпадающий префикс и даёт скидку на кэшированные входные токены. Кэшированные токены тарифицируются со скидкой от стандартной цены входных токенов, а кэш промпта живёт и переиспользуется в течение нескольких минут неактивности. Понимание того, как работают токены и контекстное окно, помогает выстроить структуру промпта эффективно.
Когда включается и что кэшируется
Prompt caching срабатывает автоматически — никаких флагов включать не нужно — при условии, что длина промпта превышает минимальный порог. Кэшируется общий префикс: первая неизменная часть промпта, которую API идентифицирует как одинаковую в нескольких запросах подряд.
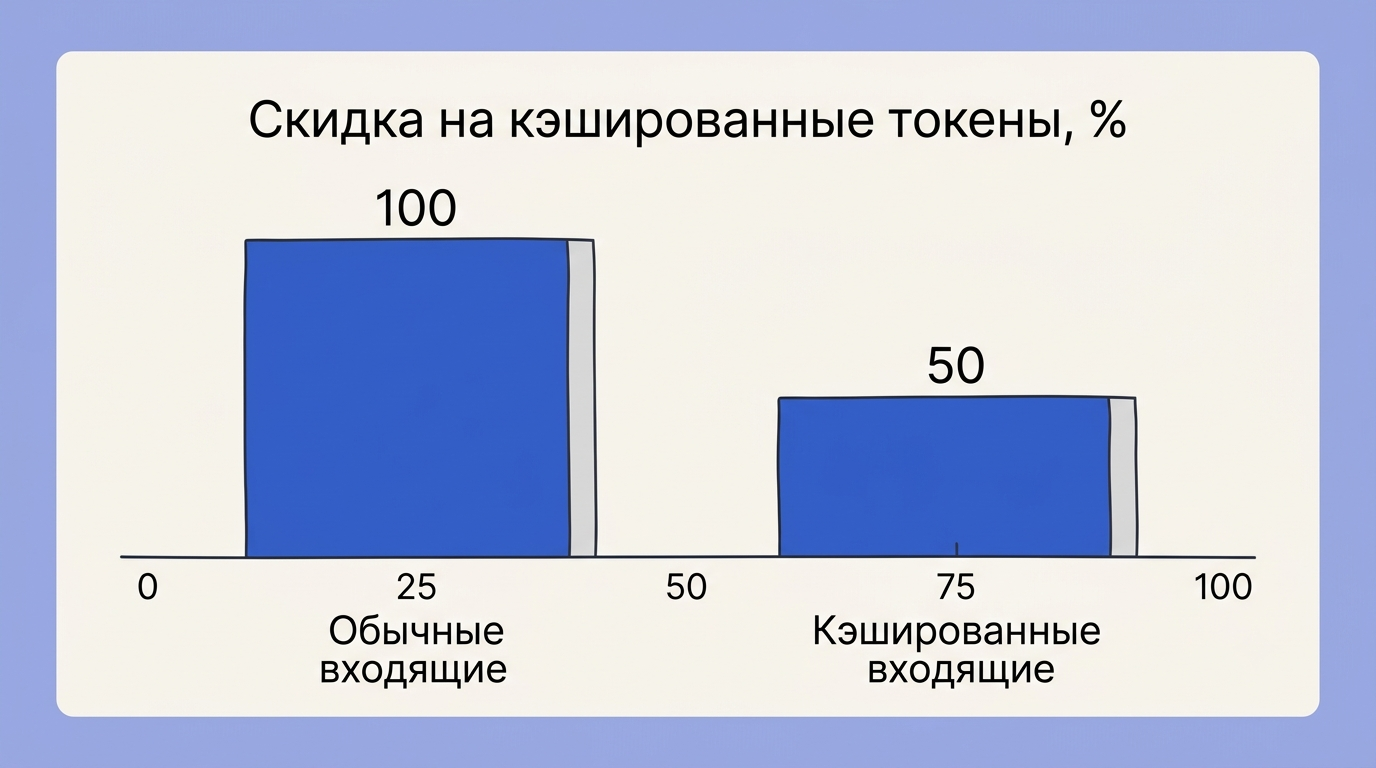
Отсюда ключевое архитектурное правило: стабильное содержимое (system-инструкции, RAG-контекст, документы) держите в начале промпта, а переменную часть (пользовательский запрос, данные конкретной сессии) — в конце. Если переменная часть появится в начале, кэш никогда не совпадёт.
Скидка, TTL и проверка попадания
| Параметр | Значение |
|---|---|
| Минимальный размер для кэширования | Несколько сотен токенов |
| TTL кэша при неактивности | Несколько минут |
| Скидка на кэшированные входные токены | Существенная скидка |
| Поле для проверки попадания | usage.prompt_tokens_details.cached_tokens |
Попадание в кэш отражается в поле usage.prompt_tokens_details.cached_tokens: ненулевое значение означает, что часть промпта пришла из кэша и тарифицирована со скидкой. Следить за этим полем полезно при оптимизации дорогостоящих повторяющихся запросов.
Как повысить долю попаданий
Доля cache hit зависит от того, насколько стабилен префикс между запросами. Практические рекомендации: фиксируйте порядок сообщений и не меняйте system-промпт от запроса к запросу; выносите общий контекст (документы, примеры, правила) в начало массива messages; группируйте однотипные запросы во времени — если следующий запрос с тем же префиксом придёт слишком поздно, кэш уже истечёт.
Ещё один практический приём — не добавлять в system-промпт динамические элементы вроде текущего времени или идентификатора сессии: они ломают совпадение префикса и делают кэш бесполезным. Переменные данные выносятся в user-сообщение в конце.
Официальные SDK: Python и Node.js
Официальные SDK ставятся командами pip install openai и npm install openai, а ключ по умолчанию берётся из переменной окружения OPENAI_API_KEY. Обе библиотеки распространяются под открытой лицензией и поддерживаются командой OpenAI — это рекомендуемый способ работы вместо ручного формирования HTTP-запросов.
Python: установка и запрос
После pip install openai клиент инициализируется одной строкой: from openai import OpenAI; client = OpenAI(). При отсутствии явного аргумента api_key библиотека читает OPENAI_API_KEY из окружения. Запрос к Chat Completions: client.chat.completions.create(model="gpt-4o", messages=[...]). Для Responses API — client.responses.create(model="gpt-4o", input="...").
Для асинхронного кода используется AsyncOpenAI с теми же сигнатурами методов: await client.chat.completions.create(...). Это важно для FastAPI, aiohttp и других async-фреймворков, где синхронный вызов блокировал бы event loop.
Node.js/TypeScript: установка и запрос
После npm install openai клиент инициализируется аналогично Python: import OpenAI from 'openai'; const client = new OpenAI(). Ключ читается из process.env.OPENAI_API_KEY. Сигнатуры методов почти идентичны Python-версии: client.chat.completions.create({model: "gpt-4o", messages: [...]}).
Библиотека официально поддерживает актуальные LTS-версии Node.js. TypeScript-типы включены в пакет — дополнительных @types/openai устанавливать не нужно. Поддерживается как CommonJS (require), так и ESM (import).
Настройка клиента: base_url, таймауты, ретраи
Клиент принимает дополнительные параметры: baseURL / base_url для прокси или совместимых шлюзов (Azure OpenAI, локальные модели), timeout в секундах и maxRetries / max_retries — по умолчанию SDK автоматически повторяет запрос при ошибках соединения, 408, 409, 429 и >=500 с коротким экспоненциальным backoff. Организацию и проект можно указать через параметры organization и project при создании клиента — это эквивалент HTTP-заголовков OpenAI-Organization и OpenAI-Project.
Лимиты, ошибка 429 и уровни доступа
Лимиты OpenAI API считаются по независимым измерениям RPM, TPM, RPD и TPD, превышение любого возвращает ошибку 429, а уровни доступа определяются суммой оплаченных расходов. Превышение RPM или TPM приводит к ответу HTTP 429 Too Many Requests, причём каждое измерение отслеживается отдельно: достаточно упереться в одно из них, чтобы получить ошибку. Уровень доступа (tier) определяется суммой потраченных на API средств и растёт по мере накопления истории платежей.
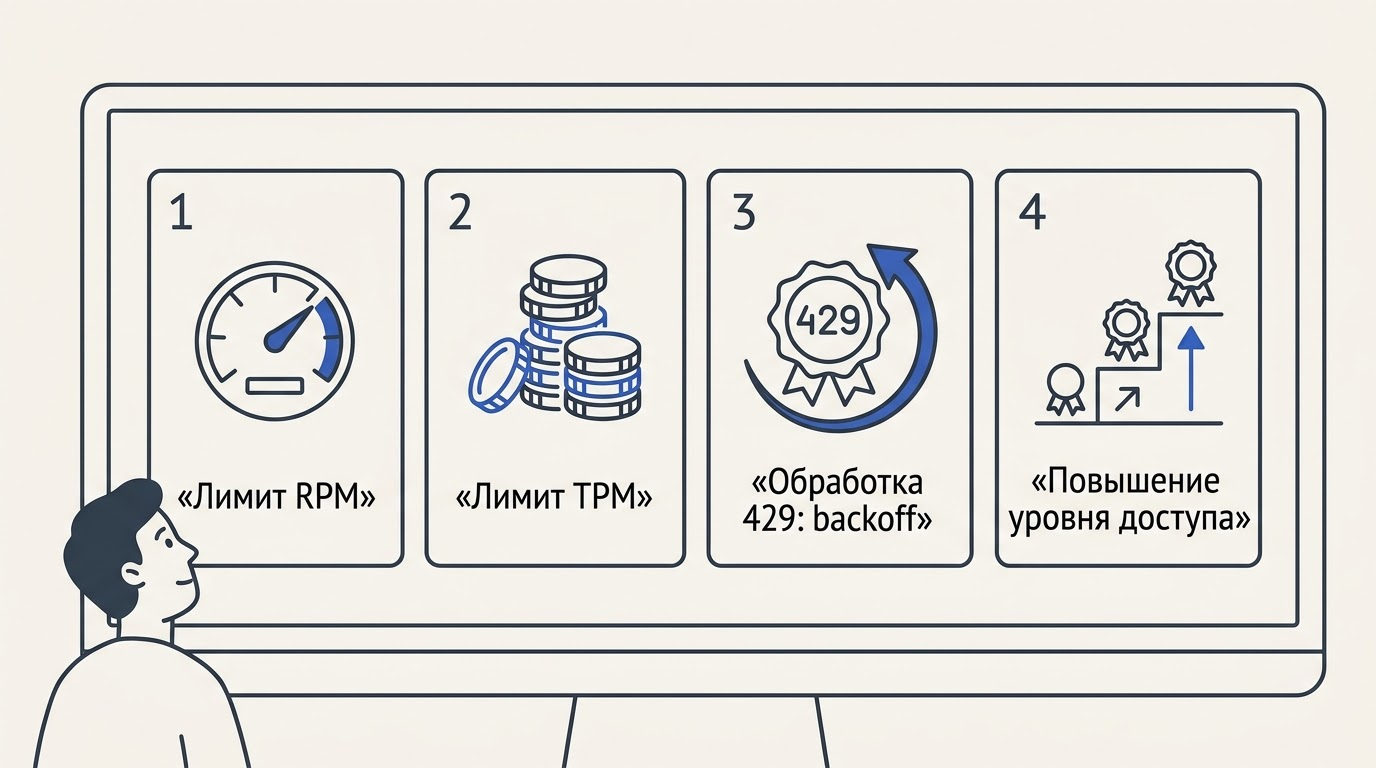
RPM (requests per minute) ограничивает частоту вызовов, TPM (tokens per minute) — суммарный поток токенов на вход и выход. RPD и TPD — суточные аналоги. В production-нагрузке узким местом чаще всего становится TPM: при работе с длинными контекстами его лимит достигается значительно быстрее, чем RPM.
Уровни доступа растут с накоплением расходов: начальный уровень открывается после первого платежа, следующие — по мере роста потраченных средств. Чем выше tier, тем выше RPM и TPM для каждой модели.
| Tier | Условие | Пример TPM для GPT-4o |
|---|---|---|
| Tier 1 | Первый платёж | 30 000 |
| Tier 2 | ~$50 потрачено | 450 000 |
| Tier 3 | ~$100 потрачено | 800 000 |
| Tier 4 | ~$250 потрачено | 2 000 000 |
| Tier 5 | ~$1 000 потрачено | 30 000 000 |
При получении ошибки 429 правильная стратегия — читать заголовки ответа: retry-after указывает, сколько секунд ждать, x-ratelimit-remaining-requests и x-ratelimit-remaining-tokens показывают остаток лимита. SDK OpenAI реализует экспоненциальный backoff с джиттером автоматически: при max_retries > 0 повторные попытки происходят без дополнительного кода.
Помимо 429, стоит обработать: 401 (неверный или отсутствующий ключ), 400 (ошибка в теле запроса — чаще всего неверная схема tools или несуществующая модель), 503 (временная недоступность) и 402 (закончился баланс — технически тоже возвращает 429 с кодом billing_hard_limit_reached). Балансировка нагрузки между несколькими ключами или проектами помогает избежать лимитов при высоких нагрузках.
Стоимость, оптимизация и доступ из России
Стоимость OpenAI API считается по токенам отдельно за вход и выход, оплачивается по факту с баланса, а из России доступ требует зарубежной карты и часто альтернативного base_url совместимого шлюза. Кэшированные входные токены тарифицируются со значительной скидкой от цены стандартных входных токенов — это главный рычаг экономии при повторяющихся длинных промптах.
Цена GPT-4o mini в разы ниже флагмана. Тарификация указывается за 1 млн токенов отдельно для input и output; у mini-моделей и output дешевле, и скидка за кэшированный вход сохраняется. Для простых задач — классификации, резюмирования коротких текстов, форматирования — использование mini-модели существенно снижает затраты без заметной потери качества. Batch API даёт дополнительную скидку при асинхронной обработке массовых запросов: файл с задачами обрабатывается в течение суток со значительной скидкой от стандартной цены.
OpenAI официально не обслуживает Россию. Пополнение баланса через российские карты Visa/Mastercard заблокировано, API-запросы с российских IP могут проходить, но стабильность не гарантирована. Доступ к моделям можно получить через шлюз совместимого провайдера с российскими методами оплаты и собственным base_url. Параметр base_url в SDK позволяет перенаправить трафик на любой OpenAI-совместимый эндпоинт. Подробнее о доступных способах написано в материале об оплате доступа из России.
Лимиты трат легко контролировать из панели. Выставьте hard limit (жёсткое ограничение) и soft limit (уведомление по e-mail) в разделе Billing → Usage limits, а бюджет каждого проекта — в настройках проекта. Дашборд Usage показывает расходы по моделям и эндпоинтам в реальном времени. Начинать нагрузочное тестирование рекомендуется на gpt-4o-mini, чтобы случайный цикл не съел значительную сумму на флагманской модели.
FAQ
Чем OpenAI API отличается от ChatGPT?
ChatGPT — готовый интерфейс для общения, а OpenAI API — программный доступ к тем же моделям, который разработчики встраивают в собственные приложения. API даёт полный контроль над параметрами запроса, тогда как ChatGPT управляет ими автоматически.
Можно ли восстановить потерянный API-ключ?
Нет, секретный ключ показывается только один раз при создании. Если ключ потерян, его нужно отозвать и создать новый в личном кабинете.
Куда передавать API-ключ в запросе?
Ключ передаётся в HTTP-заголовке Authorization: Bearer OPENAI_API_KEY. Сам ключ начинается с sk-; хранить его следует в переменных окружения, а не в коде.
От какого размера промпта работает кэширование и какая скидка?
Кэширование включается автоматически для запросов длиннее 1024 токенов и переиспользует совпадающий префикс промпта. Кэшированные входные токены тарифицируются со скидкой.
Сколько живёт кэш промпта и как понять, что он сработал?
Кэшированный префикс остаётся доступным несколько минут неактивности. О попадании в кэш сигнализирует поле cached_tokens в объекте usage ответа.
Как получить строго структурированный JSON-ответ от модели?
Используйте Structured Outputs: передайте JSON Schema в параметр response_format с типом json_schema. Модель гарантированно вернёт ответ, соответствующий заданной схеме.
Почему приходит ошибка 429 и как её обрабатывать?
Ошибка 429 означает превышение лимитов RPM, TPM, RPD или TPD. Рекомендуется добавить экспоненциальный повтор запроса с задержкой или повысить уровень доступа, оплатив достаточную сумму.
Как оплатить и пользоваться OpenAI API из России?
Российские карты OpenAI не принимает. Технических ограничений на запросы по IP нет, но оплата требует зарубежного платёжного инструмента.
-
Маршрут от Claude привёл подростка на «Вдоводел»
![Подросток в синей куртке и шлеме радостно смотрит маршрут в телефоне на вершине горы над городом]()
16-летний Брайс из Ванкувера проложил с Claude новый для себя маршрут на гору Краун. ![Подросток с рюкзаком неуверенно пробирается между валунами к крутому гребню]()
Разметки не было: вместо кулуара он попал на гребень «Вдоводел», куда ходят с верёвками. ![Испуганный подросток прижался к отвесной скале на узком уступе и звонит по телефону]()
Брайс застрял на уступе шириной около полутора метров: сзади обрыв, впереди почти отвесная стена. ![Спасатель спускается по верёвке к подростку на уступе, рядом вертолёт]()
Вертолёт не мог подойти к скале: спасатель спустился к Брайсу по верёвке, и его подняли на борт. ![Подросток в спасательном одеяле сидит у тропы с бумажной картой, рядом компас]()
Брайс винит себя, но тропы через ИИ больше не прокладывает. Спасатель: «Claude никогда не был в этих местах». -
950 агентов Claude нашли в ДНК вирусов загадочную систему
![Учёная в лаборатории смотрит на монитор со спиралями ДНК]()
Anthropic поручила Claude найти в огромной базе ДНК необычные ферменты. ![Учёная с планшетом смотрит на стену из сотен мониторов с ДНК]()
Около 950 агентов за 21 час собрали больше 200 тысяч ферментов и написали 20 отчётов. ![Учёная взволнованно показывает на повторяющийся узор в цепочке ДНК на экране]()
Один агент «на глаз» заметил рядом с ферментом повторы, как у CRISPR. Систему назвали ART. ![Учёная поднимает пробирку к свету, коллега задумчиво смотрит рядом]()
Что она делает, пока неизвестно. Пионер CRISPR Фэн Чжан назвал находку «по-настоящему интригующей». -
Anthropic запретила издеваться над Claude
![Женщина в очках сердито кричит на ноутбук и стучит кулаком по столу]()
Anthropic запретила «длительное и бессмысленное» жестокое обращение с Claude. ![Женщина спокойно спорит, разводя рукой перед ноутбуком]()
Речь о крайних случаях. Раздражение, споры, мрачные сюжеты и тесты под запрет не попадают. ![Удивлённая женщина смотрит на ноутбук со значком закрытой двери на экране]()
Главная защита прежняя: Claude сам завершает такой диалог. ![Женщина прикрепляет к доске календарь с обведённым днём]()
Правила действуют с 12 ноября. За нарушения доступ могут ограничить или закрыть. -
ИИ-видео с погибшим в суде: срок назначат заново
![Женщина в зале суда показывает планшет с лицом мужчины]()
В Аризоне сестра погибшего показала в суде видео, где ИИ-аватар брата прощает убийцу. ![Растроганный судья с рукой на груди за судейским столом]()
Судья дал максимальные 10,5 года и сказал, что ему «понравилось это видео». ![Три судьи апелляционного суда изучают документы]()
Апелляционный суд счёл приговор несправедливым: видео «не отражает реальных событий». ![Женщина читает своё заявление с листов за трибуной, планшет выключен]()
Срок назначат заново, а свой текст сестра прочитает сама, без видео. -
Журналист выпустил ИИ-песню от имени чужой группы
![Журналист в наушниках с хитрой улыбкой работает за ноутбуком]()
Журналист 404 Media сгенерировал песню в Udio по простому запросу. ![Трое музыкантов панк-группы в шоке смотрят в телефон]()
Трек вышел на подтверждённой странице панк-группы Lathe of Heaven в Spotify без ведома музыкантов. ![Журналист удивлённо разводит руками, вокруг висят значки музыкальных сервисов]()
Песня попала и в Apple Music, Tidal и Amazon Music — через давнюю лазейку в дистрибуции. ![Довольный мошенник ловит монеты, сыплющиеся из наушников, слушательница расстроена]()
Так мошенники зарабатывают на чужой славе. Площадки и дистрибьюторы ответственность не берут. -
Нейросеть научилась играть в «Точки» и обыгрывает автора
![Разработчик держит тетрадь в клетку с партией в точки]()
Разработчик учил нейросеть игре в «Точки» из школьной тетради — по примеру AlphaZero. ![Разработчик ночью смотрит на два монитора с партиями в точки]()
Сеть играла сама с собой: 30 поколений за полтора месяца, однажды девять пришлось выбросить. ![Разработчик радостно подпрыгивает перед монитором с выигранной партией]()
Ученик обыграл учителя, только когда поиск подняли с 800 до 1600 симуляций на ход. ![Разработчик смеётся, проиграв нейросети партию в точки]()
Теперь сложный уровень игры Just Dots стабильно обыгрывает автора на поле 20×20.
























