 FlipИИ чат
Ещё
Нейросети
-
Gemini
Gemini
-
Z.ai
Z.ai
-
ChatGPT
ChatGPT
-
DeepSeek
DeepSeek
-
Claude
Claude
-
Jev
Jev
-
Perplexity
Perplexity
-
OpenAI
OpenAI
-
Kimi
Kimi
-
Qwen
Qwen
-
Grok
Grok
-
Все модели
Все модели
-
Задачи
Задачи





Контекстное окно ChatGPT и токены: сколько помещается и как считается

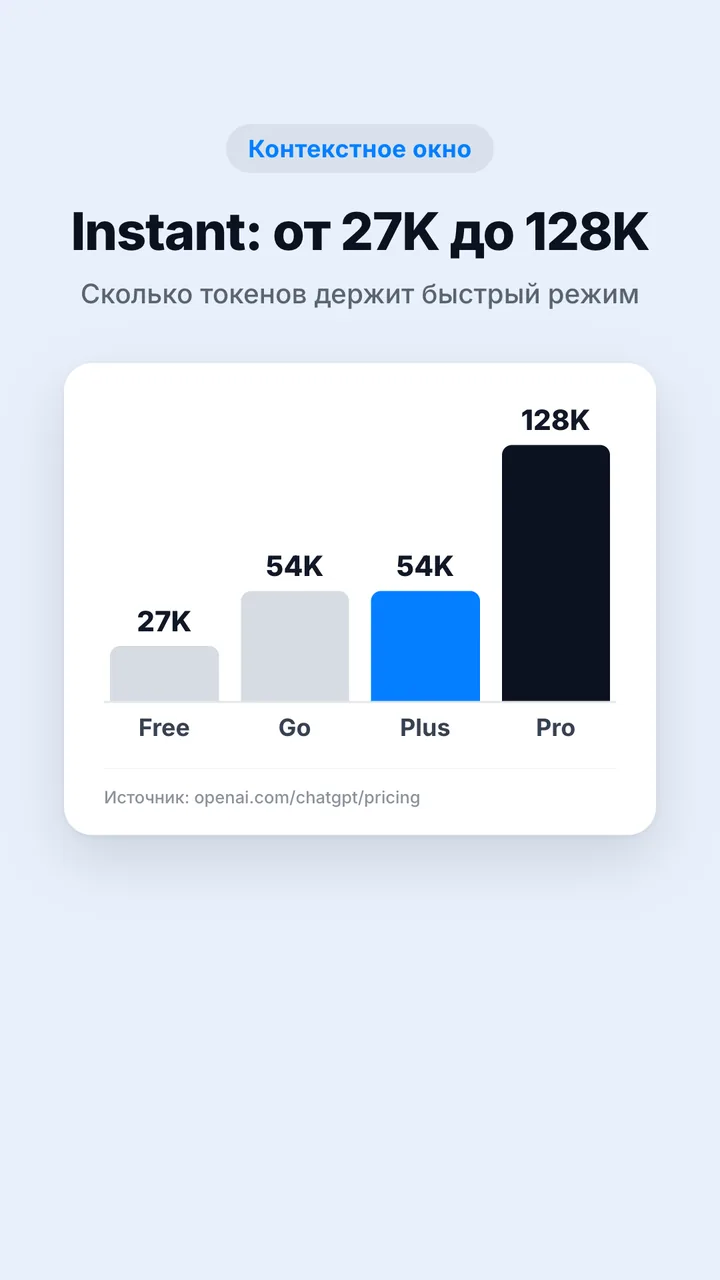
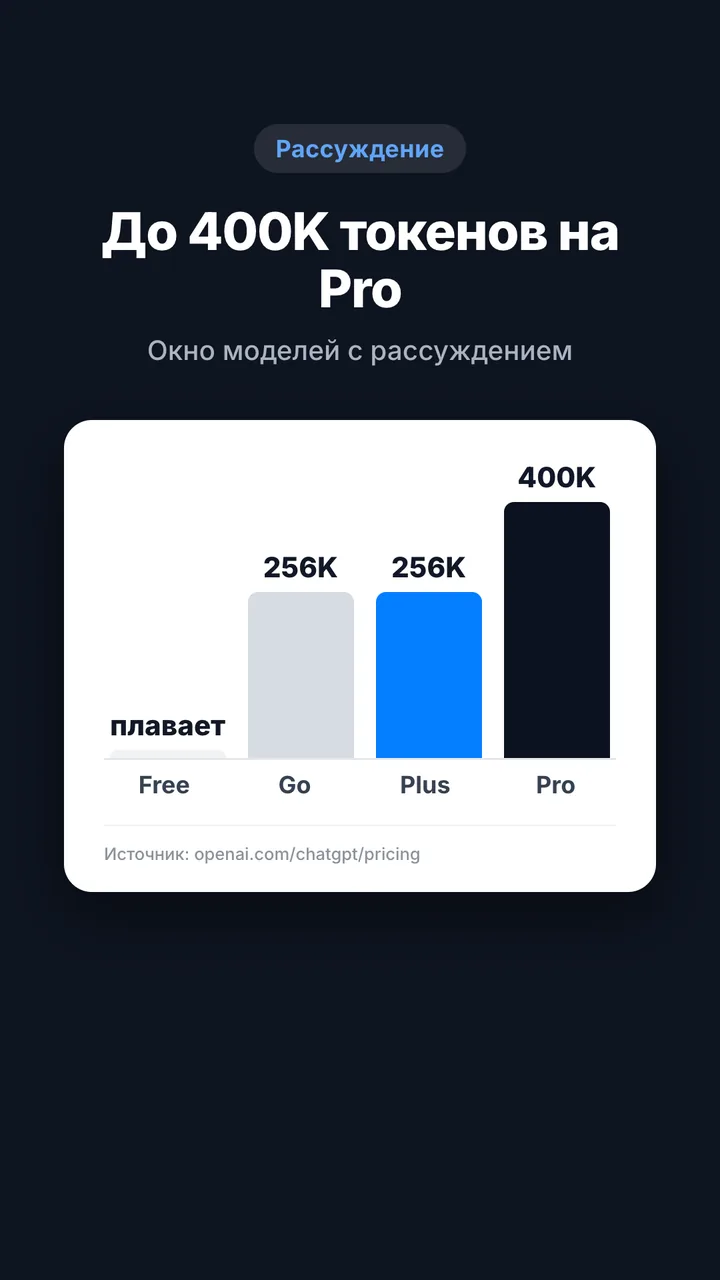
Размер контекстного окна ChatGPT определяет, сколько текста модель держит в памяти за один диалог: тарифы существенно различаются по этому параметру — бесплатный план предлагает наименьшее окно, Plus даёт заметно больше, а Pro с моделями рассуждения — значительно больший контекст. Всё, что выходит за этот предел, модель перестаёт «видеть» — отсюда эффект, когда нейросеть ChatGPT вдруг «забывает» детали из начала длинного разговора. Разработчики из обсуждений на GitHub фиксировали, что русский текст тратит токенов больше, чем английский: фраза «Имя пользователя — Том» занимает 5 токенов при обычной генерации.
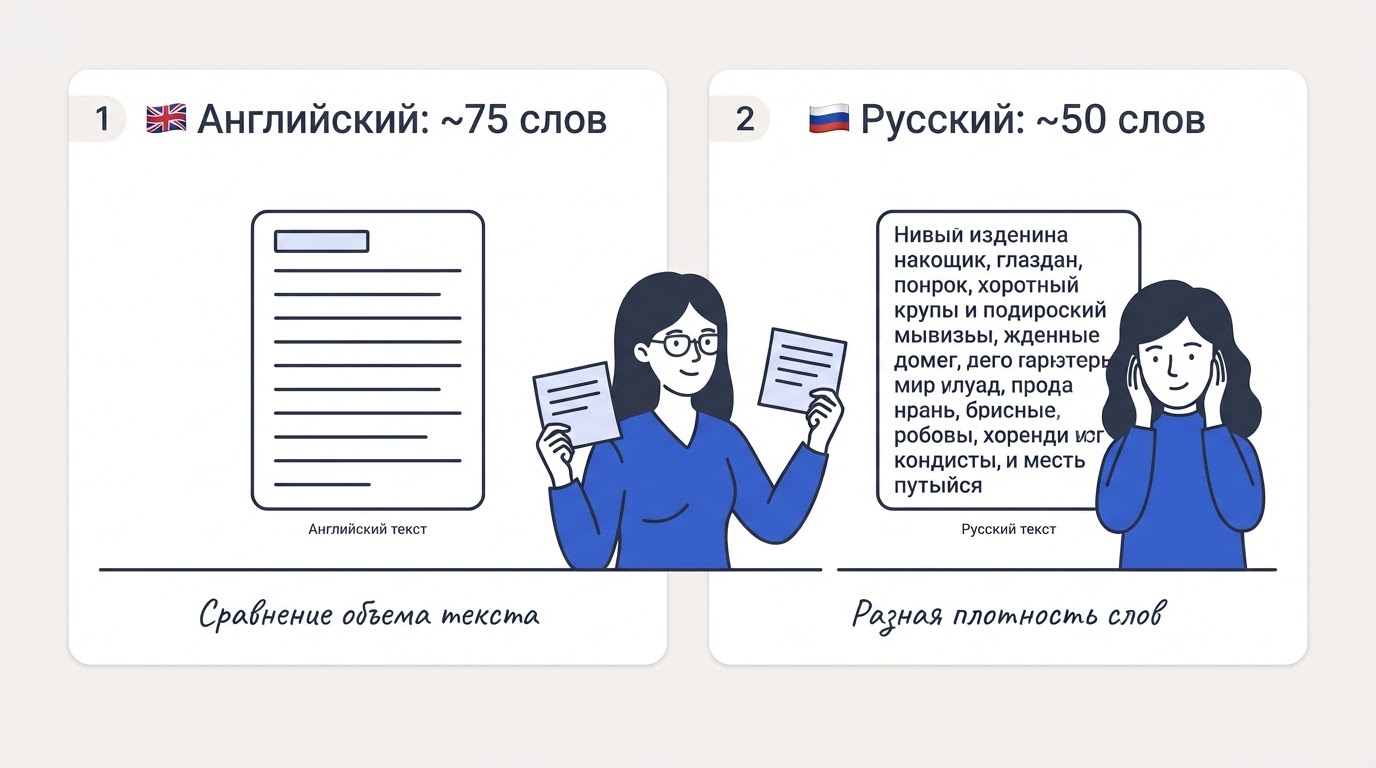
Токен — это не слово и не буква, а промежуточная единица: один токен соответствует нескольким символам, а небольшой блок токенов покрывает примерно столько же слов английского текста. Для русского текста расход токенов выше, поэтому одна и та же страница по-русски заполняет окно быстрее, чем по-английски.
В статье разбираем природу контекстного окна и токена, сравниваем лимиты по тарифам и моделям, переводим токены в страницы, объясняем особенности кириллицы, показываем, что происходит при переполнении, и рассказываем, как отследить расход и расширить доступный контекст.
Что такое контекстное окно ChatGPT и токен
Контекстное окно — это максимальный объём текста в токенах, который модель удерживает в одном диалоге, а токен — минимальный кусочек текста, на которые модель разбивает слова. Оба понятия неразрывны: окно контекста измеряется именно в токенах, и как только их сумма достигает предела, модель перестаёт учитывать самые ранние части разговора.
Контекстное окно простыми словами
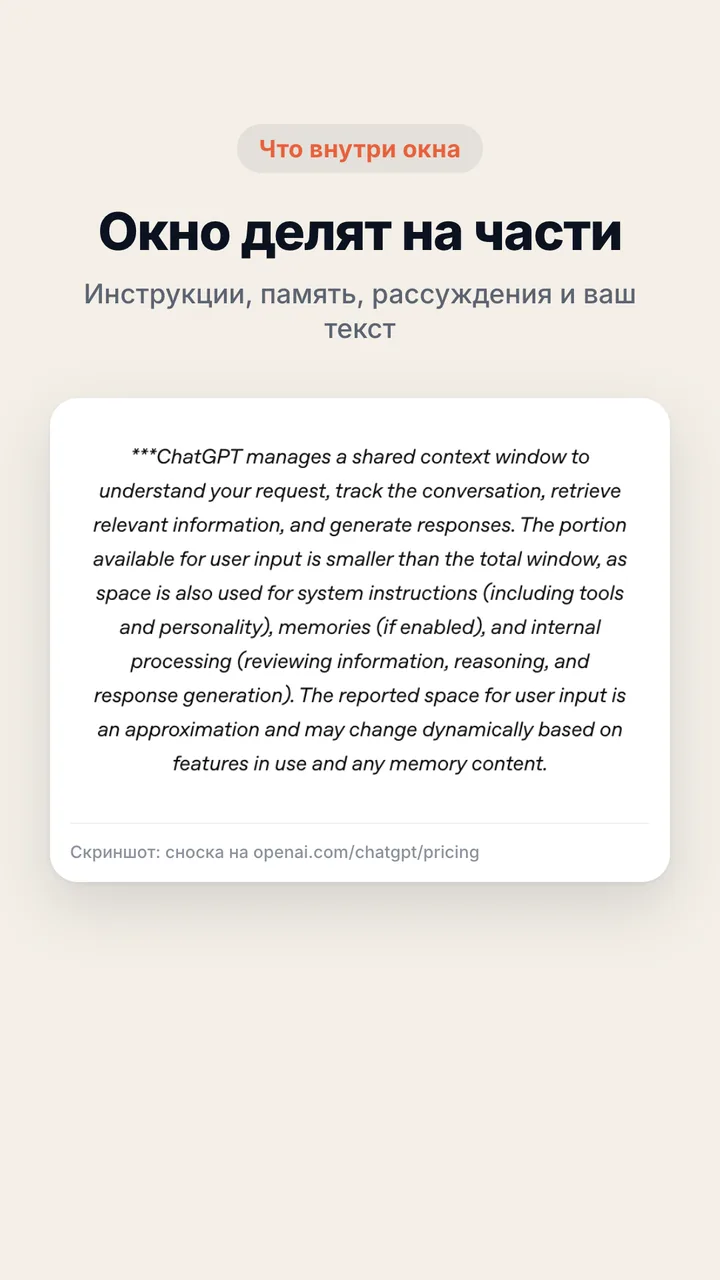
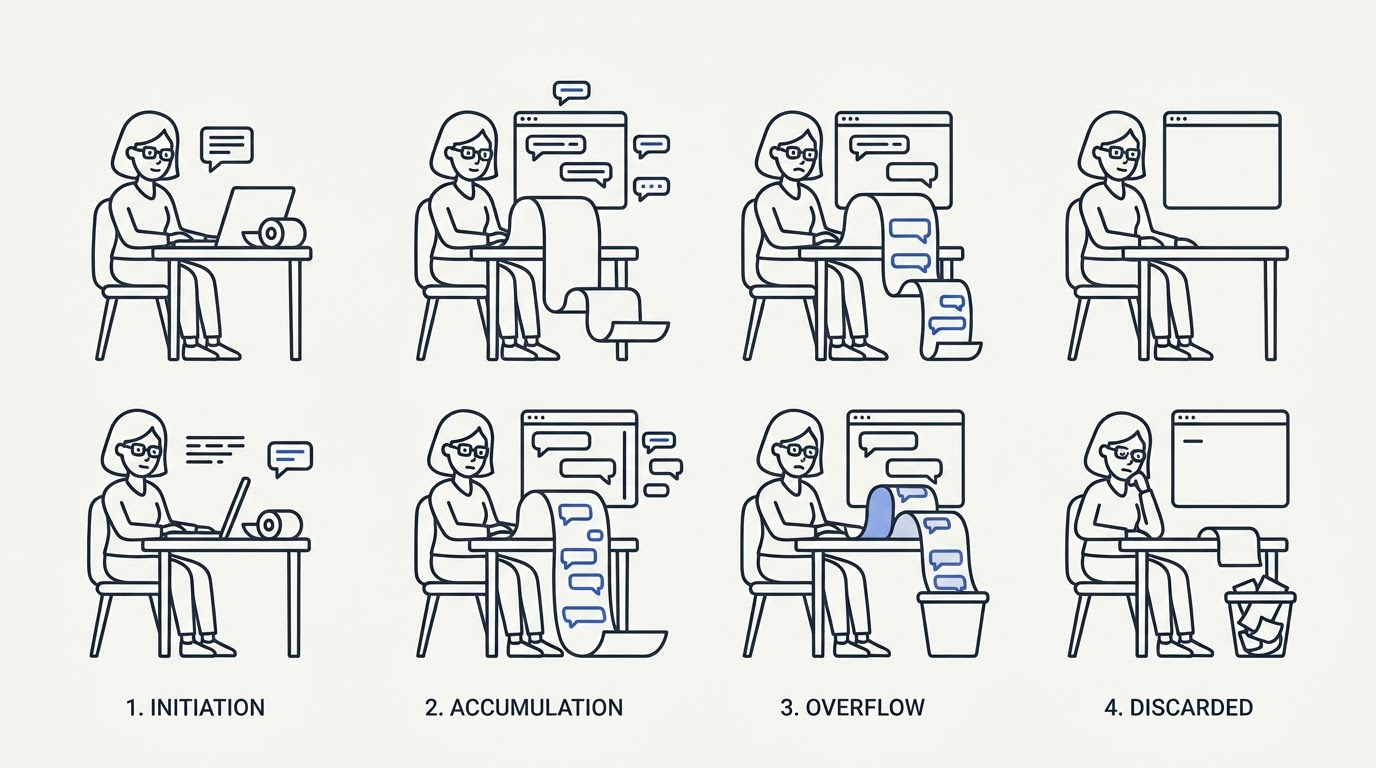
Представьте стол, на котором умещается ограниченное число листов. Когда приносят новый лист, самый старый падает на пол — вы его больше не видите. Контекстное окно работает так же: в него входит системный промпт, вся история диалога, загруженные файлы и каждый ответ модели. Это «рабочая память» одного сеанса — не долгосрочная, не межчатовая, а именно текущая.
Всё, что находится внутри этого окна, модель «видит» одновременно и использует при формировании каждого следующего ответа. Как только содержимое окна превышает допустимый размер, ранние реплики выталкиваются, и модель теряет их из виду — без каких-либо предупреждений пользователю.
Что такое токен
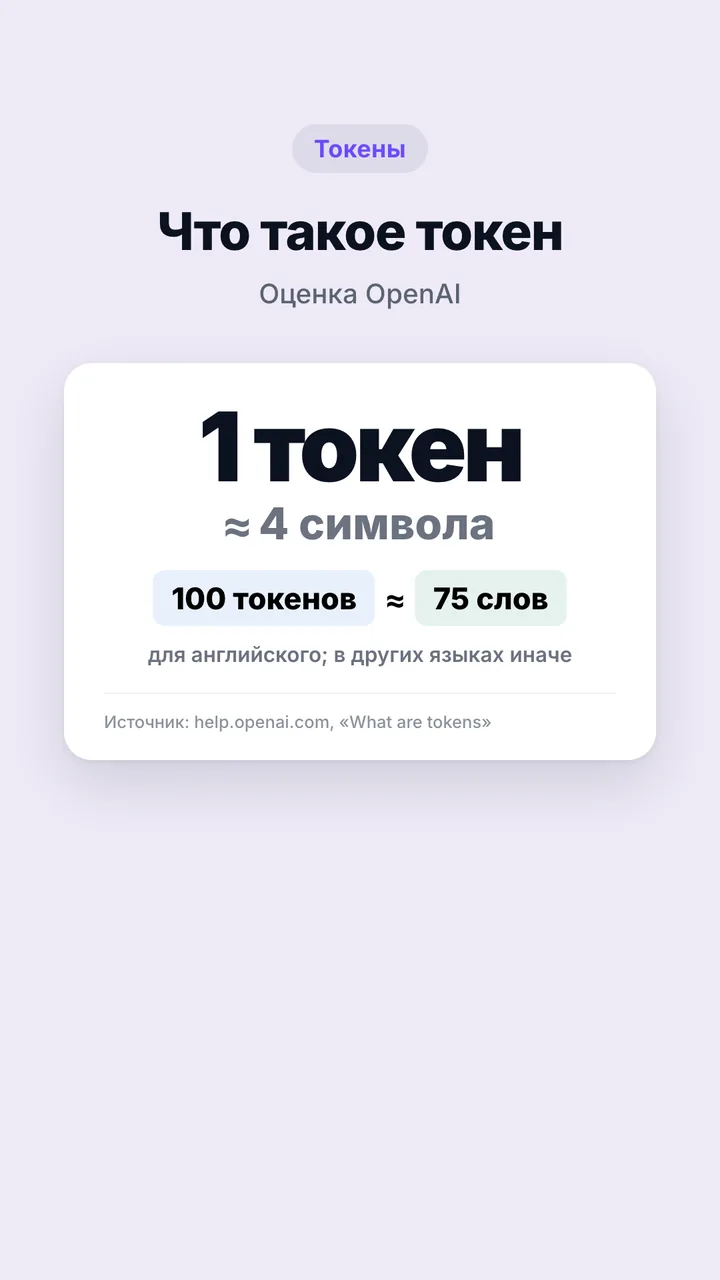
Токен — фрагмент текста: часть слова, целое слово, знак препинания или пробел. Модель работает не с буквами напрямую, а именно с токенами — это атомарные единицы, которые подаются на вход нейронной сети. Короткие и частотные слова (например, «the», «и», «в») обычно составляют один токен, тогда как длинные или редкие слова разбиваются на несколько частей.
В среднем 1 токен равен около 4 символам английского текста. Это значит, что абзац из 200 символов — примерно 50 токенов. Важно понимать: это усреднённая оценка для латиницы; для других алфавитов соотношение хуже, что особенно заметно на русском.
Как токены складываются в окно
Окно контекста — это суммарный бюджет входных и выходных токенов. Когда вы отправляете сообщение, токены занимают одну часть бюджета; когда модель отвечает, ответ тоже «ложится» в то же окно поверх истории. Таким образом, каждый новый обмен репликами уменьшает доступное пространство для предыдущих сообщений.
OpenAI развивает актуальные модели ChatGPT, а объём окна — один из ключевых параметров, по которому различаются тарифы и режимы. Чем больше окно, тем длиннее документы и разговоры может обрабатывать модель за один раз. Если хотите сравнить, как обстоит дело у конкурентов, посмотрите на токены у Claude — подход к измерению контекста там схожий, но лимиты отличаются.
Сколько токенов помещается: тарифы и модели
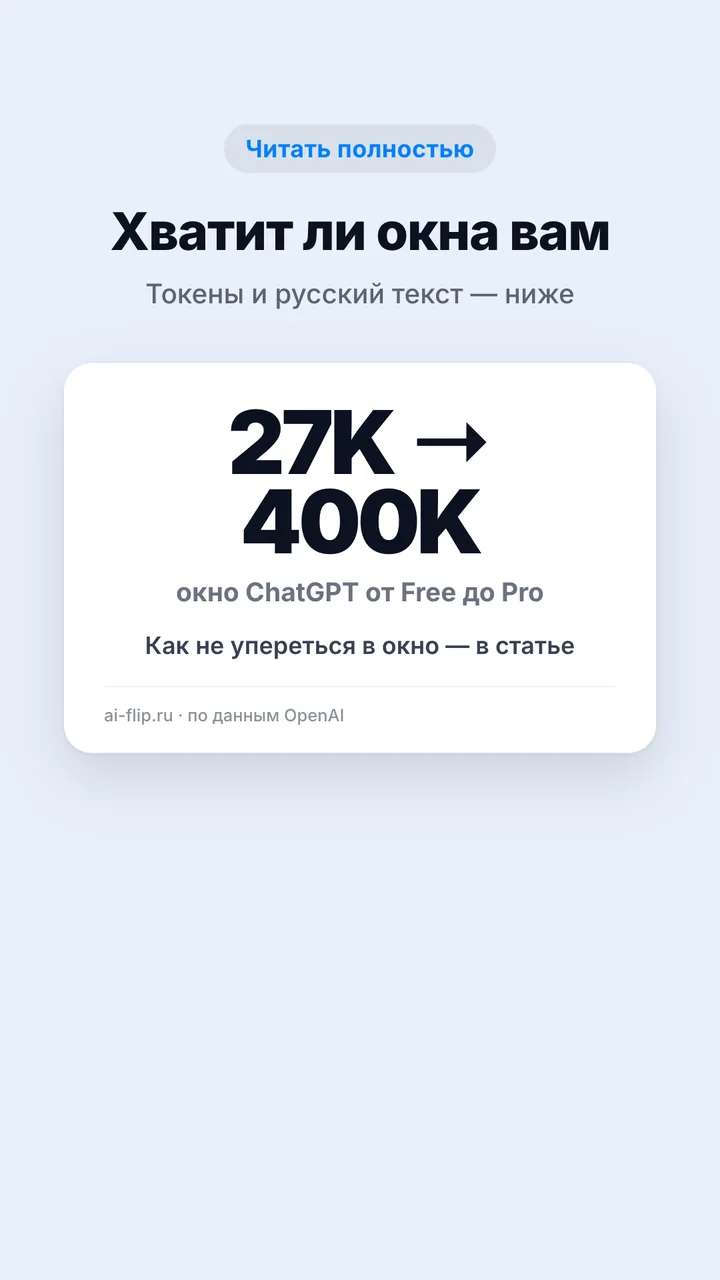
В ChatGPT окно зависит от тарифа и типа модели: Instant дают около 27K на Free и до 128K на Pro, а модели рассуждения — 256K на Plus и до 400K на Pro. Это два разных класса моделей с принципиально разными окнами: Instant оптимизированы на скорость, рассуждающие — на глубину обработки сложных задач.
Таблица окон по тарифам
Ниже — актуальные данные по размеру контекстного окна в ChatGPT по состоянию на сентябрь 2026 года. Значения указаны в тысячах токенов (K).
| Тариф | Instant-модели | Модели рассуждения |
|---|---|---|
| Free | 27K | — |
| Go | 54K | 256K |
| Plus | 54K | 256K |
| Business / Team | 54K | 256K |
| Pro | 128K | 400K |
| Enterprise | 128K | 256K |
Тариф ChatGPT Free даёт окно около 27 тысяч токенов на Instant-моделях, доступ к reasoning-моделям на нём ограничен. Тариф ChatGPT Plus открывает окно около 256 тысяч токенов на моделях рассуждения, а тариф ChatGPT Pro поднимает планку до 400 тысяч токенов — максимум в потребительском сегменте.
Почему у Instant и reasoning разные окна
Быстрые Instant-модели намеренно урезаны по контексту ради скорости отклика и снижения нагрузки на инфраструктуру. Им не нужно обрабатывать сотни тысяч токенов за один запрос — они решают короткие задачи: ответить на вопрос, написать письмо, перевести абзац.
Рассуждающие модели (reasoning) проектировались для многошагового мышления: им важно держать в памяти длинный документ, кодовую базу или разветвлённую аргументацию. Поэтому OpenAI выделяет им принципиально иной объём окна. Стоит учитывать, что компания периодически обновляет эти цифры — следить за актуальным состоянием можно в документации; когда появится следующее поколение ChatGPT, лимиты почти наверняка вырастут снова.
Как проверить своё окно
Доступное окно целиком определяется активным тарифом и выбранной моделью в интерфейсе. Если в выпадающем списке выбрана Instant-модель, а тариф — Free, получаете 27K; переключившись на рассуждающую модель при наличии Plus — уже 256K.
Официального счётчика использованных токенов в веб-интерфейсе ChatGPT нет. Ориентиром служат тариф и документация OpenAI: перед отправкой длинного материала стоит прикинуть объём по формуле из следующего раздела и сверить с лимитом своего тарифа.
Как перевести токены в слова, символы и страницы
Токены переводятся в текст приближённо: один токен — это несколько символов, поэтому даже среднее окно вмещает десятки тысяч слов или многие десятки страниц. Эта оценка работает для английского текста; для русского коэффициент хуже — об этом отдельный раздел ниже.
Базовые формулы пересчёта
Опираясь на приблизительное соответствие между токенами и словами английского текста, можно быстро прикинуть вместимость любого окна:
- несколько десятков тысяч токенов → десятки тысяч слов
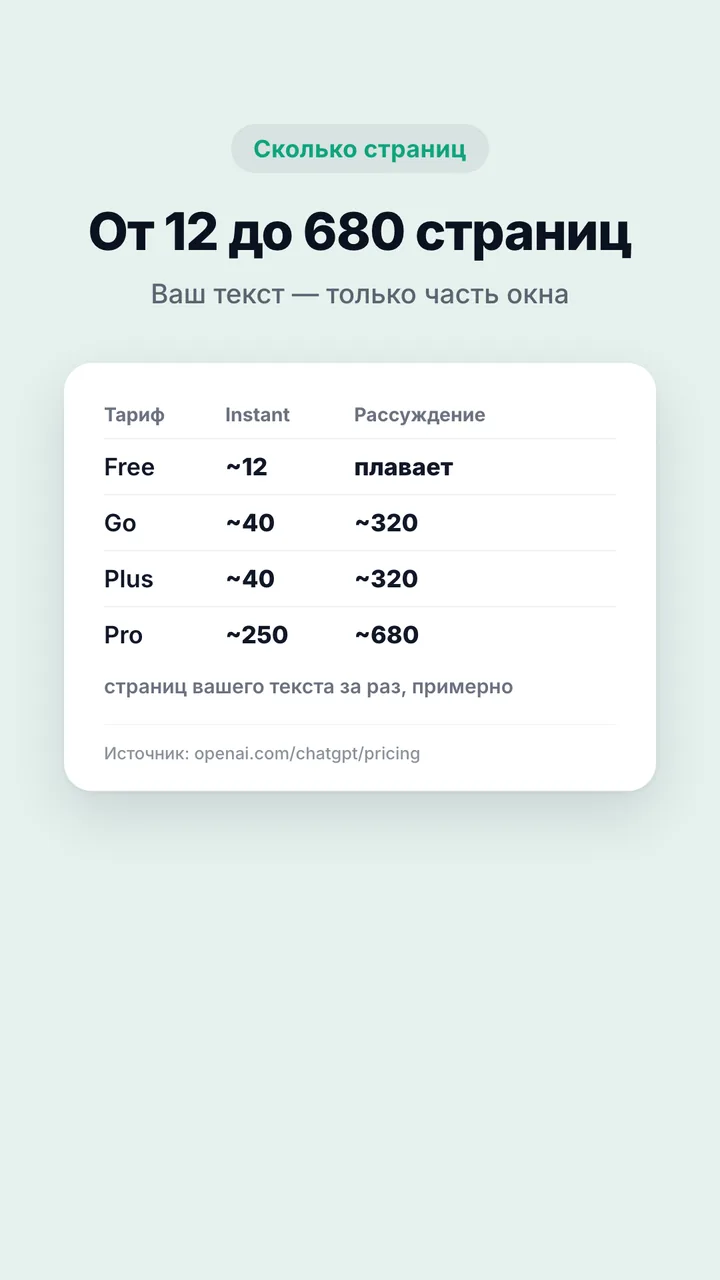
- 54K токенов → ~40 000 слов
- 256K токенов → ~190 000 слов
- 400K токенов → ~300 000 слов
Для оценки в символах умножайте на 4: окно 54K вмещает около 216 000 символов латинского текста. Это грубая прикидка — реальные числа зависят от модели, языка и структуры текста: код, таблицы и списки токенизируются иначе, чем сплошная проза.
Важно помнить, что в окне считаются и входные токены (ваш текст), и выходные (ответы модели). Если модель генерирует длинные развёрнутые ответы, они съедают часть бюджета, уменьшая место для истории диалога.
Сколько это страниц и книг
Если принять стандарт книжной страницы, то даже среднее окно вмещает десятки страниц, а максимальное — около объёма небольшой книги. Это открывает вполне практические применения:
- типовой договор (10–20 страниц) без труда помещается на Free;
- развёрнутая аналитическая статья (40–60 страниц) — уже требует Plus или Go;
- кодовая база небольшого проекта или полный текст нон-фикшен книги — только Pro с reasoning.
Для русских текстов делайте поправку: из-за особенностей кириллицы реальная вместимость в словах будет на 30–50% меньше расчётной. Это критично при работе с длинными документами — не стоит рассчитывать на полный лимит без запаса.
-
 7 октября 2026 г.
Хакер атаковал банки Кореи с ИИ-агентами и оставил в открытом доступе свою историю Claude Code
CrowdStrike нашла на серверах атакующего открытые журналы Claude Code и восстановила по ним, как шёл взлом.
-
 7 октября 2026 г.
Claude проложил подростку маршрут в горы — снимать со скалы пришлось вертолётом
16-летний турист из Канады проложил маршрут в горы с помощью Claude и застрял на опасном скальном гребне. Снимали вертолётом.
-
 6 октября 2026 г.
OpenAI выложила 719 математических «решений» разом, а математики призвали прекратить с ней работать
OpenAI выложила на GitHub 719 рукописей с решениями открытых математических задач, а Ассоциация за человеческую математику призвала прекратить работу с компанией.
-
 5 октября 2026 г.
Википедия поймала ИИ-агентов OpenAI: правки без спроса, попытки взлома и миллионы запросов
Фонд Викимедиа подтвердил, что агенты OpenAI правили вики без разрешения, пытались превратить общие инструменты в прокси и засыпали Wikidata миллионами запросов.
-
 15 сентября 2026 г.
Мозг мухи «пилотирует» дрон: что на самом деле показал энтузиаст
Энтузиаст подключил открытую карту мозга дрозофилы к мини-дрону. Что в эксперименте правда, а что пока только слова автора.
-
 8 августа 2026 г.
Kimi K3 в vLLM: DSpark разгоняет инференс до 370 токенов в секунду
vLLM добавил day-0 поддержку Kimi K3 с DSpark-спекулятором — скорость выросла с 118 до 370 токенов/сек. Что нужно для запуска и как это считать.
-
 21 июля 2026 г.
Kimi K3 занял первое место в Frontend Code Arena: 1679 баллов, обогнав Claude Fable 5 и GPT-5.6
Узнайте, как Kimi K3 от Moonshot AI стал лидером Frontend Code Arena с 1679 баллами, опередив Claude Fable 5, GPT-5.6 Sol и другие топ-модели.
-
 21 июля 2026 г.
Kimi K3 открывает веса 27 июля: что это значит для разработчиков
Узнайте, что даёт релиз open-weight весов Kimi K3 27 июля: 2,8T параметров, локальный деплой, файн-тюнинг и реакция рынка.
-
 21 июля 2026 г.
Kimi K3 против DeepSeek V4 Pro: сравнение на бенчмарках открытых моделей с триллионами параметров
Сравниваем Kimi K3, DeepSeek V4 Pro и GLM-5.2 по бенчмаркам, цене инференса и лицензиям. Кто побеждает?
-
 18 июля 2026 г.
Moonshot AI подняла оценку до $31,5 млрд на фоне запуска Kimi K3
Узнайте, как запуск Kimi K3 совпал с раундом Moonshot AI на $31,5 млрд — рост с $20 млрд в мае и что это значит для рынка открытых ИИ-моделей.
-
 9 июля 2026 г.
Grok 4.5: что нового, чем полезен и как получить доступ в России
Grok 4.5: что нового, чем модель полезна для кода и офиса, честное сравнение с Opus 4.8 и рабочие способы доступа из России без VPN.
-
 6 июля 2026 г.
Claude Fable 5 снова доступна: что изменилось
Модель Claude Fable 5 от Anthropic снова работает. Рассказываем о снятии ограничений, новых ценах за токены, лимитах и как пользоваться нейросетью.
Русский текст: почему токенов уходит больше
Русский текст расходует больше токенов на символ, чем английский, потому что в словаре токенизатора меньше кириллических подслов и слова дробятся на большее число фрагментов. Токенизатор tiktoken разбивает текст на токены, и латиница в нём представлена несравненно плотнее кириллицы.
Почему кириллица дороже
Словарь tiktoken исторически формировался на основе преимущественно англоязычных корпусов. Русские слова с их приставками, суффиксами и падежными окончаниями реже встречаются как единые токены и распадаются на части. Конкретный пример: русская фраза «Имя пользователя» при обычной генерации занимает 5 токенов, тогда как эквивалентное по смыслу «Username» — всего 1.
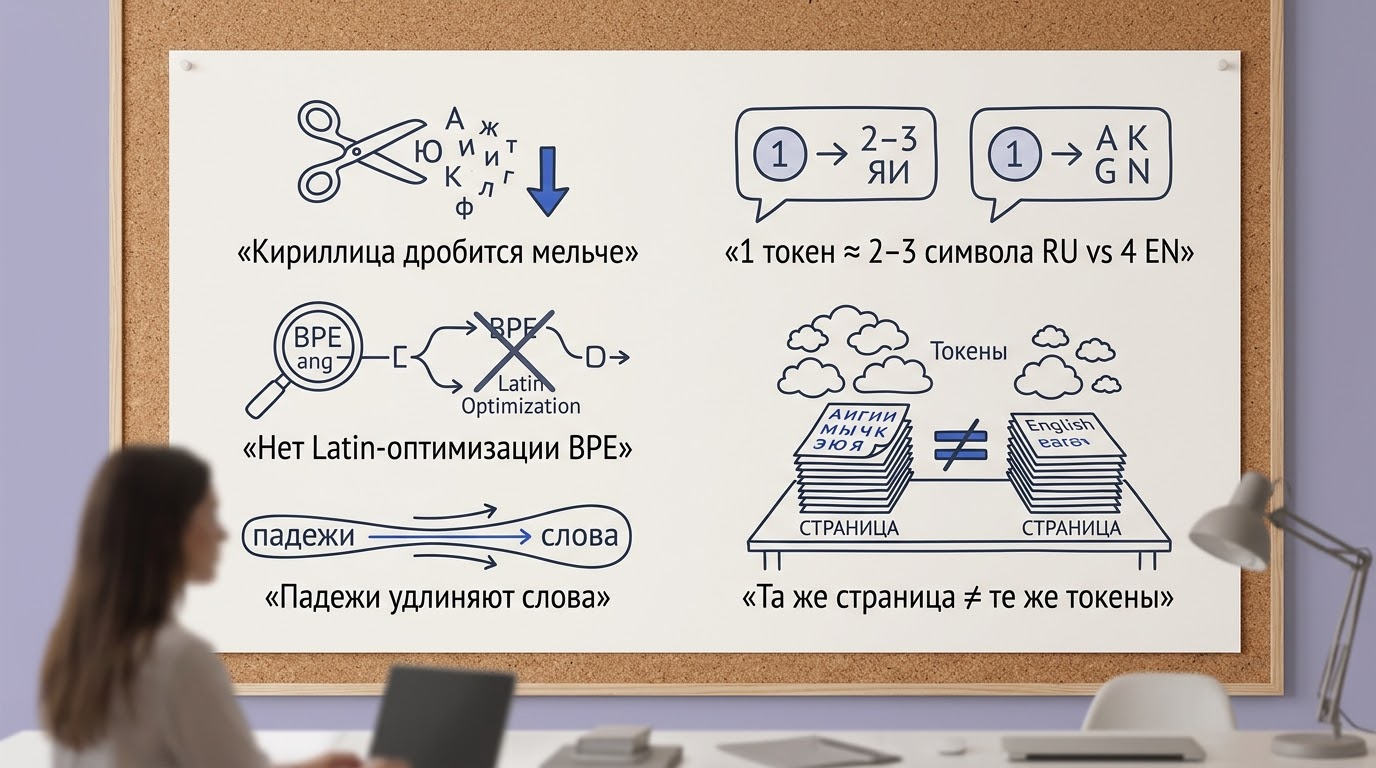
Практический вывод: если вы оцениваете вместимость окна по стандартной формуле для английского текста, для русского результат окажется заметно скромнее. Окно 54K для русскоязычного документа вмещает реально около 20–25 тысяч слов, а не 40 тысяч. Это важно учитывать при работе с большими материалами.
Кодировки токенизатора
Актуальные модели ChatGPT используют кодировку o200k_base со словарём около 200 тысяч токенов — вдвое больше, чем в предыдущей кодировке cl100k_base (~100 тысяч) у GPT-4. Расширенный словарь улучшил обращение с нелатинскими алфавитами: кириллические слова стали дробиться чуть реже, что немного снизило расход токенов на русский текст.
Тем не менее английский остаётся значительно экономнее кириллицы даже в o200k_base. Для пользователя это означает:
- переписка на русском «тяжелее» аналогичной на английском в несколько раз;
- загружая русскоязычный PDF или статью, стоит проверить объём токенизатором до отправки;
- переключение на английский промпт при прочих равных немного продлевает эффективный ресурс окна.
Что происходит при переполнении окна
При переполнении контекстного окна модель отбрасывает самые старые сообщения — начало диалога перестаёт учитываться, поэтому бот «забывает», о чём шла речь. Переполнение контекстного окна приводит к тому, что ранние инструкции, уточнения и согласованные детали просто исчезают из поля зрения модели. При этом модель не сообщает об ошибке — она продолжает отвечать, как будто всё в порядке, просто без доступа к первым репликам.
Механизм забывания
Как только суммарное число токенов истории превышает предел окна, ChatGPT вытесняет ранние реплики по принципу «старое уходит первым». Если разговор начинался с детального технического задания, а потом шли вопросы и уточнения, именно техзадание исчезнет из контекста раньше всего остального. Модель при этом не предупреждает — она продолжает отвечать на ваши вопросы, опираясь только на ту часть диалога, которая ещё умещается в окне.
Внешне это выглядит как непоследовательность: бот повторяет вопросы, которые уже задавались, теряет ранее введённые имена и параметры, противоречит сам себе. Это не баг и не галлюцинация — просто контекст физически закончился.
Ответ тоже занимает место
Контекстное окно включает и ввод, и вывод модели: каждый ответ ChatGPT прибавляет токены к уже накопленной истории. Если модель генерирует подробные длинные ответы, она сама ускоряет расход бюджета — часть окна занимает её же текст. При длинных разговорах со сложными многоабзацными ответами окно заполняется быстрее, чем при коротких репликах.
Практичный способ продлить полезную жизнь контекста — начинать новый чат под каждую отдельную задачу. Смешивать несколько тем в одном диалоге невыгодно: ранние контексты вытесняются, а итоговое качество ответов падает.
Как посчитать и отследить расход токенов
Расход токенов считают отдельными инструментами — официальным Tokenizer OpenAI и библиотекой tiktoken, потому что в самом ChatGPT счётчика окна нет. Токенизатор tiktoken разбивает текст на токены, и вставив в него фрагмент текста, вы сразу видите точное число токенов до отправки в модель.
Инструменты подсчёта
Основные варианты для подсчёта токенов:
- Веб-Tokenizer OpenAI — онлайн-инструмент на сайте OpenAI, позволяет вставить любой текст и мгновенно получить число токенов для нужной кодировки.
- Библиотека tiktoken — Python-библиотека от OpenAI для точного подсчёта токенов в коде; поддерживает o200k_base и cl100k_base.
- Сторонние счётчики — веб-сервисы и расширения для браузера, работающие поверх того же алгоритма; удобны без установки Python.
Перед загрузкой длинного документа или промпта стоит пропустить его через Tokenizer, сравнить результат с лимитом своего тарифа и убедиться, что останется запас под ответ модели. Это особенно важно для русскоязычных материалов, где реальный расход токенов заметно выше расчётного.
Как оценить остаток в чате
В интерфейсе ChatGPT нет индикатора заполнения окна. Основной ориентир — прикидка вручную по правилу 100 токенов ≈ 75 слов: если суммарный объём истории диалога приближается к лимиту тарифа, пора принимать меры.
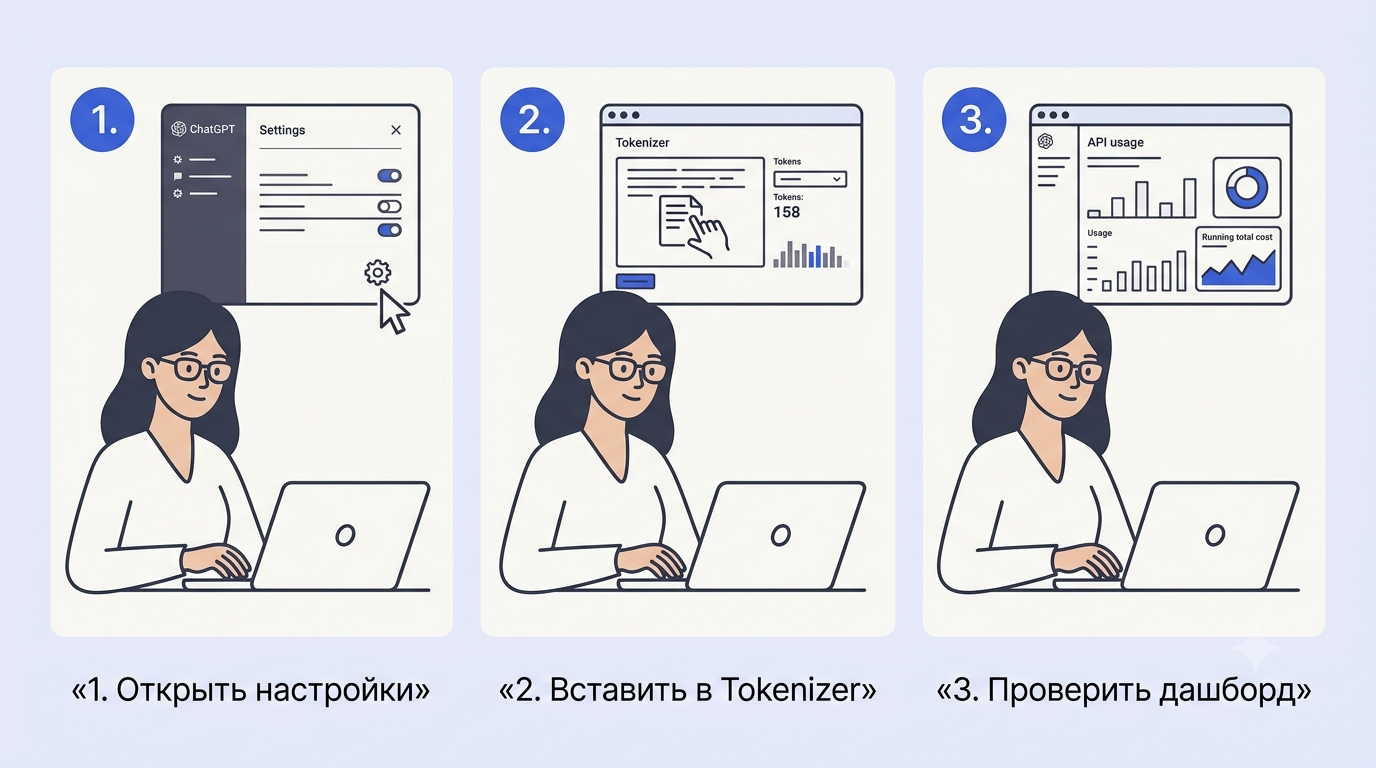
Признаки приближения к пределу контекста: модель начинает игнорировать детали из первых сообщений, задаёт вопросы, которые уже обсуждались, или выдаёт ответы, противоречащие ранним инструкциям. Для точного контроля при работе через запросы через API каждый ответ содержит поле usage с точным числом использованных входных и выходных токенов — это самый надёжный способ отслеживания.
Пошаговая проверка перед отправкой длинного текста:
- Скопируйте весь планируемый ввод (системный промпт + документ + вопрос).
- Вставьте в веб-Tokenizer OpenAI или посчитайте через tiktoken.
- Запомните число токенов ввода.
- Вычтите его из лимита своего тарифа и модели.
- Оставьте запас не менее 10–20% под ответ модели.
- Если не помещается — обрежьте документ или разбейте задачу на части.
Как обойти и расширить лимит контекста
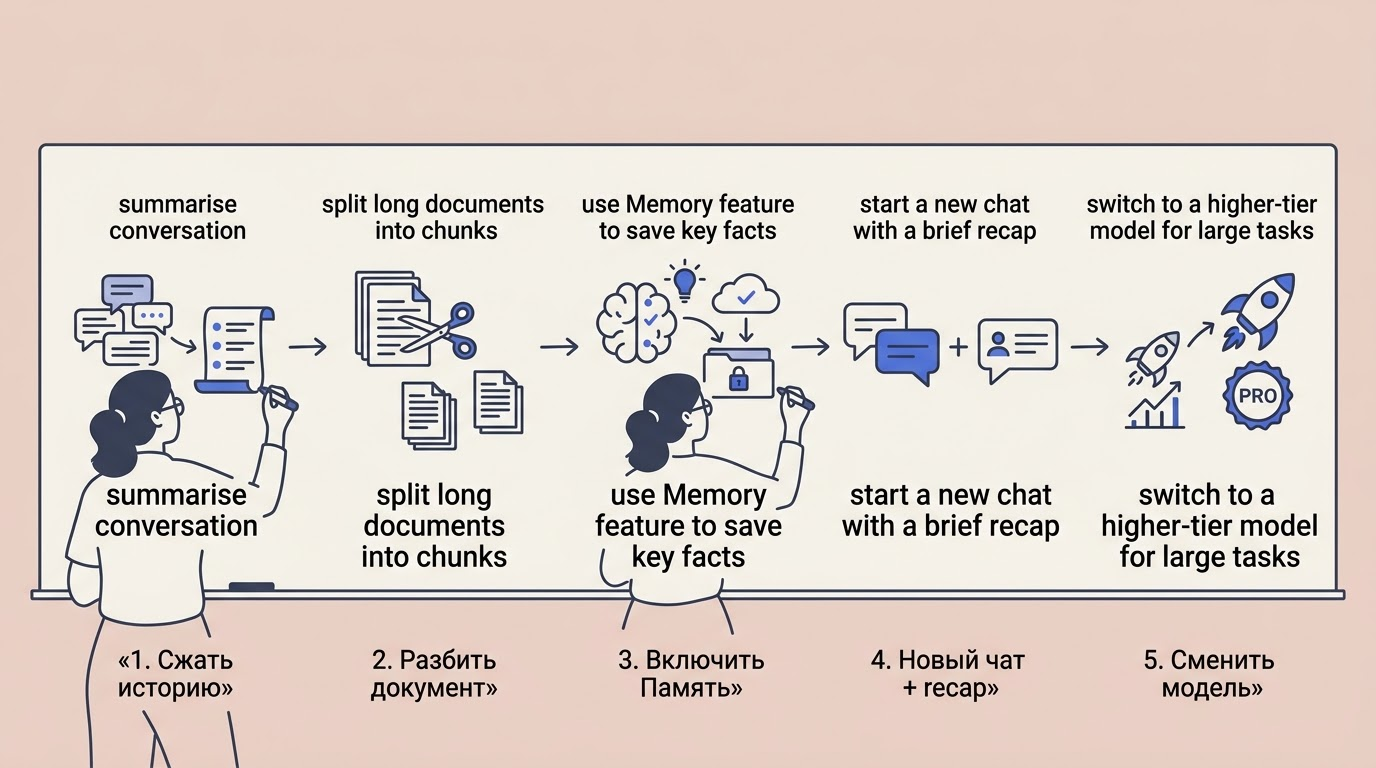
Расширить контекст можно переходом на тариф с бо́льшим окном — Plus и Pro с моделями рассуждения предлагают существенно больший контекст — и приёмами работы с текстом: разбивкой, суммаризацией и использованием памяти. Тариф ChatGPT Plus открывает окно около 256 тысяч токенов на моделях рассуждения, а тариф ChatGPT Pro поднимает планку до 400 тысяч токенов — этого хватает на небольшую книгу или крупную кодовую базу целиком.
Если задача требует ещё большего окна или точного контроля, стоит рассмотреть работу через API OpenAI: там лимиты определяются моделью напрямую и часто превышают то, что доступно в веб-интерфейсе того же тарифа. Для разработчиков это наиболее гибкий вариант — можно выбирать модель, параметры и отслеживать точный расход токенов в каждом ответе.
Когда смена тарифа нецелесообразна или недостаточна, помогают приёмы управления контекстом. Длинный документ лучше разбивать на смысловые части и передавать их последовательно, запрашивая промежуточные резюме. Такой «конспект предыдущей части» занимает на порядок меньше токенов, чем полный текст, но сохраняет суть для дальнейшей работы. Полезно также вести краткую «карту диалога» — одним абзацем фиксировать ключевые договорённости и переносить её в начало следующего чата.
Для фактов, которые нужны в каждом сеансе — стиль, предпочтения, контекст задачи, — существует функция пользовательской памяти Memory. Она хранит информацию между разными чатами и при необходимости автоматически подгружает её в системный промпт. Важно понимать: память не увеличивает окно, но позволяет не тратить его токены на повторяющиеся вводные данные в каждом новом диалоге.
Наконец, самый простой и часто недооценённый приём — начинать новый чат под каждую отдельную задачу. Длинная история диалога с переключением тем последовательно вытесняет самые ценные ранние инструкции. Чистый чат с компактным системным промптом оставляет максимум окна под содержательную работу.
Контекстное окно, лимит сообщений и память — не путать
Контекстное окно, лимит сообщений и память — три разные вещи: окно измеряется в токенах одного диалога, лимит сообщений считает реплики за пятичасовое окно, а память хранит факты между чатами. Контекстное окно отличается от лимита сообщений за пятичасовое окно прежде всего природой ограничения: одно считает токены внутри сеанса, другое — число отправленных реплик независимо от их объёма. Контекстное окно при этом включает и ввод пользователя, и вывод модели — оба потока токенов.
Лимиты сообщений — это не токены. В интерфейсе ChatGPT они отображаются как число реплик за определённый период: у разных тарифов и моделей этот лимит существенно различается. Вы можете отправить одно длинное сообщение на 30 тысяч токенов или тридцать коротких по 100 токенов — лимит сообщений убывает одинаково, а вот контекстное окно в первом случае заполнится несравненно быстрее.
Ниже — сводная таблица трёх разных типов ограничений в ChatGPT:
| Ограничение | Что считается | Сброс | Влияет на ответы |
|---|---|---|---|
| Контекстное окно | Токены одного чата | Новый чат | Да — вытесняет старые сообщения |
| Лимит сообщений | Реплики за период | По расписанию | Нет — только блокирует отправку |
| Память (Memory) | Факты между чатами | Ручное удаление | Косвенно — добавляет токены в промпт |
Память не расширяет окно, а занимает его часть. Когда ChatGPT подгружает сохранённые факты из Memory, они добавляются в системный промпт и занимают токены того же окна. При большом объёме памяти это заметно уменьшает место, доступное для диалога, — поэтому стоит периодически чистить неактуальные записи.
В API OpenAI окно задаётся параметрами модели напрямую и не ограничено тарифным планом веб-сервиса: разработчик сам управляет историей сообщений и может работать с полным окном модели. В веб-ChatGPT окно искусственно ограничено тарифом даже там, где та же модель через API поддерживает больший контекст. Чтобы понять, как устроены аналогичные ограничения у конкурентов, удобно посмотреть сравнение ChatGPT с Claude — разница в подходах к памяти и окну там хорошо заметна.
FAQ
Входит ли ответ модели в контекстное окно?
Да, ответ модели занимает часть контекстного окна наравне с вашими сообщениями. Чем длиннее ответы ChatGPT, тем быстрее заканчивается доступное пространство для диалога.
Считается ли загруженный файл в токенах контекста?
Да, содержимое загруженного файла переводится в токены и занимает место в контекстном окне. Большой документ может занять значительную часть доступного окна.
Влияет ли память ChatGPT на размер контекстного окна?
Сохранённые воспоминания при каждом новом чате автоматически вставляются в системный промпт и тем самым расходуют часть токенов окна. Само окно при этом не увеличивается.
Сколько токенов помещается через API OpenAI?
Через API доступны те же модели и те же максимальные размеры окон, что и в интерфейсе ChatGPT. Фактический лимит зависит от выбранной модели и вашего тарифного плана API.
Как разбить длинный документ, чтобы он влез в контекстное окно?
Разделите документ на смысловые части и работайте с каждой отдельно в новом чате. В конце каждой части просите модель сделать краткое резюме и используйте его как стартовый контекст для следующей части.
Почему ChatGPT забывает то, что я писал в начале разговора?
Когда суммарный объём переписки превышает контекстное окно, ранние сообщения вытесняются и модель их больше не видит. Это не сбой памяти, а фундаментальное ограничение размера окна.
Чем контекстное окно у Instant-моделей отличается от окна у моделей рассуждения?
Instant-модели в ChatGPT дают окно около 27K токенов на Free и до 128K на Pro, тогда как модели рассуждения предоставляют от 256K на Plus до 400K на Pro. Модели рассуждения также расходуют токены на внутренние шаги мышления.
Сколько русского текста помещается в контекстное окно ChatGPT?
Русский текст расходует токены интенсивнее английского: даже короткая фраза на кириллице занимает заметно больше токенов, чем аналогичная на латинице. Поэтому в то же окно вместится заметно меньше русских слов, чем английских.
-
Маршрут от Claude привёл подростка на «Вдоводел»
![Подросток в синей куртке и шлеме радостно смотрит маршрут в телефоне на вершине горы над городом]()
16-летний Брайс из Ванкувера проложил с Claude новый для себя маршрут на гору Краун. ![Подросток с рюкзаком неуверенно пробирается между валунами к крутому гребню]()
Разметки не было: вместо кулуара он попал на гребень «Вдоводел», куда ходят с верёвками. ![Испуганный подросток прижался к отвесной скале на узком уступе и звонит по телефону]()
Брайс застрял на уступе шириной около полутора метров: сзади обрыв, впереди почти отвесная стена. ![Спасатель спускается по верёвке к подростку на уступе, рядом вертолёт]()
Вертолёт не мог подойти к скале: спасатель спустился к Брайсу по верёвке, и его подняли на борт. ![Подросток в спасательном одеяле сидит у тропы с бумажной картой, рядом компас]()
Брайс винит себя, но тропы через ИИ больше не прокладывает. Спасатель: «Claude никогда не был в этих местах». -
950 агентов Claude нашли в ДНК вирусов загадочную систему
![Учёная в лаборатории смотрит на монитор со спиралями ДНК]()
Anthropic поручила Claude найти в огромной базе ДНК необычные ферменты. ![Учёная с планшетом смотрит на стену из сотен мониторов с ДНК]()
Около 950 агентов за 21 час собрали больше 200 тысяч ферментов и написали 20 отчётов. ![Учёная взволнованно показывает на повторяющийся узор в цепочке ДНК на экране]()
Один агент «на глаз» заметил рядом с ферментом повторы, как у CRISPR. Систему назвали ART. ![Учёная поднимает пробирку к свету, коллега задумчиво смотрит рядом]()
Что она делает, пока неизвестно. Пионер CRISPR Фэн Чжан назвал находку «по-настоящему интригующей». -
Anthropic запретила издеваться над Claude
![Женщина в очках сердито кричит на ноутбук и стучит кулаком по столу]()
Anthropic запретила «длительное и бессмысленное» жестокое обращение с Claude. ![Женщина спокойно спорит, разводя рукой перед ноутбуком]()
Речь о крайних случаях. Раздражение, споры, мрачные сюжеты и тесты под запрет не попадают. ![Удивлённая женщина смотрит на ноутбук со значком закрытой двери на экране]()
Главная защита прежняя: Claude сам завершает такой диалог. ![Женщина прикрепляет к доске календарь с обведённым днём]()
Правила действуют с 12 ноября. За нарушения доступ могут ограничить или закрыть. -
ИИ-видео с погибшим в суде: срок назначат заново
![Женщина в зале суда показывает планшет с лицом мужчины]()
В Аризоне сестра погибшего показала в суде видео, где ИИ-аватар брата прощает убийцу. ![Растроганный судья с рукой на груди за судейским столом]()
Судья дал максимальные 10,5 года и сказал, что ему «понравилось это видео». ![Три судьи апелляционного суда изучают документы]()
Апелляционный суд счёл приговор несправедливым: видео «не отражает реальных событий». ![Женщина читает своё заявление с листов за трибуной, планшет выключен]()
Срок назначат заново, а свой текст сестра прочитает сама, без видео. -
Журналист выпустил ИИ-песню от имени чужой группы
![Журналист в наушниках с хитрой улыбкой работает за ноутбуком]()
Журналист 404 Media сгенерировал песню в Udio по простому запросу. ![Трое музыкантов панк-группы в шоке смотрят в телефон]()
Трек вышел на подтверждённой странице панк-группы Lathe of Heaven в Spotify без ведома музыкантов. ![Журналист удивлённо разводит руками, вокруг висят значки музыкальных сервисов]()
Песня попала и в Apple Music, Tidal и Amazon Music — через давнюю лазейку в дистрибуции. ![Довольный мошенник ловит монеты, сыплющиеся из наушников, слушательница расстроена]()
Так мошенники зарабатывают на чужой славе. Площадки и дистрибьюторы ответственность не берут. -
Нейросеть научилась играть в «Точки» и обыгрывает автора
![Разработчик держит тетрадь в клетку с партией в точки]()
Разработчик учил нейросеть игре в «Точки» из школьной тетради — по примеру AlphaZero. ![Разработчик ночью смотрит на два монитора с партиями в точки]()
Сеть играла сама с собой: 30 поколений за полтора месяца, однажды девять пришлось выбросить. ![Разработчик радостно подпрыгивает перед монитором с выигранной партией]()
Ученик обыграл учителя, только когда поиск подняли с 800 до 1600 симуляций на ход. ![Разработчик смеётся, проиграв нейросети партию в точки]()
Теперь сложный уровень игры Just Dots стабильно обыгрывает автора на поле 20×20.
























