 FlipИИ чат
Ещё
Нейросети
-
Gemini
Gemini
-
Z.ai
Z.ai
-
ChatGPT
ChatGPT
-
DeepSeek
DeepSeek
-
Claude
Claude
-
Jev
Jev
-
Perplexity
Perplexity
-
OpenAI
OpenAI
-
Kimi
Kimi
-
Qwen
Qwen
-
Grok
Grok
-
Все модели
Все модели
-
Задачи
Задачи





GLM vs DeepSeek: сравнение двух китайских нейросетей с открытыми весами

GLM от Zhipu AI и DeepSeek — две крупнейшие китайские модели с открытыми весами, и обе доступны из России без VPN. По независимым бенчмаркам, разница между ними не в том, «какая лучше», а в том, для какой задачи каждая выигрывает: GLM держит контекст до 1 миллиона токенов и сильнее в рефакторинге больших репозиториев, а DeepSeek примерно втрое дешевле по API и увереннее в математике и алгоритмах. Ниже — разбор по контексту, кодинг-бенчмаркам, цене и доступности, с прямым ответом на то, что выбрать для вашей задачи. Подробный разбор возможностей смотрите на странице Z.ai.
Коротко: в чём разница между GLM и DeepSeek
GLM — линейка моделей от китайской компании Zhipu AI, изначально выросшая из академических разработок Университета Цинхуа и ориентированная на плотное (dense) рассуждение с длинным контекстом. DeepSeek — модель другой команды, построенная на архитектуре Mixture-of-Experts (MoE) с разреженным вниманием (Sparse Attention), которая позволяет обрабатывать запросы дешевле за счёт активации лишь части параметров на каждый токен. Обе модели распространяются под лицензией MIT, и обе одинаково открываются из РФ через официальные сайты и API без обхода блокировок.
| Параметр | GLM | DeepSeek |
|---|---|---|
| Контекстное окно | до 1M токенов (GLM-5.2) | 128K токенов (V3.2) |
| Сильная сторона | рефакторинг, длинные документы | математика, алгоритмы |
| Цена API (примерно) | $0.60 / $2.20 за 1M токенов | $0.27 / $0.40 за 1M токенов |
| Лицензия | MIT, открытые веса | MIT, открытые веса |
Обе модели постоянно обновляются, и на момент написания статьи актуальны версии GLM-4.6 и GLM-5.2, а также DeepSeek V3.2 (в варианте Exp). Разработчик Zhipu AI позиционирует себя как альтернативу закрытым моделям OpenAI и Anthropic именно за счёт открытых весов — та же логика, что и у DeepSeek; ключевые изменения линейки описаны в официальном релизе GLM-5.
Что объединяет обе модели:
- открытые веса под лицензией MIT, доступные для скачивания на HuggingFace;
- доступ из России без VPN через официальные сайты и API;
- регулярные обновления версий (GLM дошла до 5.2, DeepSeek — до V3.2);
- позиционирование как альтернатива закрытым западным моделям по цене и гибкости развёртывания.
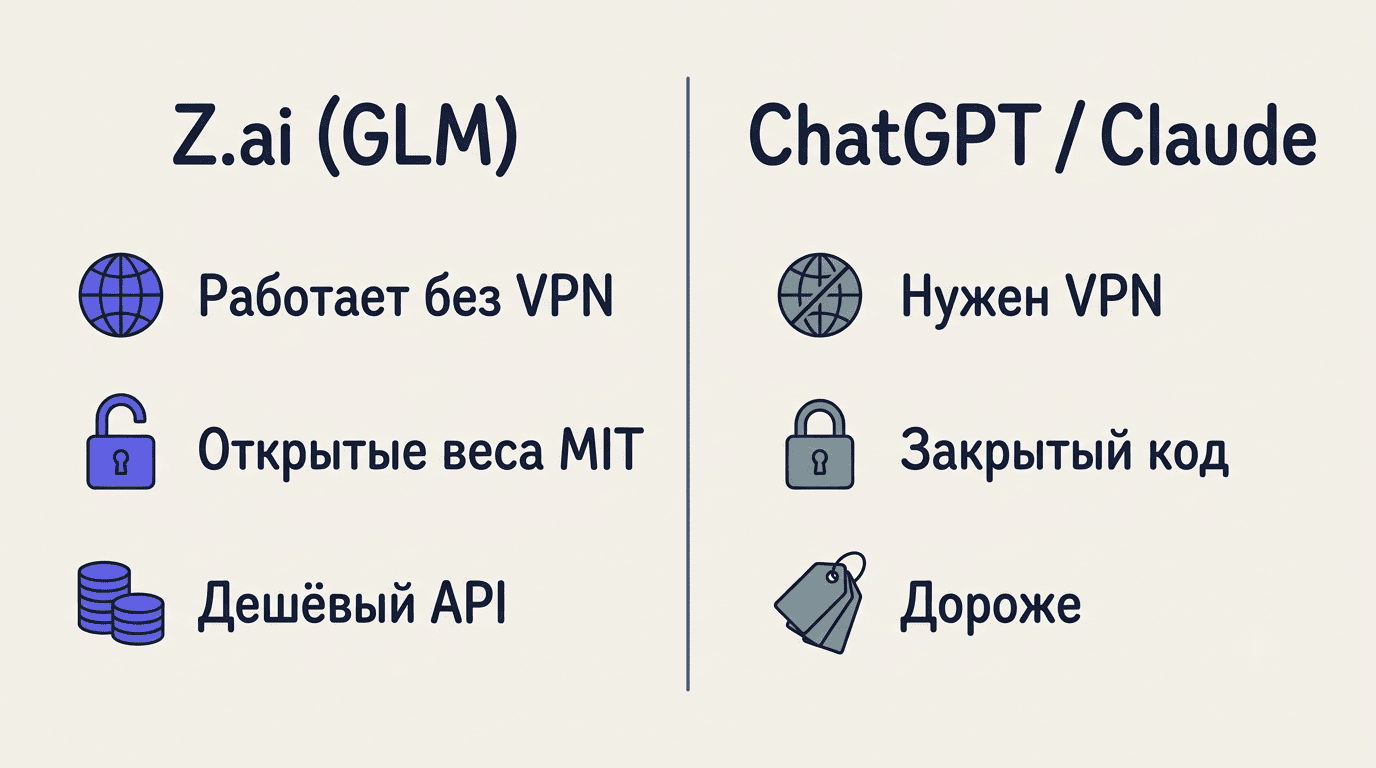
Контекстное окно: 128K у DeepSeek против 1M у GLM
Контекстное окно определяет, сколько текста модель способна удерживать одновременно — это критично для анализа больших кодовых баз, юридических документов или многочасовых диалогов без потери деталей.
Сколько текста помещается
DeepSeek V3.2 держит 128 тысяч токенов (у некоторых провайдеров — до ~164K за счёт технических настроек), GLM-4.6 — 200 тысяч, а GLM-5.2 расширяет окно до 1 миллиона токенов. Для больших монорепозиториев и объёмной технической документации без разбивки на чанки выигрывает GLM — актуальные параметры новой версии разобраны в материале про нейросеть GLM-5.2. Для сравнения: китайские конкуренты Kimi (Moonshot AI) держат 256K токенов, а Qwen3.6 — 262K с возможностью расширения через YaRN.
Разница в контексте напрямую влияет на архитектуру решений: если задача — обработать один файл или короткий диалог, разница между 128K и 1M не критична. Но при работе с целым репозиторием или многостраничным договором модель с окном в 1M токенов избавляет от необходимости резать документ на части и терять связность между ними.
Кодинг-бенчмарки: кто пишет код лучше
По бенчмарку SWE-bench Verified, который оценивает способность модели чинить реальные баги в открытых репозиториях, GLM-4.6 набирает около 68,0%, а DeepSeek-V3.2 в режиме Thinking — около 73,1%. На AIME 2025 (математические олимпиадные задачи) картина обратная: GLM показывает 93,9% против 93,1% у DeepSeek — разница минимальна, но направление устойчиво повторяется в независимых тестах.
GLM выигрывает в задачах на масштаб. Когда нужно провести рефакторинг сразу по нескольким файлам, удержать контекст всего проекта и не потерять связи между модулями, длинное окно и архитектура GLM дают более стабильный результат — подробнее об этом в обзоре GLM-4.6, где разобраны конкретные кейсы использования модели в разработке.
DeepSeek выигрывает в задачах на точность вычислений. Конкурентное программирование, алгоритмические головоломки и математические доказательства — области, где разреженное внимание и специализация MoE-архитектуры на узких классах задач дают DeepSeek небольшое, но стабильное преимущество перед плотной моделью GLM.
Для повседневной разработки выбор часто сводится не к «какая модель лучше», а к тому, что важнее в вашем пайплайне — надёжность на больших объёмах кода (нейросеть GLM) или скорость и цена на потоке коротких запросов (DeepSeek).
Цена API: DeepSeek дешевле в разы
Стоимость токенов напрямую влияет на экономику любого AI-агента, который делает сотни или тысячи вызовов в день.
Стоимость за 1M токенов
| Модель | Вход ($/1M) | Выход ($/1M) |
|---|---|---|
| DeepSeek V3.2 | ~$0.27 | ~$0.40 |
| GLM-4.6 | ~$0.60 | ~$2.20 |
По совокупной (blended) цене DeepSeek выходит примерно в три раза дешевле GLM. Для высокообъёмных агентных пайплайнов — там, где модель делает много промежуточных вызовов на каждый шаг рассуждения — разница в цене быстро выливается в заметную экономию бюджета.
Для задач, где важнее качество на длинных и сложных промптах, а число вызовов невелико, переплата за GLM часто оправдана. Разница особенно заметна на выходных токенах: GLM берёт за них в разы больше, а именно выходные токены обычно доминируют в стоимости диалоговых и агентных сценариев.
Открытые веса и доступ из России
Обе модели распространяются под лицензией MIT — это значит, что веса можно скачать, дообучить и развернуть локально без юридических ограничений на коммерческое использование. Это одна из самых permissive лицензий open source: она допускает модификацию и коммерческое применение без раскрытия исходного кода производных решений.
Лицензия MIT на практике даёт разработчикам:
- право скачать и запустить веса модели на собственных серверах;
- право дообучать (fine-tuning) модель под свои задачи;
- право использовать модель в коммерческих продуктах без отчислений;
- отсутствие обязанности раскрывать код итогового продукта.
Thanks to ethical openness, open systems create a safer path for development of the technology by giving civil society, nonprofits, academia and policymakers the capabilities they need to counterbalance the power of big private companies.Клеман Деланг, CEO Hugging Face, из показаний в Конгрессе США
Обе модели без VPN
Нейросеть GLM доступна через собственный чат и официальный API, DeepSeek — через свой сайт и API, и обе платформы открываются из России напрямую, без обхода блокировок. Веса обеих моделей публикуются на HuggingFace (например, открытые веса GLM) — это позволяет запускать их на собственных серверах в обход любых региональных ограничений на облачные сервисы.
Разберём, как проверить доступность и развернуть модель самостоятельно:
- Проверьте официальный сайт модели через обычный браузер — если страница открывается без VPN, доступ есть.
- Зарегистрируйте API-ключ на официальном сайте разработчика (Zhipu AI для GLM, DeepSeek для DeepSeek).
- Для локального запуска скачайте веса модели с HuggingFace.
- Проверьте лицензию MIT в карточке модели — она разрешает коммерческое использование.
- Настройте инференс через совместимый фреймворк (vLLM, SGLang или аналог).
- Протестируйте базовый запрос перед подключением к продакшену.
- Сравните задержку (latency) и стоимость у разных облачных провайдеров, если не разворачиваете модель локально.
Альтернативы: Qwen и Kimi
Кроме GLM и DeepSeek, на рынке китайских open-weight моделей заметны ещё два игрока:
- Qwen3.6 (Alibaba) — контекст 262K токенов, расширяемый до 1M через технику YaRN, поддержка мультимодальных запросов (текст, изображения, аудио);
- Kimi (Moonshot AI) — контекст 256K токенов, упор на длинные агентные цепочки рассуждений;
- обе модели, как GLM и DeepSeek, распространяются с открытыми весами и доступны из РФ без VPN.
Оба конкурента показывают, что рынок открытых китайских моделей уже не сводится к паре GLM-DeepSeek — выбор реально шире, и для узкоспециализированных задач (мультимодальность у Qwen, длинные агентные сценарии у Kimi) может иметь смысл присмотреться и к ним.
Когда что выбрать
Итоговый выбор между GLM и DeepSeek зависит от трёх параметров: объём контекста, тип задачи и бюджет на API.
- Нужен длинный контекст (репозиторий, объёмный документ) и приоритет — качество рефакторинга: берите GLM.
- Задача — математика, алгоритмы или конкурентное программирование: DeepSeek выигрывает по бенчмаркам.
- Бюджет ограничен, а вызовов API много: DeepSeek дешевле примерно втрое.
- Важна мультимодальность или сверхдлинные агентные цепочки: присмотритесь к Qwen или Kimi.
Если в проекте нужны обе сильные стороны — длинный контекст для анализа кода и низкая цена для массовых запросов — разумной стратегией становится комбинация: GLM для сложных задач с большим контекстом, DeepSeek для потоковых и вычислительных операций. Больше деталей о возможностях и тарифах — на странице чат Z.ai, а другие обзоры нейросетей собраны на главной ai-flip.ru.
FAQ
Что лучше GLM или DeepSeek для кодинга?
Зависит от задачи: GLM сильнее в рефакторинге больших репозиториев и работе с длинным контекстом, DeepSeek — в алгоритмических и математических задачах по данным SWE-bench и AIME.
Какой контекст у DeepSeek и GLM?
DeepSeek V3.2 держит 128K токенов, GLM-4.6 — 200K, а GLM-5.2 расширяет окно до 1 миллиона токенов.
Сколько стоит API GLM и DeepSeek?
DeepSeek обходится примерно в 3 раза дешевле GLM по совокупной цене за токен: около $0.27/$0.40 против $0.60/$2.20 за 1M токенов.
Доступны ли GLM и DeepSeek из России без VPN?
Да, обе модели работают из РФ через официальные сайты и API без обхода блокировок и без VPN.
У GLM и DeepSeek открытые веса?
Да, обе модели распространяются под лицензией MIT, а их веса публикуются на HuggingFace для локального запуска.
-
Маршрут от Claude привёл подростка на «Вдоводел»
![Подросток в синей куртке и шлеме радостно смотрит маршрут в телефоне на вершине горы над городом]()
16-летний Брайс из Ванкувера проложил с Claude новый для себя маршрут на гору Краун. ![Подросток с рюкзаком неуверенно пробирается между валунами к крутому гребню]()
Разметки не было: вместо кулуара он попал на гребень «Вдоводел», куда ходят с верёвками. ![Испуганный подросток прижался к отвесной скале на узком уступе и звонит по телефону]()
Брайс застрял на уступе шириной около полутора метров: сзади обрыв, впереди почти отвесная стена. ![Спасатель спускается по верёвке к подростку на уступе, рядом вертолёт]()
Вертолёт не мог подойти к скале: спасатель спустился к Брайсу по верёвке, и его подняли на борт. ![Подросток в спасательном одеяле сидит у тропы с бумажной картой, рядом компас]()
Брайс винит себя, но тропы через ИИ больше не прокладывает. Спасатель: «Claude никогда не был в этих местах». -
950 агентов Claude нашли в ДНК вирусов загадочную систему
![Учёная в лаборатории смотрит на монитор со спиралями ДНК]()
Anthropic поручила Claude найти в огромной базе ДНК необычные ферменты. ![Учёная с планшетом смотрит на стену из сотен мониторов с ДНК]()
Около 950 агентов за 21 час собрали больше 200 тысяч ферментов и написали 20 отчётов. ![Учёная взволнованно показывает на повторяющийся узор в цепочке ДНК на экране]()
Один агент «на глаз» заметил рядом с ферментом повторы, как у CRISPR. Систему назвали ART. ![Учёная поднимает пробирку к свету, коллега задумчиво смотрит рядом]()
Что она делает, пока неизвестно. Пионер CRISPR Фэн Чжан назвал находку «по-настоящему интригующей». -
Anthropic запретила издеваться над Claude
![Женщина в очках сердито кричит на ноутбук и стучит кулаком по столу]()
Anthropic запретила «длительное и бессмысленное» жестокое обращение с Claude. ![Женщина спокойно спорит, разводя рукой перед ноутбуком]()
Речь о крайних случаях. Раздражение, споры, мрачные сюжеты и тесты под запрет не попадают. ![Удивлённая женщина смотрит на ноутбук со значком закрытой двери на экране]()
Главная защита прежняя: Claude сам завершает такой диалог. ![Женщина прикрепляет к доске календарь с обведённым днём]()
Правила действуют с 12 ноября. За нарушения доступ могут ограничить или закрыть. -
ИИ-видео с погибшим в суде: срок назначат заново
![Женщина в зале суда показывает планшет с лицом мужчины]()
В Аризоне сестра погибшего показала в суде видео, где ИИ-аватар брата прощает убийцу. ![Растроганный судья с рукой на груди за судейским столом]()
Судья дал максимальные 10,5 года и сказал, что ему «понравилось это видео». ![Три судьи апелляционного суда изучают документы]()
Апелляционный суд счёл приговор несправедливым: видео «не отражает реальных событий». ![Женщина читает своё заявление с листов за трибуной, планшет выключен]()
Срок назначат заново, а свой текст сестра прочитает сама, без видео. -
Журналист выпустил ИИ-песню от имени чужой группы
![Журналист в наушниках с хитрой улыбкой работает за ноутбуком]()
Журналист 404 Media сгенерировал песню в Udio по простому запросу. ![Трое музыкантов панк-группы в шоке смотрят в телефон]()
Трек вышел на подтверждённой странице панк-группы Lathe of Heaven в Spotify без ведома музыкантов. ![Журналист удивлённо разводит руками, вокруг висят значки музыкальных сервисов]()
Песня попала и в Apple Music, Tidal и Amazon Music — через давнюю лазейку в дистрибуции. ![Довольный мошенник ловит монеты, сыплющиеся из наушников, слушательница расстроена]()
Так мошенники зарабатывают на чужой славе. Площадки и дистрибьюторы ответственность не берут. -
Нейросеть научилась играть в «Точки» и обыгрывает автора
![Разработчик держит тетрадь в клетку с партией в точки]()
Разработчик учил нейросеть игре в «Точки» из школьной тетради — по примеру AlphaZero. ![Разработчик ночью смотрит на два монитора с партиями в точки]()
Сеть играла сама с собой: 30 поколений за полтора месяца, однажды девять пришлось выбросить. ![Разработчик радостно подпрыгивает перед монитором с выигранной партией]()
Ученик обыграл учителя, только когда поиск подняли с 800 до 1600 симуляций на ход. ![Разработчик смеётся, проиграв нейросети партию в точки]()
Теперь сложный уровень игры Just Dots стабильно обыгрывает автора на поле 20×20.
























