 FlipИИ чат
Ещё
Нейросети
-
Gemini
Gemini
-
Z.ai
Z.ai
-
ChatGPT
ChatGPT
-
DeepSeek
DeepSeek
-
Claude
Claude
-
Jev
Jev
-
Perplexity
Perplexity
-
OpenAI
OpenAI
-
Kimi
Kimi
-
Qwen
Qwen
-
Grok
Grok
-
Все модели
Все модели
-
Задачи
Задачи





Как писать промпты для ChatGPT: приёмы, которые дают разницу в ответе

Качество ответа ChatGPT во многом зависит от того, как сформулирован запрос: чтобы получать точные и полезные результаты, промпты для ChatGPT строят по формуле «роль + задача + контекст + формат + ограничения» и усиливают конкретикой, примерами и просьбой рассуждать пошагово. Подробнее об возможностях ChatGPT можно почитать отдельно; общее описание сервиса приведено на странице ChatGPT в Википедии. Именно формулировка, а не сама тема запроса, определяет, попадёт модель в цель или выдаст размытый общий текст.
В этой статье собраны рабочие приёмы промпт-инжиниринга: как назначать роль, добавлять контекст и примеры (few-shot), задавать формат вывода, ставить ограничения, применять Chain-of-Thought, опорный текст против галлюцинаций и итеративное уточнение. Каждый приём показан на примерах «до и после», чтобы было видно, где именно возникает разница в ответе.
Материал построен так, чтобы после прочтения не пришлось искать дальше: от базовой структуры до продвинутых техник — meta-prompting, self-critique, tree of thought — и разбора типичных ошибок.
Что такое промпт-инжиниринг и почему формулировка меняет ответ
Промпт-инжиниринг — это навык формулировать запросы к ChatGPT так, чтобы получать точные и полезные ответы; по сути это умение управлять языковой моделью через текст на её входе. ChatGPT предсказывает наиболее вероятное продолжение вашего текста, поэтому чем точнее вход, тем точнее выход — и никак иначе. OpenAI строит свой гайд по prompt engineering вокруг шести стратегий: писать чёткие инструкции, давать опорный текст, дробить сложные задачи, давать модели время «подумать», использовать внешние инструменты и систематически тестировать изменения.
Промпт и промпт-инжиниринг простыми словами
Промпт — это любой текстовый запрос к нейросети: вопрос, инструкция, сценарий, шаблон с подставляемыми данными. Составление промптов превращается в промпт-инжиниринг, когда вы осознанно подбираете формулировки, структуру и детали ради предсказуемого результата.
Модель не «понимает» задачу в человеческом смысле — она статистически подбирает продолжение. Если вы написали «расскажи про маркетинг», модель заполнит пробелы своей «средней» трактовкой: скорее всего, получится школьное определение из учебника. Шесть стратегий OpenAI — это и есть рамка, которую покрывает данная статья от начала до конца.
Почему одна тема даёт разные ответы
Возьмём два запроса на одну тему: «расскажи про маркетинг» и «Ты — директор по маркетингу в SaaS-стартапе. Объясни команде из 5 разработчиков, почему product-led growth работает лучше cold outreach на ранней стадии. Формат — три аргумента с примерами, до 400 слов». Ответы будут принципиально разными, потому что второй запрос убирает неопределённость: модель больше не угадывает, кто читатель, какой уровень детализации нужен и как структурировать вывод.
Галлюцинации — придуманные факты, несуществующие ссылки, ложные цифры — тоже возникают там, где модели не хватает опоры. Когда промпт конкретен и содержит исходные данные, диапазон возможных «продолжений» сужается, а вместе с ним сокращается и пространство для домысливания.
Базовая структура промпта: формула из пяти блоков
Эффективный промпт строится по формуле роль + задача + контекст + формат + ограничения — именно эти пять блоков покрывают все параметры, которые модель иначе угадывает самостоятельно. Конкретика и детали в запросе приближают ответ к тому, что нужно пользователю: каждый добавленный блок убирает один класс неопределённости.
Пять блоков: роль, задача, контекст, формат, ограничения
Базовая формула эффективного промпта состоит из пяти блоков. Таблица ниже расшифровывает каждый из них:
| Блок | Что писать | Пример |
|---|---|---|
| Роль | Профессия + уровень + специализация | «Ты копирайтер онлайн-школы» |
| Задача | Глагол в повелительном наклонении | «Напиши», «Составь», «Переведи» |
| Контекст | Для кого, зачем, при каких условиях | «Аудитория — взрослые 30–45 лет без опыта в IT» |
| Формат | Тип вывода и объём | «Список из 5 пунктов», «до 600 символов» |
| Ограничения | Что исключить, чего избегать | «Без восклицаний и канцелярита» |
Каждый блок сужает пространство интерпретаций. Роль задаёт экспертный словарь и тональность. Задача с глаголом в повелительном наклонении исключает риторические ответы. Контекст объясняет, для кого текст, что избавляет модель от необходимости выбирать уровень сложности наугад. Формат убирает вопрос «сколько писать», а ограничения отрезают нежелательные паттерны.
Готовый пример по формуле
Вот полный промпт, собранный по всем пяти блокам: «Ты — копирайтер онлайн-школы. Напиши пост в Telegram о наборе на курс по нейросетям. Аудитория — взрослые 30–45 лет без опыта в IT. Формат — до 600 символов, один призыв к действию. Без восклицаний и канцелярита».
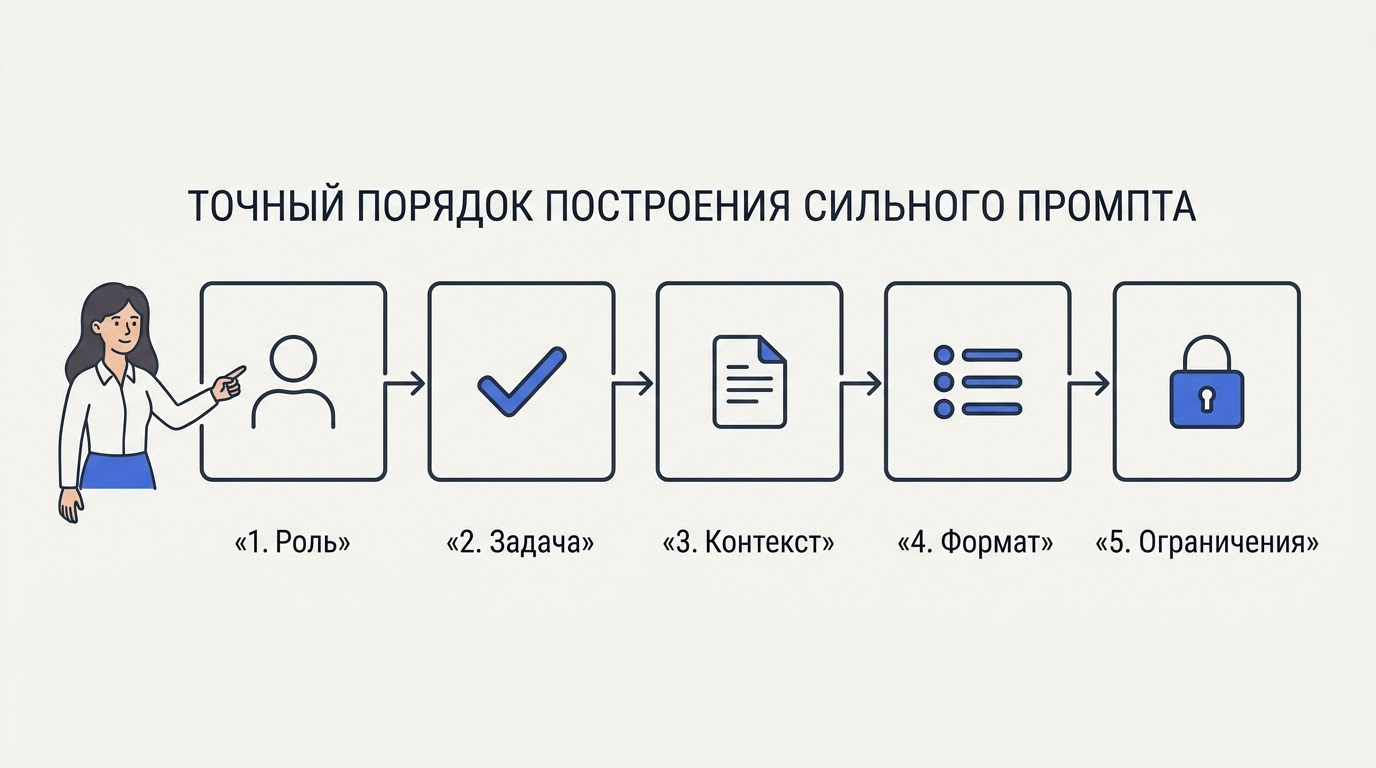
Разберём, как каждый блок влияет на вывод. Роль «копирайтер онлайн-школы» переключает стиль с академического на живой и продающий. Задача «напиши пост» фиксирует жанр. Контекст про аудиторию без опыта в IT убирает технический жаргон. Лимит в 600 символов и один призыв не дают модели раздуть текст. Запрет на восклицания и канцелярит убирает «Спешите записаться!» и «является».
Конкретика вместо общих слов
Правило простое: чем больше деталей в запросе, тем ближе ответ к нужному результату. Расплывчатая инструкция «сделай текст короче» оставляет выбор за моделью — и она может срезать именно нужные подробности. Конкретная замена: «Сократи до 3 предложений, сохрани только выгоды для покупателя, убери историческую справку».
Несколько пар для сравнения: «помоги с письмом» → «Напиши деловое письмо партнёру с просьбой перенести дедлайн с 15 на 22 октября, тон вежливый, объём до 150 слов»; «проанализируй данные» → «Найди три главные тенденции в таблице ниже, приведи цифры, вывод — один абзац». Шаблон промпта работает в любой задаче: чем конкретнее каждый блок, тем предсказуемее ответ.
Роль и персона: как назначение эксперта меняет ответ
Назначение роли задаёт модели нужную экспертизу и тональность ответа: фраза «Ты — CFO с 20-летним опытом» меняет и глубину финансового анализа, и выбор терминов, и степень детализации рисков. Без указания персоны ChatGPT по умолчанию работает как «универсальный ассистент» — и отвечает усреднённо.
Как правильно задать роль
Рабочая формула роли состоит из трёх элементов: профессия + уровень опыта + специализация. Примеры: «Ты — редактор научпоп-издания с фокусом на доступность для широкой аудитории», «Ты — юрист по трудовому праву РФ с опытом в спорах об увольнении», «Ты — UX-писатель мобильных приложений для финтеха». Каждое уточнение сужает словарный запас модели и глубину ответа.
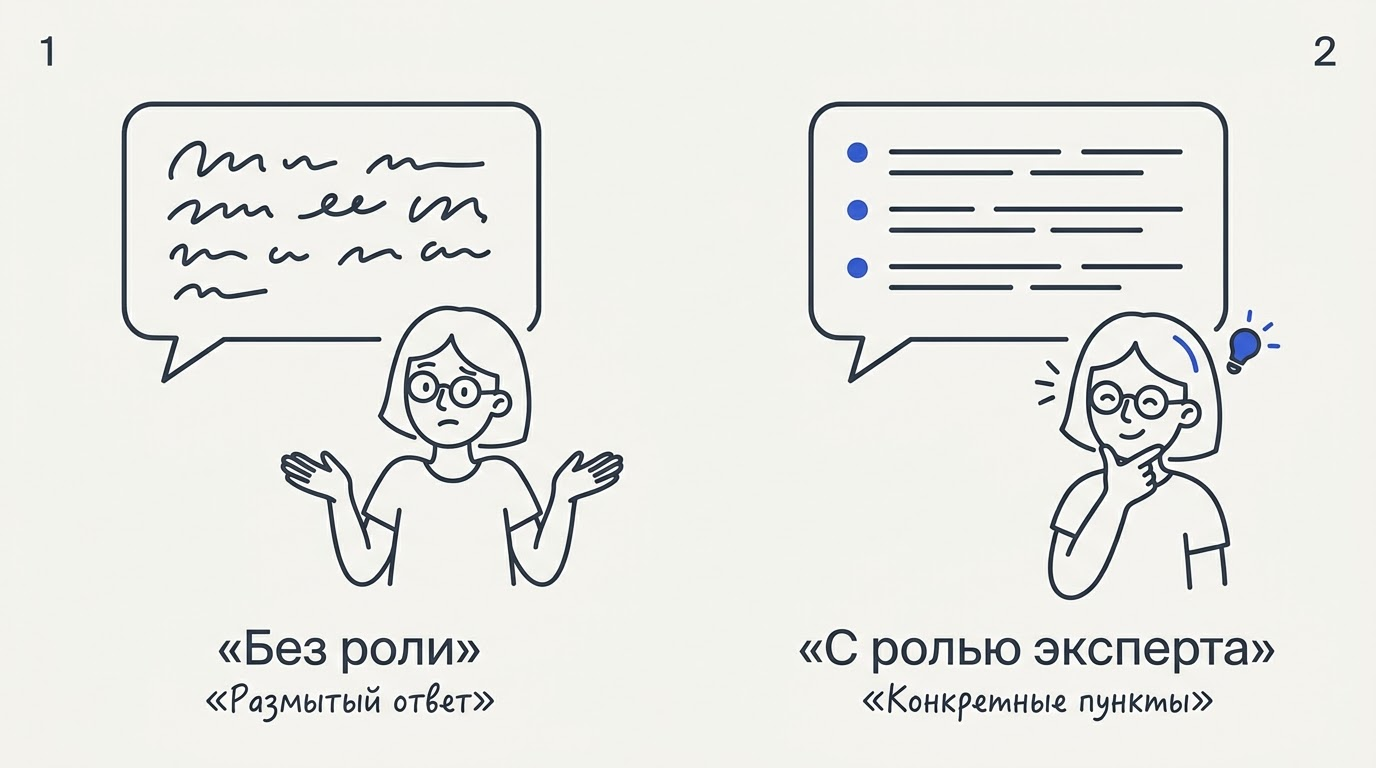
Роль system persona особенно полезна, когда нужен стилистически однородный текст: серия постов, цепочка писем, документация. Назначив роль один раз, вы фиксируете тональность на весь диалог, и модель не «прыгает» между форматами от сообщения к сообщению.
Когда роль не нужна
Для простых фактических вопросов роль избыточна и лишь увеличивает длину промпта: «Сколько дней в феврале 2028 года?» не выигрывает от добавления «Ты — эксперт по календарям».
Стоит предостеречь от «магических» ролей вроде «Ты — гений», «Ты — умнейший человек планеты» — они не добавляют пользы, потому что не задают конкретную экспертизу:
- «Ты — гений» → модель не знает, в какой области применять гениальность
- «Ты — data scientist с опытом в A/B-тестировании» → модель выбирает статистический инструментарий и точную терминологию
- «Ты — эксперт» → слишком широко, результат непредсказуем
- «Ты — технический писатель, специализирующийся на API-документации» → жанр и стиль заданы однозначно
Конкретная экспертиза в роли важнее любых превосходных степеней.
Примеры в промпте: zero-shot и few-shot
Few-shot точнее zero-shot для задач, где важен конкретный стиль и формат: когда вы показываете модели несколько пар «вход → желаемый выход», она копирует паттерн, а не угадывает его. Техника few-shot — это, по сути, обучение по примерам прямо внутри промпта.
Похожий подход работает и в других моделях: советы по промптам для Claude помогут применить те же принципы на другой платформе.
Zero-shot: запрос без примеров
Zero-shot — это когда модель выполняет задачу по одному описанию без каких-либо образцов результата. Подход подходит для простых и типовых запросов: «Переведи фразу на английский», «Суммируй текст в трёх предложениях», «Исправь орфографические ошибки».
Граница применимости zero-shot — там, где важен нестандартный стиль или специфический формат. Если нужно, чтобы заголовки статьи были «провокационными, с числом и глаголом действия», модель не угадает этот паттерн из описания — её нужно показать на примерах.
Few-shot: 2–5 образцов результата
Чтобы задать паттерн, достаточно 2–5 пар «вход → выход» прямо в теле промпта. Пример для классификации отзывов:
- «Доставили быстро, всё в порядке» → позитивный
- «Товар пришёл разбитым, поддержка не ответила» → негативный
- «Обычный продукт, ничего особенного» → нейтральный
После этих примеров модель классифицирует новые отзывы в том же формате и с той же логикой. Рекомендация: 2–5 примеров достаточно; больше — увеличивают длину промпта без пропорционального прироста качества. Примеры должны покрывать крайние случаи: типичный, граничный и нетипичный вход.
Пошаговое рассуждение: приём Chain-of-Thought
Chain-of-Thought — фраза «думай пошагово» — заметно повышает точность в задачах на логику, математику и код: модель не прыгает к ответу, а строит цепочку промежуточных рассуждений, каждое из которых можно проверить. Это один из самых простых в применении приёмов составления промптов для ИИ.
Как и когда применять «думай пошагово»
Добавьте в конец промпта фразу «Рассуждай шаг за шагом» или «Let’s think step by step» — и модель начнёт выводить промежуточные шаги перед финальным ответом. Наибольший прирост точности фиксируется именно в многоступенчатых задачах: математика, логические головоломки, отладка кода, юридический анализ с несколькими условиями.
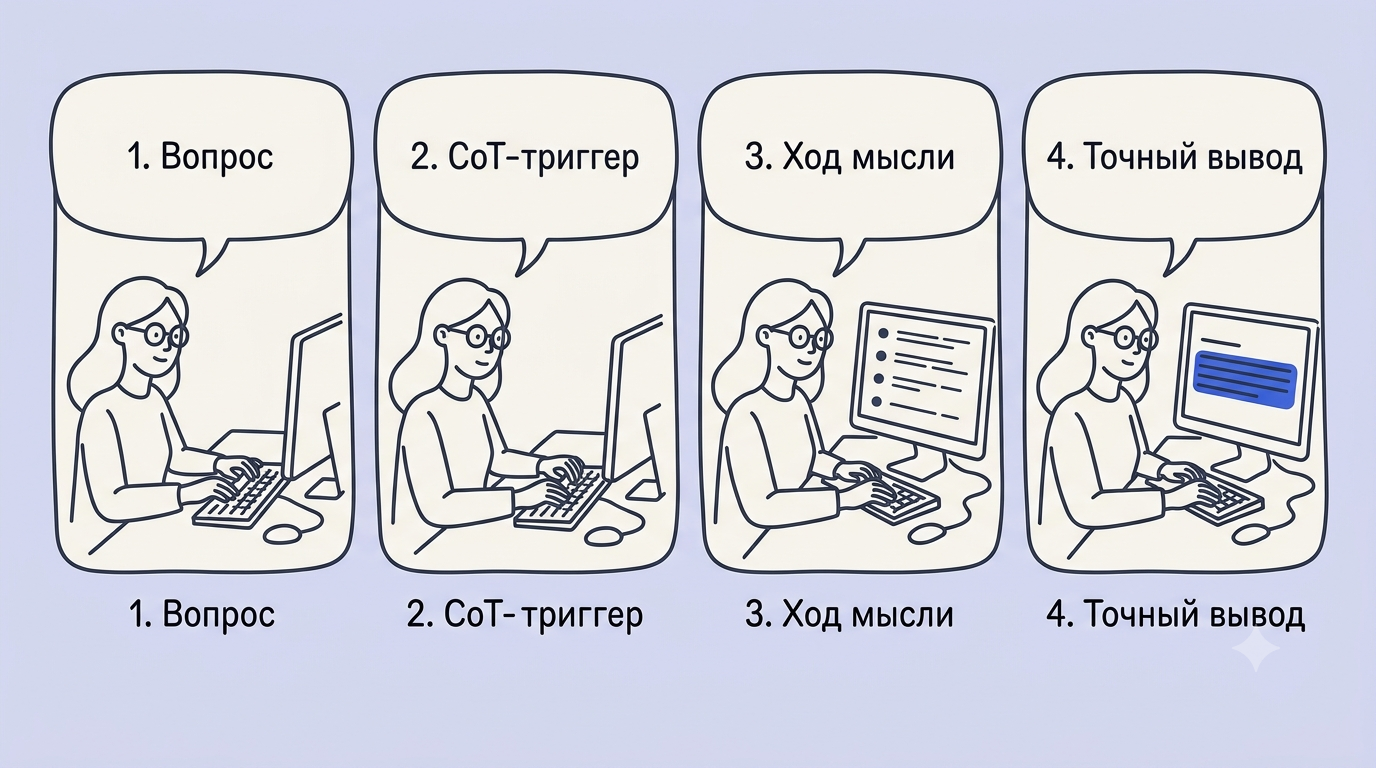
Пошаговый гайд по применению Chain-of-Thought:
- Сформулируйте задачу как обычно — роль, задача, контекст.
- Добавьте в конец: «Рассуждай шаг за шагом перед финальным ответом».
- Прочитайте цепочку рассуждений в ответе — это позволяет найти ошибку на конкретном шаге.
- Если шаг ошибочен, укажите на него точечно: «На шаге 3 ты не учёл налог — пересчитай с этого места».
- Для коротких простых вопросов уберите инструкцию — она лишь удлинит ответ без пользы.
Предупреждение: для простых однозначных вопросов цепочка рассуждений избыточна и делает ответ громоздким. Оставляйте её для задач, где процесс важен так же, как результат.
Tree of Thought: несколько вариантов решения
Tree of Thought — развитие Chain-of-Thought для задач, где существует несколько равноправных подходов. Инструкция: «Предложи 3 разных подхода к решению задачи, для каждого перечисли плюсы, минусы и риски, затем выбери лучший и объясни почему».
Приём особенно ценен в стратегическом планировании, выборе архитектурного решения, творческих задачах с открытым финалом. Модель не уходит в первое попавшееся решение, а явно исследует пространство вариантов — и финальный выбор оказывается аргументированным. Для технических задач можно задать критерии сравнения явно: «оценивай по скорости внедрения, стоимости и масштабируемости».
Формат вывода и ограничения ответа
Указание формата вывода заставляет модель выдать результат в виде таблицы, списка или JSON, а ограничения задают длину и стиль — оба рычага работают вместе и определяют, насколько ответ пригоден к использованию сразу после получения. Негативные инструкции («не используй…») устраняют из ответа штампы и нежелательные слова.
Как задать таблицу, список или JSON
Прямо назовите формат в промпте: «Ответь таблицей со столбцами: название, цена, описание» или «Верни JSON с полями name, price, in_stock — только JSON без пояснений». Для структурированного вывода, который пойдёт в код, фраза «только JSON без пояснений» критична: иначе модель добавит текст до и после блока, и парсер сломается.
Полезные форматные инструкции:
- «Маркированный список из 5–7 пунктов, каждый — одно предложение»
- «Таблица markdown с заголовком и разделителем»
- «Два абзаца по 3–4 предложения, без подзаголовков»
- «Ответ в одном предложении»
- «JSON-массив объектов, каждый с полями id и label»
Длину лучше задавать в конкретных единицах: символах, предложениях или словах — а не расплывчато «кратко» или «подробно».
Можно привести в пример то, как сам ChatGPT описывал свои возможности в момент запуска:
ChatGPT был запущен 30 ноября 2022 года и привлёк большое внимание пользователей своими широкими возможностями: написание кода, создание текстов, возможности перевода, получения точных ответов и использование контекста диалога для ответов, хотя его фактическая точность и подверглась критике.Википедия
Этот абзац хорошо иллюстрирует широту задач, которые модель берётся решать «из коробки» — но именно поэтому без чёткого формата вывода она выдаёт то код, то эссе, то список, ориентируясь лишь на собственную интерпретацию запроса.
Негативные инструкции: что не делать
Негативные инструкции — явный список запретов в промпте — убирают конкретные паттерны, которые модель воспроизводит по умолчанию. Формула: «Не используй слова-паразиты», «Без вводных фраз вроде «Конечно, я помогу»», «Не выдумывай факты — если не знаешь, напиши «нет данных»».
Это снижает два риска одновременно: стилистический мусор (канцелярит, восклицания, шаблонные зачины) и фактические домыслы. Совмещайте позитивные инструкции с негативными: «Пиши коротко и по делу. Не используй пассивный залог и слово «является»» работает лучше, чем одна из двух половин по отдельности.
Против галлюцинаций: опорный текст и разделители
Опорный текст (grounding data) снижает галлюцинации и выдумки модели: вы вставляете в промпт исходные данные и явно требуете отвечать только по ним. Разделители — тройные кавычки, теги или заголовки ### — отделяют инструкцию от обрабатываемого текста так, чтобы модель точно знала, что является командой, а что — материалом.
Базовый шаблон с опорным текстом выглядит так: инструкция сверху («Отвечай, опираясь только на текст ниже; если ответа в тексте нет — напиши «нет данных»»), затем разделитель, затем сам текст в тройных кавычках или между тегами. Такая структура механически предотвращает ситуацию, когда модель «переходит» от данных к фантазии, потому что граница между командой и источником стала явной.
OpenAI рекомендует использовать разделители — тройные кавычки, теги или заголовки вроде ###, — чтобы чётко отделить инструкцию от обрабатываемого текста. Практический пример: вверху промпта стоит «Найди все упомянутые суммы и контрагентов», затем строка """, затем текст договора, затем снова """. Модель обрабатывает только то, что внутри кавычек, и не добавляет сведения из обучающих данных.
Для фактологических задач — извлечение данных, точные ответы по документу, генерация с жёсткими ограничениями — OpenAI советует снижать температуру модели до минимума. Нулевая температура убирает случайность в выборе токенов и делает ответ детерминированным: один и тот же промпт при одинаковых данных даёт один и тот же результат. Учитывайте, что размер опорного текста ограничен контекстным окном модели; подробнее об этом написано в материале про лимиты токенов и контекста.
Ещё один приём против галлюцинаций — прямо попросить модель признавать незнание: «Если тебе не хватает данных для ответа, напиши «недостаточно информации» вместо предположения». Это не устраняет проблему полностью, но резко снижает число уверенно звучащих ошибок, которые легко принять за факт.
Итеративное уточнение и продвинутые приёмы
Итеративное уточнение улучшает результат через несколько раундов правок: не нужно ждать идеального ответа с первого промпта — лучше получить черновик и давать точечные правки. Meta-prompting — это когда ChatGPT сам пишет оптимальный промпт для задачи: вы описываете цель, а модель формулирует запрос, который затем выполняет.
Точечная правка эффективнее переписывания. Получив черновик, не удаляйте его и не начинайте заново — укажите конкретное место и конкретное изменение: «Сделай второй абзац конкретнее, добавь одну цифру», «Перепиши заключение в виде призыва к действию». Если первый ответ не устраивает в нескольких местах сразу, правьте по одному: так легче отследить, какое изменение что дало.
Meta-prompting экономит время на формулировку сложных запросов. Инструкция: «Напиши промпт, который даст идеальный результат для задачи X: [описание задачи]». Модель создаёт развёрнутый шаблон, который вы редактируете под свои данные. Это особенно полезно, когда задача нестандартная и вы сами не знаете, с чего начать.
Self-critique использует модель как ревьюера собственного вывода. Инструкция: «Найди три слабых места в этом тексте и перепиши их». Или более строго: «Оцени текст по критериям: ясность, конкретность, структура. Поставь оценку от 1 до 5 по каждому, объясни и перепиши». Приём работает как встроенная петля качества.
Дополнительные техники итеративного диалога:
- Попросить модель задать уточняющие вопросы до начала работы: «Прежде чем отвечать, задай мне 3 вопроса, которые помогут тебе дать точный ответ»
- Разбить большую задачу на этапы и подтверждать каждый перед следующим
- Сохранять удачные промпты в библиотеку — они работают повторно без изменений
Типичные ошибки и примеры «до и после»
Главные ошибки при составлении промптов — общий запрос без деталей, отсутствие роли и контекста, несколько несвязанных задач в одном промпте — их объединяет одно: они оставляют модели слишком много пространства для самостоятельных решений. Конкретика и детали в запросе приближают ответ к тому, что нужно пользователю, а эффективный промпт строится по формуле роль + задача + контекст + формат + ограничения.
Пять частых ошибок
Каждая ошибка решается одним конкретным действием:
- Слишком общий запрос — добавьте роль, аудиторию, цель
- Нет контекста — объясните, для кого текст и какова ситуация
- Несколько задач в одном промпте — разбейте на отдельные сообщения или пронумеруйте задачи явно
- Не указан формат — назовите тип вывода и объём в конкретных единицах
- Нет итерации — не принимайте первый ответ как финальный; дайте точечную правку
Примеры «до и после»
| Слабый промпт | Усиленный промпт | В чём разница |
|---|---|---|
| «Напиши пост» | «Ты — SMM-менеджер. Напиши пост в Telegram об акции на курс. Аудитория — студенты 18–25 лет. Формат — до 500 символов, один призыв. Без восклицаний» | Конкретная роль, аудитория, жёсткий формат и ограничение стиля |
| «Объясни это» | «Ты — преподаватель физики для 9-го класса. Объясни принцип суперпозиции простыми словами на одном бытовом примере, без формул» | Уровень аудитории, способ объяснения и ограничение на формулы |
| «Сделай лучше» | «Сократи текст вдвое, сохрани только три главных аргумента, убери все вводные фразы» | Конкретный критерий улучшения вместо расплывчатого «лучше» |
Кастомные инструкции ChatGPT
В настройках ChatGPT есть раздел Custom Instructions, где роль, стиль и ограничения задаются один раз и автоматически применяются ко всем новым чатам. Это избавляет от необходимости каждый раз писать «Ты — редактор с фокусом на технологии, пиши кратко, без канцелярита» в начале каждого промпта.
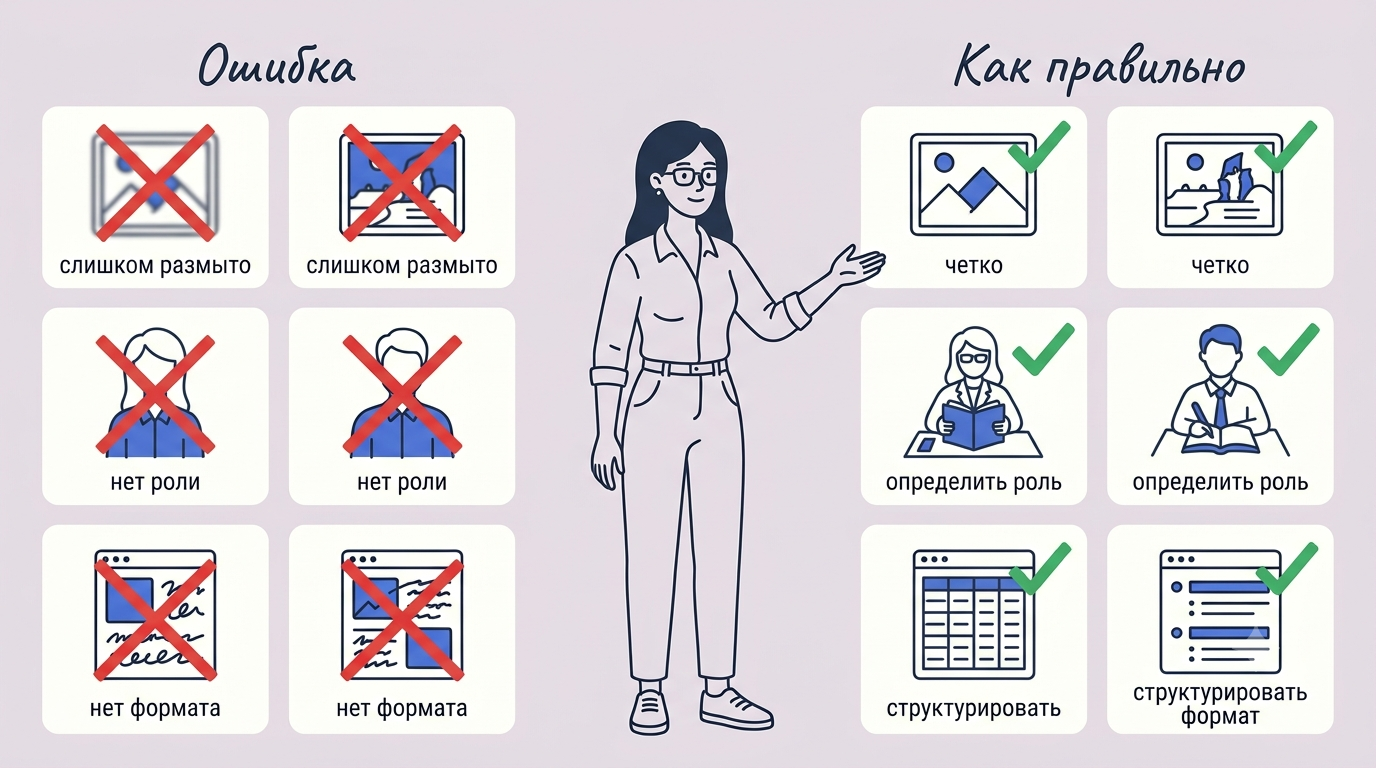
Подробнее о том, как настроить постоянные инструкции, написано в разделе кастомные инструкции в Projects. Custom Instructions особенно полезны для профессионального использования: один раз прописав свою роль, тип задач и запрещённые паттерны, вы сокращаете рабочий промпт до задачи + контекста, не теряя качества.
FAQ
Что такое промпт простыми словами?
Промпт — это любой текстовый запрос, который вы отправляете ChatGPT. Чем точнее он сформулирован, тем полезнее и предсказуемее ответ модели.
Почему одна и та же тема даёт разные ответы при разной формулировке?
Языковая модель чувствительна к каждому слову: другая формулировка активирует другой контекст и меняет вероятности следующих токенов. Именно поэтому «объясни» и «напиши пошагово» приводят к принципиально разным текстам.
Насколько подробным должен быть запрос?
Запрос должен содержать ровно столько деталей, сколько нужно, чтобы исключить неоднозначность: роль, задачу, контекст, формат и ограничения. Лишние подробности не мешают, а вот их отсутствие заставляет модель додумывать.
Что значит «думай пошагово» и когда это помогает?
Фраза «думай пошагово» активирует приём Chain-of-Thought: модель выписывает промежуточные рассуждения перед ответом. Это заметно повышает точность в задачах на логику, математику и код.
Как запретить ChatGPT использовать определённые слова или обороты?
Укажите запрет явно в блоке ограничений: например, «не используй слово u0022уникальныйu0022, избегай канцелярита». Модель соблюдает такие ограничения, если они сформулированы конкретно, а не расплывчато.
Как бороться с галлюцинациями и выдумками в ответах?
Передавайте проверенный опорный текст прямо в промпт и просите модель опираться только на него. Для фактологических задач OpenAI также советует выставлять температуру модели на минимальное значение.
Чем системная инструкция отличается от обычного запроса?
Системная инструкция задаётся один раз и действует на весь чат: она определяет роль, стиль и ограничения модели. Обычный запрос — разовая задача внутри уже установленного контекста.
Как проверить, что промпт стал лучше?
Запустите один и тот же промпт несколько раз и сравните результаты, затем измените одну переменную и повторите. OpenAI строит свой гайд вокруг систематического тестирования изменений как отдельной стратегии.
-
Маршрут от Claude привёл подростка на «Вдоводел»
![Подросток в синей куртке и шлеме радостно смотрит маршрут в телефоне на вершине горы над городом]()
16-летний Брайс из Ванкувера проложил с Claude новый для себя маршрут на гору Краун. ![Подросток с рюкзаком неуверенно пробирается между валунами к крутому гребню]()
Разметки не было: вместо кулуара он попал на гребень «Вдоводел», куда ходят с верёвками. ![Испуганный подросток прижался к отвесной скале на узком уступе и звонит по телефону]()
Брайс застрял на уступе шириной около полутора метров: сзади обрыв, впереди почти отвесная стена. ![Спасатель спускается по верёвке к подростку на уступе, рядом вертолёт]()
Вертолёт не мог подойти к скале: спасатель спустился к Брайсу по верёвке, и его подняли на борт. ![Подросток в спасательном одеяле сидит у тропы с бумажной картой, рядом компас]()
Брайс винит себя, но тропы через ИИ больше не прокладывает. Спасатель: «Claude никогда не был в этих местах». -
950 агентов Claude нашли в ДНК вирусов загадочную систему
![Учёная в лаборатории смотрит на монитор со спиралями ДНК]()
Anthropic поручила Claude найти в огромной базе ДНК необычные ферменты. ![Учёная с планшетом смотрит на стену из сотен мониторов с ДНК]()
Около 950 агентов за 21 час собрали больше 200 тысяч ферментов и написали 20 отчётов. ![Учёная взволнованно показывает на повторяющийся узор в цепочке ДНК на экране]()
Один агент «на глаз» заметил рядом с ферментом повторы, как у CRISPR. Систему назвали ART. ![Учёная поднимает пробирку к свету, коллега задумчиво смотрит рядом]()
Что она делает, пока неизвестно. Пионер CRISPR Фэн Чжан назвал находку «по-настоящему интригующей». -
Anthropic запретила издеваться над Claude
![Женщина в очках сердито кричит на ноутбук и стучит кулаком по столу]()
Anthropic запретила «длительное и бессмысленное» жестокое обращение с Claude. ![Женщина спокойно спорит, разводя рукой перед ноутбуком]()
Речь о крайних случаях. Раздражение, споры, мрачные сюжеты и тесты под запрет не попадают. ![Удивлённая женщина смотрит на ноутбук со значком закрытой двери на экране]()
Главная защита прежняя: Claude сам завершает такой диалог. ![Женщина прикрепляет к доске календарь с обведённым днём]()
Правила действуют с 12 ноября. За нарушения доступ могут ограничить или закрыть. -
ИИ-видео с погибшим в суде: срок назначат заново
![Женщина в зале суда показывает планшет с лицом мужчины]()
В Аризоне сестра погибшего показала в суде видео, где ИИ-аватар брата прощает убийцу. ![Растроганный судья с рукой на груди за судейским столом]()
Судья дал максимальные 10,5 года и сказал, что ему «понравилось это видео». ![Три судьи апелляционного суда изучают документы]()
Апелляционный суд счёл приговор несправедливым: видео «не отражает реальных событий». ![Женщина читает своё заявление с листов за трибуной, планшет выключен]()
Срок назначат заново, а свой текст сестра прочитает сама, без видео. -
Журналист выпустил ИИ-песню от имени чужой группы
![Журналист в наушниках с хитрой улыбкой работает за ноутбуком]()
Журналист 404 Media сгенерировал песню в Udio по простому запросу. ![Трое музыкантов панк-группы в шоке смотрят в телефон]()
Трек вышел на подтверждённой странице панк-группы Lathe of Heaven в Spotify без ведома музыкантов. ![Журналист удивлённо разводит руками, вокруг висят значки музыкальных сервисов]()
Песня попала и в Apple Music, Tidal и Amazon Music — через давнюю лазейку в дистрибуции. ![Довольный мошенник ловит монеты, сыплющиеся из наушников, слушательница расстроена]()
Так мошенники зарабатывают на чужой славе. Площадки и дистрибьюторы ответственность не берут. -
Нейросеть научилась играть в «Точки» и обыгрывает автора
![Разработчик держит тетрадь в клетку с партией в точки]()
Разработчик учил нейросеть игре в «Точки» из школьной тетради — по примеру AlphaZero. ![Разработчик ночью смотрит на два монитора с партиями в точки]()
Сеть играла сама с собой: 30 поколений за полтора месяца, однажды девять пришлось выбросить. ![Разработчик радостно подпрыгивает перед монитором с выигранной партией]()
Ученик обыграл учителя, только когда поиск подняли с 800 до 1600 симуляций на ход. ![Разработчик смеётся, проиграв нейросети партию в точки]()
Теперь сложный уровень игры Just Dots стабильно обыгрывает автора на поле 20×20.
























