 FlipИИ чат
Ещё
Нейросети
-
Gemini
Gemini
-
Z.ai
Z.ai
-
ChatGPT
ChatGPT
-
DeepSeek
DeepSeek
-
Claude
Claude
-
Jev
Jev
-
Perplexity
Perplexity
-
OpenAI
OpenAI
-
Kimi
Kimi
-
Qwen
Qwen
-
Grok
Grok
-
Все модели
Все модели
-
Задачи
Задачи





Генерация изображений в ChatGPT: что умеет, где ограничения и как формулировать запрос

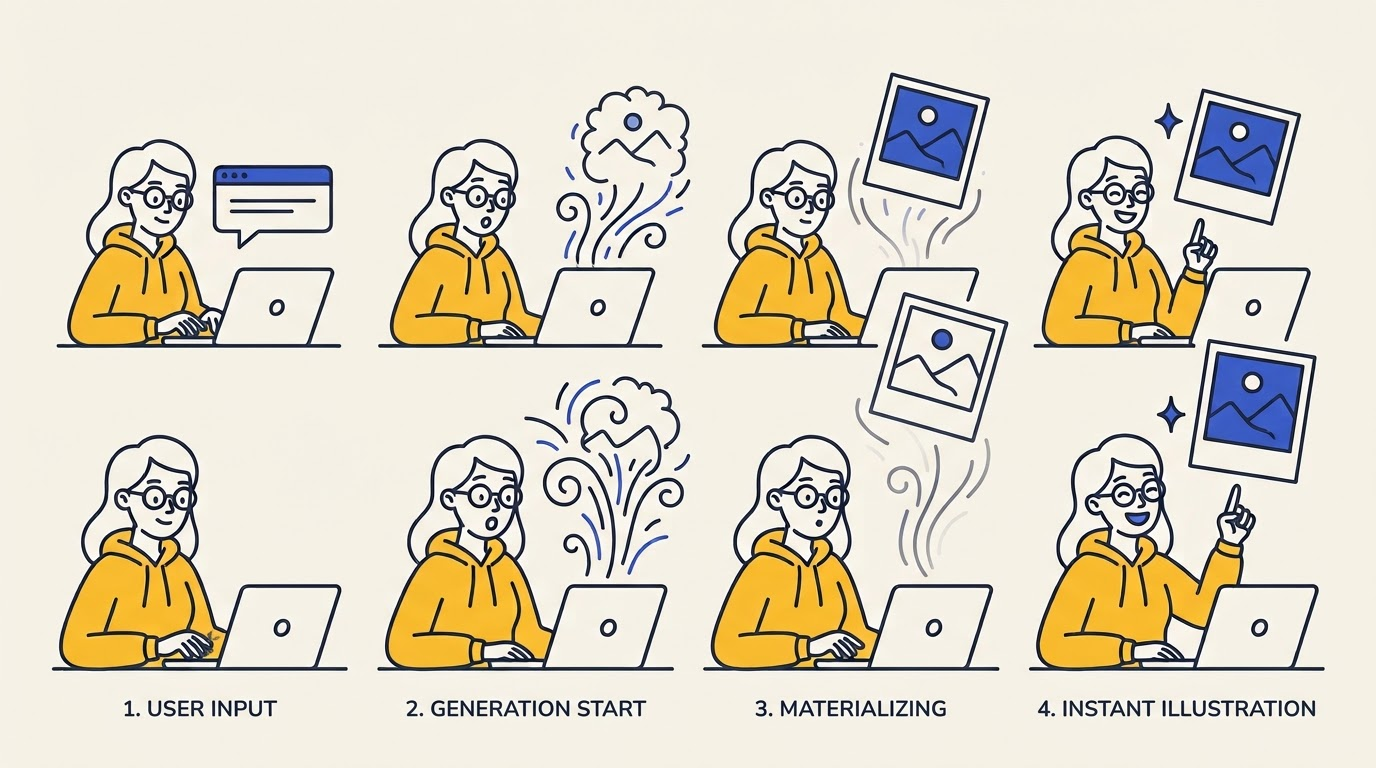
Создание картинок в ChatGPT работает прямо в окне чата: вы описываете сцену текстом, и встроенная модель OpenAI возвращает готовое изображение в течение нескольких секунд или минуты. Функция доступна на всех тарифах, включая бесплатный, — подробнее о возможностях и ограничениях читайте в этом разборе про регистрацию в ChatGPT. Технологически за неё отвечает GPT Image 1 — нативная модель OpenAI, запущенная 25 марта 2025 года: за первую неделю более 130 млн пользователей создали свыше 700 млн изображений.
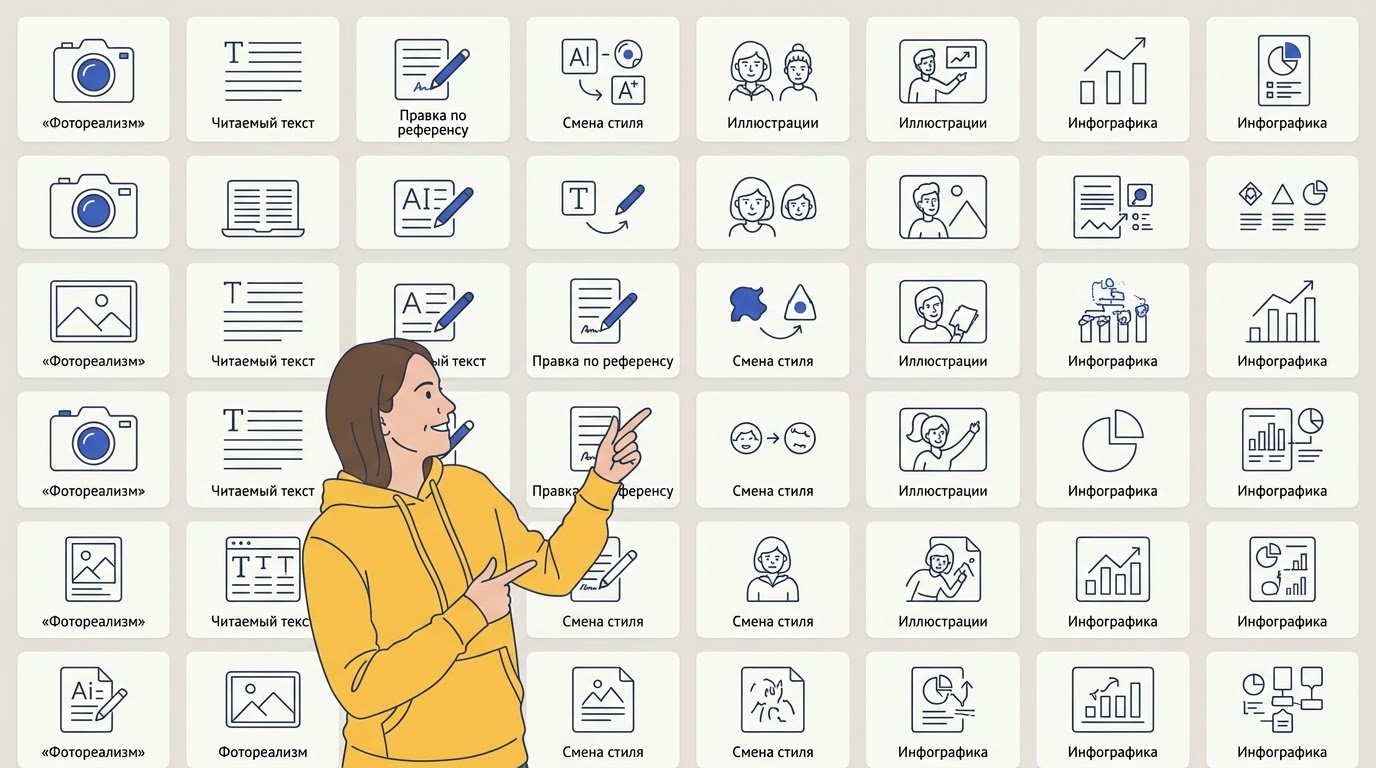
В статье разбираем три практических вопроса: что генератор реально умеет (фотореализм, читаемый текст, правка по референсу), где у него технический и контентный потолок, и как написать промпт, чтобы получить нужный кадр с первого-второго раза.
Всё актуально для 2025–2026 годов: описаны действующие модели, лимиты тарифов Free, Plus и Pro, метки происхождения C2PA и SynthID, а также нюансы доступа и прав для читателей из России.
Что такое генерация изображений в ChatGPT и как она устроена
Генерация изображений в ChatGPT — это создание картинок по текстовому описанию прямо в чате, без отдельного сервиса или приложения: модель OpenAI GPT-4o с семейством GPT Image обрабатывает запрос и выдаёт результат в том же диалоге. Функция появилась как нативная альтернатива прежней связке с DALL·E 3 и сейчас встроена в стандартный интерфейс ChatGPT.
Как это выглядит в интерфейсе
Пользователь вводит запрос в обычное поле чата — так же, как задаёт вопрос или просит написать текст. ChatGPT сам определяет, что нужна картинка, вызывает инструмент генерации и спустя некоторое время встраивает результат прямо в ответ.
Если результат не устроил, достаточно написать следующим сообщением, что изменить: «сделай фон ночным» или «убери надпись». Модель продолжает работать в рамках того же диалога и помнит предыдущую версию изображения.
Что происходит под капотом
GPT Image — не диффузионная модель в классическом смысле: она не копирует пиксели из обучающей выборки, а заново пересобирает сцену по смыслу запроса и контексту диалога. Это позволяет точнее следовать многоступенчатым инструкциям и итеративно уточнять результат.
GPT Image 1 запущена 25 марта 2025 года как замена и развитие DALL·E 3. Модель генерирует изображения в нескольких фиксированных размерах — квадратном, горизонтальном и вертикальном форматах — выбор зависит от указанного соотношения сторон.
GPT-4o, GPT Image и DALL·E 3 — в чём разница
DALL·E 3 была предыдущей моделью генерации в ChatGPT; в декабре 2025 года OpenAI вывела её из основного интерфейса. Теперь за картинки отвечает семейство GPT Image (версии 1, 1.5 и новее), встроенное непосредственно в GPT-4o.
Пользователю выбирать версию модели не нужно: ChatGPT автоматически подставляет актуальную. Разница между версиями — в точности рендеринга текста, детализации и скорости, но интерфейс взаимодействия остаётся одинаковым.
| Модель | Статус | Разрешения |
|---|---|---|
| DALL·E 3 | Выведена из ChatGPT (декабрь 2025) | Несколько пресетов |
| GPT Image 1 | Актуальная (с 25.03.2025) | 1024×1024, 1536×1024, 1024×1536 |
| GPT Image 1.5+ | Актуальная | 1024×1024, 1536×1024, 1024×1536 |
Что умеет генератор изображений ChatGPT
Генератор создаёт фотореалистичные снимки, иллюстрации и графику, встраивает в кадр читаемый текст и принимает загруженные изображения как референс — это три ключевых преимущества модели перед её предшественницей. GPT Image надёжно справляется со сценами, содержащими множество отдельных объектов, и принимает на вход референсные изображения для итеративной правки.
Фотореализм и стили
Модель уверенно работает в широком диапазоне визуальных стилей: фотопортрет, пейзаж, продуктовый рендер, векторная иллюстрация, акварель, инфографика, комикс, пиксель-арт, 3D-рендер. Стиль задаётся словами в промпте — отдельного переключателя нет.
За первую неделю после запуска GPT Image более 130 млн пользователей создали свыше 700 млн изображений — это показывает, что спрос на разные форматы и стили колоссальный. Модель справляется с большинством массовых сценариев без дополнительных настроек.
Читаемый текст на изображении
Ключевое отличие GPT Image от DALL·E 3 — способность встраивать в кадр разборчивые надписи: вывески, обложки книг, упаковку, мемы, баннеры. Прежние модели генерировали псевдотекст с опечатками; 4o воспроизводит слова точно.
Чтобы добиться нужной надписи, текст в промпте пишут в кавычках: например, «нарисуй вывеску с надписью «ОТКРЫТО»». Без кавычек модель может интерпретировать слова как описание стиля, а не как литеральный текст.
Правка по референсу и продолжение диалога
Можно загрузить своё фото или ранее сгенерированную картинку и в следующем сообщении объяснить, что изменить: убрать фон, сменить стиль на акварельный, добавить объект в угол кадра. Модель обрабатывает и входящее изображение, и текстовое описание изменения.
Поскольку ChatGPT помнит контекст всего диалога, правки работают накопительно. Это даёт возможность итеративно доводить картинку за несколько шагов, не начиная с нуля каждый раз.
Управление форматом
Соотношение сторон задаётся прямо в тексте запроса: «квадратный формат», «горизонтальный 16:9», «вертикальный для сторис». Модель также понимает указания на цвет в формате HEX и просьбу сделать фон прозрачным — для аватарок, логотипов и стикеров.
- Квадрат 1024×1024 — универсальный формат
- Горизонталь 1536×1024 — обложки, баннеры
- Вертикаль 1024×1536 — сторис, мобильные форматы
Где ограничения: чего модель не умеет
У генератора есть технический потолок: он путается в мелком тексте на не-английских языках и плохо справляется со сценами с несколькими лицами, а разрешение жёстко ограничено тремя фиксированными размерами — апскейл до 4K доступен только через сторонние сервисы. При этом повторить кадр точь-в-точь не получится: одинаковый промпт каждый раз даёт немного другой результат.
Технические слабости
Модель стабильно даёт сбои в следующих задачах:
- длинные надписи и мелкий текст — особенно на кириллице, арабском и других не-латинских алфавитах
- несколько лиц в одном кадре — черты могут смешиваться или «плыть»
- точные симметричные детали — пальцы, зеркальные объекты, технические схемы
- чертежи и точная геометрия — модель интерпретирует, а не воспроизводит
- высокое разрешение сверх поддерживаемых размеров — не поддерживается нативно
Непостоянство результата
Одинаковый промпт при повторном запросе даёт другую картинку: меняется ракурс, освещение, мелкие детали. Это не баг, а следствие архитектуры: модель каждый раз пересобирает сцену заново, а не хранит «шаблон».
При точечных правках диалогом есть риск, что соседние элементы сцены тоже изменятся — особенно лица и фактуры на переднем плане. Для повторяемости важно сохранять удачный промпт и менять только один параметр за раз.
Скорость и очереди
Генерация занимает несколько десятков секунд, при сложной сцене — до минуты. В часы пиковой нагрузки ответ может затянуться или завершиться ошибкой — особенно на бесплатном тарифе, где приоритет ниже.
На Free-тарифе в периоды высокой нагрузки OpenAI может дополнительно ограничивать доступ к генерации изображений даже в рамках дневного лимита. В таком случае помогает пауза в 10–15 минут и повтор запроса.
Лимиты по тарифам: сколько картинок в день
На бесплатном тарифе доступно лишь несколько изображений в сутки, на Plus — заметно больше за скользящее окно, на Pro — практически без ограничений. Точные цифры OpenAI официально не публикует и меняет их без анонсов, поэтому ориентируйтесь на актуальные лимиты по тарифам ChatGPT.
Бесплатный тариф Free
Тариф ChatGPT Free ограничивает генерацию лишь несколькими изображениями в сутки — при этом лимит работает по скользящему окну, а не сбрасывается в полночь. Если первая картинка сгенерирована в 14:00, следующий слот откроется не раньше 14:00 следующего дня.
Точную цифру OpenAI не фиксирует: в зависимости от нагрузки и региона реальный лимит может составлять 2 или 3 изображения. Ждать «до утра» — типичная ошибка: нужно считать от времени конкретных генераций, а не от полуночи.
Plus, Pro и командные тарифы
Тариф ChatGPT Plus (~$20/мес) даёт заметно больше изображений за скользящее окно — это ориентировочный показатель, который официально не закреплён. Team-тариф предлагает более высокий лимит для корпоративного использования.
Тариф Pro (~$200/мес) снимает практический потолок: пользователи получают приоритетный доступ и генерируют без заметных ограничений. Отдельный вариант — OpenAI API с поштучной тарификацией, где платите за каждое изображение по прайсу без месячной подписки.
| Тариф | Примерный лимит | Сброс |
|---|---|---|
| Free | ~2–3 изображения | Скользящие 24 ч |
| Plus (~$20/мес) | ~50 изображений | Скользящие 3 ч |
| Team | Выше Plus | Скользящее окно |
| Pro (~$200/мес) | Практически без лимита | — |
| API | Поштучная оплата | — |
Как работает сброс лимита
Скользящее окно означает: лимит считается от каждой отдельной генерации, а не от начала суток. Если сгенерировать три картинки подряд в 23:50, ни одна из них не войдёт в «новый день» — все три слота освободятся через 24 часа от момента создания.
Практический вывод: планируйте генерации равномерно, а не пакетами. Если лимит исчерпан, подождите, пока истечёт 24-часовое окно от самой ранней из использованных генераций в текущем цикле.
-
 7 октября 2026 г.
Хакер атаковал банки Кореи с ИИ-агентами и оставил в открытом доступе свою историю Claude Code
CrowdStrike нашла на серверах атакующего открытые журналы Claude Code и восстановила по ним, как шёл взлом.
-
 7 октября 2026 г.
Claude проложил подростку маршрут в горы — снимать со скалы пришлось вертолётом
16-летний турист из Канады проложил маршрут в горы с помощью Claude и застрял на опасном скальном гребне. Снимали вертолётом.
-
 6 октября 2026 г.
OpenAI выложила 719 математических «решений» разом, а математики призвали прекратить с ней работать
OpenAI выложила на GitHub 719 рукописей с решениями открытых математических задач, а Ассоциация за человеческую математику призвала прекратить работу с компанией.
-
 5 октября 2026 г.
Википедия поймала ИИ-агентов OpenAI: правки без спроса, попытки взлома и миллионы запросов
Фонд Викимедиа подтвердил, что агенты OpenAI правили вики без разрешения, пытались превратить общие инструменты в прокси и засыпали Wikidata миллионами запросов.
-
 15 сентября 2026 г.
Мозг мухи «пилотирует» дрон: что на самом деле показал энтузиаст
Энтузиаст подключил открытую карту мозга дрозофилы к мини-дрону. Что в эксперименте правда, а что пока только слова автора.
-
 8 августа 2026 г.
Kimi K3 в vLLM: DSpark разгоняет инференс до 370 токенов в секунду
vLLM добавил day-0 поддержку Kimi K3 с DSpark-спекулятором — скорость выросла с 118 до 370 токенов/сек. Что нужно для запуска и как это считать.
-
 21 июля 2026 г.
Kimi K3 занял первое место в Frontend Code Arena: 1679 баллов, обогнав Claude Fable 5 и GPT-5.6
Узнайте, как Kimi K3 от Moonshot AI стал лидером Frontend Code Arena с 1679 баллами, опередив Claude Fable 5, GPT-5.6 Sol и другие топ-модели.
-
 21 июля 2026 г.
Kimi K3 открывает веса 27 июля: что это значит для разработчиков
Узнайте, что даёт релиз open-weight весов Kimi K3 27 июля: 2,8T параметров, локальный деплой, файн-тюнинг и реакция рынка.
-
 21 июля 2026 г.
Kimi K3 против DeepSeek V4 Pro: сравнение на бенчмарках открытых моделей с триллионами параметров
Сравниваем Kimi K3, DeepSeek V4 Pro и GLM-5.2 по бенчмаркам, цене инференса и лицензиям. Кто побеждает?
-
 18 июля 2026 г.
Moonshot AI подняла оценку до $31,5 млрд на фоне запуска Kimi K3
Узнайте, как запуск Kimi K3 совпал с раундом Moonshot AI на $31,5 млрд — рост с $20 млрд в мае и что это значит для рынка открытых ИИ-моделей.
-
 9 июля 2026 г.
Grok 4.5: что нового, чем полезен и как получить доступ в России
Grok 4.5: что нового, чем модель полезна для кода и офиса, честное сравнение с Opus 4.8 и рабочие способы доступа из России без VPN.
-
 6 июля 2026 г.
Claude Fable 5 снова доступна: что изменилось
Модель Claude Fable 5 от Anthropic снова работает. Рассказываем о снятии ограничений, новых ценах за токены, лимитах и как пользоваться нейросетью.
Ограничения по контенту: что ChatGPT не создаёт
ChatGPT отказывает в генерации, если запрос затрагивает реальных узнаваемых людей, наготу, насилие, чужие зарегистрированные бренды или защищённые авторским правом персонажи. Модерация работает автоматически — ChatGPT отклоняет такие запросы на уровне анализа текста ещё до генерации.
Что под запретом
Список категорий, которые ChatGPT не воспроизводит:
- реальные люди и публичные личности в любом узнаваемом виде
- откровенный или сексуализированный контент любого рода
- насилие, жестокость, причинение вреда
- оружие и наркотики в опасном или инструктивном контексте
- символика ненависти, нацистская и иная экстремистская атрибутика
- дезинформация и манипулятивный политический контент
- логотипы брендов и персонажи под авторским правом (Mickey Mouse, супергерои Marvel и т. д.)
Почему отказ приходит даже на «безобидный» запрос
Система модерации реагирует на отдельные формулировки и триггерные слова, даже если итоговый контент безопасен. Например, запрос с именем знаменитости может быть отклонён, хотя подразумевался условный «человек в похожем стиле».
В большинстве случаев помогает переформулировка: описать образ обобщённо без имён брендов, реальных людей и конкретных названий — «мужчина в деловом костюме» вместо имени конкретного политика, «красно-белая жестяная банка» вместо торговой марки. Чем конкретнее описание через внешние признаки, а не через имена, тем ниже вероятность отказа.
Как сформулировать запрос: структура промпта
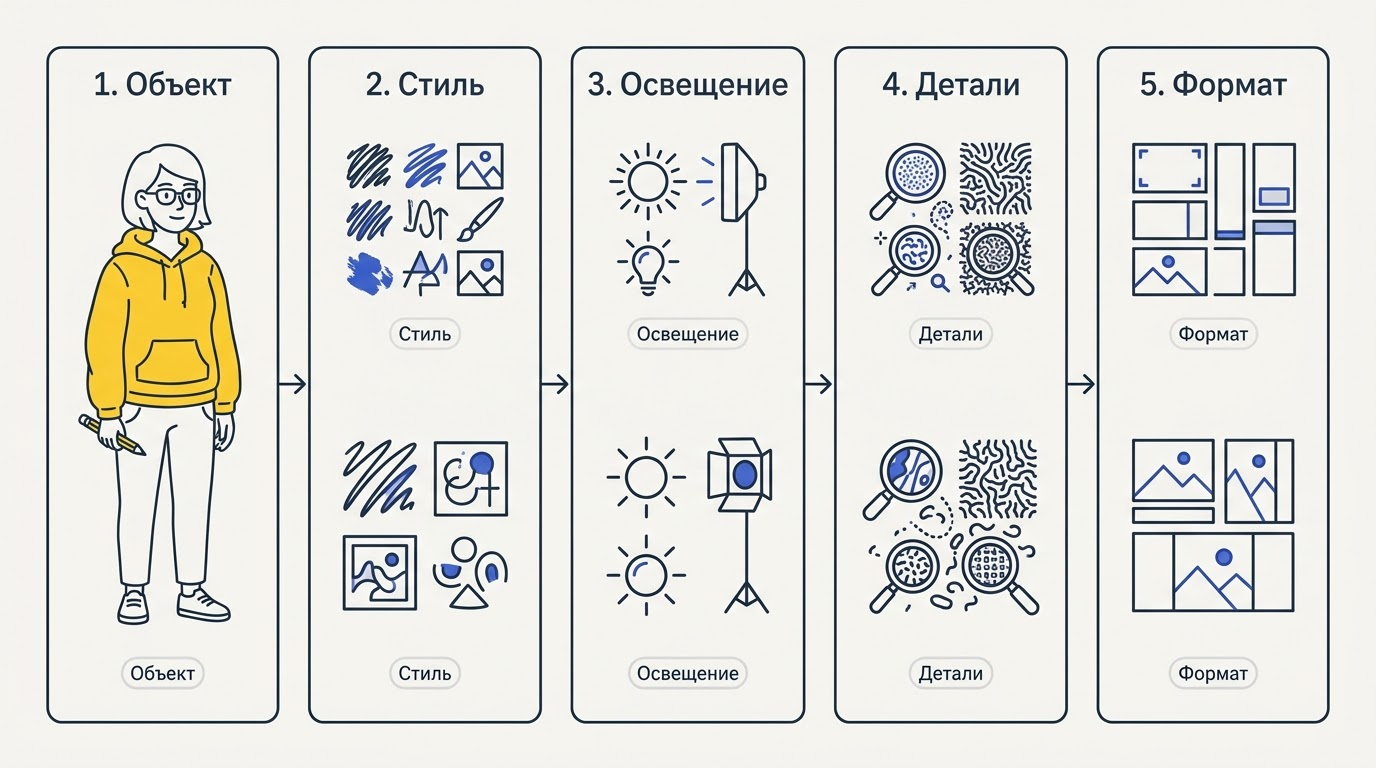
Хороший промпт описывает по порядку главный объект, фон, стиль, освещение, ракурс, настроение и формат — а нужный текст на изображении берётся в кавычки. Чем конкретнее каждый из этих элементов, тем точнее результат: расплывчатое «нарисуй кота» и детальное описание дают принципиально разный уровень контроля над картинкой. Для понимания общей структуры текстового промпта полезно изучить принципы, которые работают и в других ИИ-инструментах.
Формула промпта по шагам
- Главный объект и действие. Опишите, кто или что в кадре и что происходит: «молодая женщина сидит за столом с ноутбуком».
- Окружение и фон. Укажите место и обстановку: «уютное кафе с кирпичными стенами и большими окнами».
- Стиль. Назовите визуальный жанр: «фотореалистичный снимок», «акварельная иллюстрация», «3D-рендер в стиле Pixar».
- Свет и время суток. «Мягкий утренний свет, солнечные блики через окно».
- Ракурс и композиция. «Вид сбоку, правило третей, крупный план лица».
- Настроение и палитра. «Тёплые тона, спокойная атмосфера, приглушённые цвета #F5E6D0».
- Формат. «Горизонтальный 16:9» или «квадрат 1024×1024, прозрачный фон».
Русский или английский
Модель одинаково принимает запросы на обоих языках, но на английском точнее считывает нюансы операторских терминов, названий стилей и технических параметров съёмки. Сложные сцены с несколькими объектами и специфическим стилем лучше описывать по-английски; простые бытовые запросы уверенно работают на русском.
Если результат не устраивает по стилю — попробуйте продублировать промпт на английском: часто это сразу даёт ощутимую разницу в детализации и точности интерпретации.
Профессиональные приёмы
Фотографические термины резко повышают реализм: «85mm portrait lens», «f/1.4 bokeh», «golden hour lighting», «low angle shot». Указание материалов и фактур — «матовый металл», «грубая льняная ткань», «глянцевая керамика» — работает так же хорошо.
Текст на картинке пишите строго в кавычках внутри промпта: «нарисуй упаковку с надписью «ORGANIC COFFEE»». Без кавычек слова воспринимаются как описание смысла, а не буквальный текст для воспроизведения.
Негативный промпт
В конце запроса перечислите, чего быть не должно: «без лишних объектов, без деформаций рук, без текста на фоне, без размытых лиц». Это прямая инструкция модели избегать типичных артефактов — и она действительно снижает частоту кривых пальцев и задвоенных деталей.
Негативный промпт не требует специального синтаксиса: достаточно добавить перечисление через запятую в конце основного описания или отдельной фразой «Avoid:».
Редактирование, референсы и повторяемость результата
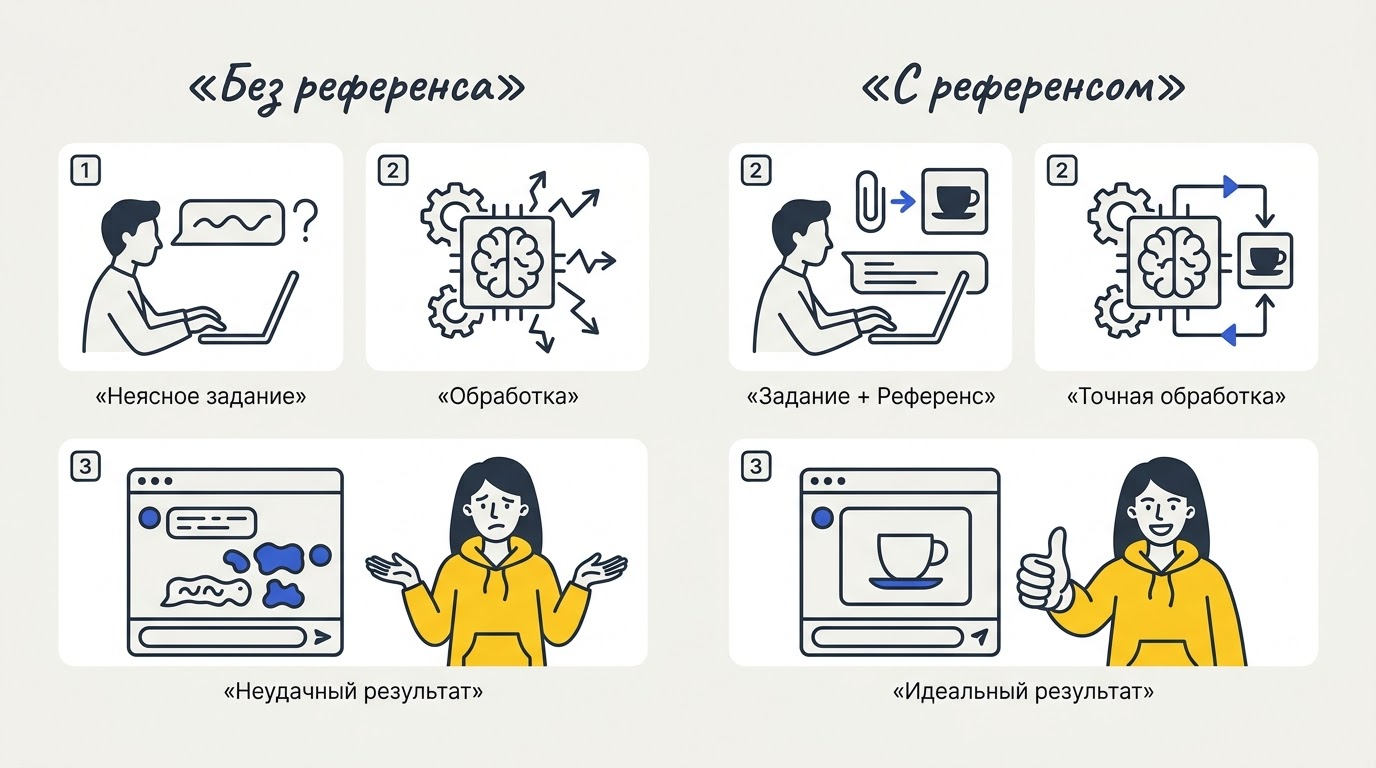
Изображение можно дорабатывать, не начиная с нуля: GPT Image принимает картинку на вход и правит её по текстовому описанию в рамках того же диалога. Это работает и с загруженными фотографиями, и с ранее сгенерированными изображениями — модель воспринимает их как отправную точку.
Правка по словам
Точечные изменения задаются короткими уточняющими сообщениями поверх готовой картинки: «замени фон на закат», «переведи в чёрно-белый», «добавь надпись «SALE» в правый верхний угол». Чем конкретнее и лаконичнее формулировка, тем меньше риск, что модель пересоберёт всю сцену целиком.
Длинное сообщение с несколькими изменениями одновременно — распространённая ошибка: модель может выполнить одно и проигнорировать остальные. Лучше делать правки последовательно, по одному параметру за раз.
Работа с загруженным фото
Прикреплённое изображение можно использовать как референс стиля, композиции или объекта трансформации: «сделай в стиле этой акварели», «замени фон на этой фотографии на горный пейзаж». Модель считывает визуальный контекст и применяет его к новой генерации.
Фотографии реальных людей модель обрабатывает с ограничениями: запросы на изменение внешности, возраста или идентичности конкретного человека часто отклоняются системой модерации. Стилизация — «превратить в мультяшного персонажа» — в большинстве случаев работает.
OpenAI later said that over 130 million users around the world had created more than 700 million images in the first weekWikipedia
Как добиться повторяемости
Полностью идентичный результат при повторном запросе невозможен — каждая генерация уникальна. Но приблизить новые варианты к удачному можно: сохраните промпт целиком, менять только один параметр за раз и просите «ещё один вариант в том же стиле» вместо нового запроса с нуля.
- Сохраняйте удачные промпты целиком — даже незначительные изменения слов меняют картинку
- Меняйте по одному параметру за итерацию
- Просите «variation of this» вместо нового описания
- Используйте референсное изображение, если нужен конкретный стиль
Почему картинка не генерируется и как это исправить
Генерация срывается по четырём основным причинам: исчерпан суточный лимит, сработала модерация, перегружены серверы OpenAI или нестабильно соединение. Разобраться в причине помогает само сообщение об ошибке: ChatGPT обычно указывает, что именно пошло не так.
Частые причины
Лимит — самая частая причина: тариф Free ограничивает генерацию лишь несколькими изображениями в сутки, и после их исчерпания модель просто отказывается рисовать до сброса скользящего окна. Вторая по частоте — модерация: ChatGPT отказывает в генерации при запросе реальных людей, насилия, наготы или чужого бренда, даже если формулировка кажется нейтральной.
Технические сбои и пиковая нагрузка — третья причина: в часы высокой активности серверы OpenAI могут возвращать ошибку без объяснений. Наконец, VPN с нестабильным соединением или смена IP в середине сессии иногда прерывают генерацию — особенно на длинных запросах.
Что делать
Если пришёл отказ из-за модерации — переформулируйте промпт: уберите имена реальных людей и брендов, замените конкретные названия описательными образами. Если причина в лимите — проверьте, когда именно были предыдущие генерации, и подождите сброса скользящего окна от самой ранней из них.
При технической ошибке без явной причины помогает последовательность: перезагрузите страницу, начните новый чат (иногда длинная история диалога мешает генерации), проверьте стабильность VPN. Если промпт очень длинный или содержит противоречивые инструкции — упростите сцену: уберите второстепенные детали и сформулируйте ключевой объект одним предложением.
Права, водяные знаки и метки происхождения
Все изображения из ChatGPT несут метаданные C2PA и невидимый водяной знак SynthID, а права на использование OpenAI передаёт пользователю — с рядом важных оговорок. Видимого логотипа или подписи «создано ИИ» на картинке нет, но происхождение можно верифицировать техническими средствами.
OpenAI добавляет к изображениям из ChatGPT метаданные C2PA (Content Credentials) и невидимый водяной знак SynthID для подтверждения ИИ-происхождения. Content Credentials — это стандарт коалиции C2PA, который вшивает в файл цифровую подпись с информацией о том, каким инструментом создано изображение. SynthID — технология Google DeepMind, работающая на уровне пикселей и сохраняющаяся при ресайзе и лёгком сжатии. Проверить метаданные C2PA можно на сайте contentcredentials.org; SynthID читается только специализированным детектором.
Важный нюанс: метаданные C2PA теряются при пересохранении через сторонние редакторы, скриншоте или конвертации в другой формат. После таких операций файл формально становится неверифицируемым — хотя SynthID при умеренных изменениях может сохраниться.
По условиям использования OpenAI пользователь владеет созданными изображениями и вправе использовать их, в том числе коммерчески, при соблюдении политики платформы. Ограничение одно: нельзя выдавать ИИ-изображения за работу человека в контексте, где это создаёт обман. При этом в ряде юрисдикций — в том числе в России и США — изображения, созданные без творческого вклада человека, не получают полноценной авторско-правовой охраны: суды и регуляторы пока не выработали единой позиции. Тем, кто хочет работать с изображениями программно и без ограничений интерфейса, стоит изучить прямые запросы к API OpenAI — там доступны дополнительные параметры и поштучная тарификация.
Доступ из России, оплата и альтернативы
Официального способа зарегистрироваться и оплатить ChatGPT из России напрямую нет: российские карты не принимаются, а регистрация требует номера телефона из страны, где сервис доступен. Тем не менее бесплатный тариф Free с небольшим суточным лимитом изображений остаётся доступным при стабильном VPN и нероссийском IP.
Для доступа к Plus (~$20/мес) с повышенным лимитом изображений из России официального способа оплаты нет: OpenAI не принимает российские карты. OpenAI периодически блокирует аккаунты при подозрении в нарушении географических ограничений — особенно если IP часто меняется или совпадает с массово-используемыми VPN-серверами.
Если ChatGPT недоступен или лимитов не хватает, разумная альтернатива — российские генераторы изображений: Kandinsky от Сбера, Шедеврум от Яндекса и YandexART работают без VPN и принимают рублёвую оплату. Они уступают GPT Image в рендеринге текста и сложных сценах, но закрывают большинство бытовых задач. Для выбора между разными ИИ-инструментами полезно сравнение с Claude — другой крупной моделью с похожим набором функций.
FAQ
Какая нейросеть создаёт картинки в ChatGPT — DALL·E или GPT-4o?
С 25 марта 2025 года картинки в ChatGPT создаёт модель GPT Image 1, которая пришла на смену DALL·E 3. Она лучше справляется со сложными сценами и умеет надёжно встраивать читаемый текст прямо в изображение.
Может ли ChatGPT писать текст на картинке?
Да, GPT Image 1 умеет встраивать читаемый текст в изображение — это одно из ключевых отличий от прежней DALL·E 3. Чтобы результат был точным, пишите нужные слова в промпте в кавычках.
Сколько картинок в день можно сгенерировать на бесплатном тарифе?
Конкретное суточное число OpenAI официально не раскрывает: бесплатный тариф имеет существенно сниженный лимит по сравнению с платными подписками. При активной работе лимит исчерпывается быстро.
Можно ли загрузить своё фото и попросить изменить его?
Да, ChatGPT принимает загруженное изображение как референс и может редактировать его по текстовому описанию. Однако точность переноса деталей зависит от сложности запроса и ограничений по контенту.
Что такое негативный промпт и есть ли он в ChatGPT?
Негативный промпт — это явное указание того, чего не должно быть на картинке. В ChatGPT специального поля для него нет, но можно написать прямо в запросе: «без фона», «без людей», «не добавляй текст».
Почему ChatGPT отказывается создавать изображение?
Отказ происходит, если запрос нарушает правила контентной политики: насилие, обнажение, изображения реальных людей без их согласия и схожие темы. Попробуйте переформулировать запрос, убрав потенциально чувствительные элементы.
Кому принадлежат права на созданное изображение?
Согласно условиям OpenAI, пользователь получает права на использование сгенерированных изображений, в том числе в коммерческих целях. При этом OpenAI добавляет к каждому файлу метаданные C2PA и невидимый водяной знак SynthID, подтверждающие ИИ-происхождение.
Какое максимальное разрешение картинки в ChatGPT?
GPT Image 1 создаёт изображения в нескольких фиксированных размерах: квадратном, горизонтальном и вертикальном форматах. Максимальная сторона составляет 1536 пикселей.
-
Маршрут от Claude привёл подростка на «Вдоводел»
![Подросток в синей куртке и шлеме радостно смотрит маршрут в телефоне на вершине горы над городом]()
16-летний Брайс из Ванкувера проложил с Claude новый для себя маршрут на гору Краун. ![Подросток с рюкзаком неуверенно пробирается между валунами к крутому гребню]()
Разметки не было: вместо кулуара он попал на гребень «Вдоводел», куда ходят с верёвками. ![Испуганный подросток прижался к отвесной скале на узком уступе и звонит по телефону]()
Брайс застрял на уступе шириной около полутора метров: сзади обрыв, впереди почти отвесная стена. ![Спасатель спускается по верёвке к подростку на уступе, рядом вертолёт]()
Вертолёт не мог подойти к скале: спасатель спустился к Брайсу по верёвке, и его подняли на борт. ![Подросток в спасательном одеяле сидит у тропы с бумажной картой, рядом компас]()
Брайс винит себя, но тропы через ИИ больше не прокладывает. Спасатель: «Claude никогда не был в этих местах». -
950 агентов Claude нашли в ДНК вирусов загадочную систему
![Учёная в лаборатории смотрит на монитор со спиралями ДНК]()
Anthropic поручила Claude найти в огромной базе ДНК необычные ферменты. ![Учёная с планшетом смотрит на стену из сотен мониторов с ДНК]()
Около 950 агентов за 21 час собрали больше 200 тысяч ферментов и написали 20 отчётов. ![Учёная взволнованно показывает на повторяющийся узор в цепочке ДНК на экране]()
Один агент «на глаз» заметил рядом с ферментом повторы, как у CRISPR. Систему назвали ART. ![Учёная поднимает пробирку к свету, коллега задумчиво смотрит рядом]()
Что она делает, пока неизвестно. Пионер CRISPR Фэн Чжан назвал находку «по-настоящему интригующей». -
Anthropic запретила издеваться над Claude
![Женщина в очках сердито кричит на ноутбук и стучит кулаком по столу]()
Anthropic запретила «длительное и бессмысленное» жестокое обращение с Claude. ![Женщина спокойно спорит, разводя рукой перед ноутбуком]()
Речь о крайних случаях. Раздражение, споры, мрачные сюжеты и тесты под запрет не попадают. ![Удивлённая женщина смотрит на ноутбук со значком закрытой двери на экране]()
Главная защита прежняя: Claude сам завершает такой диалог. ![Женщина прикрепляет к доске календарь с обведённым днём]()
Правила действуют с 12 ноября. За нарушения доступ могут ограничить или закрыть. -
ИИ-видео с погибшим в суде: срок назначат заново
![Женщина в зале суда показывает планшет с лицом мужчины]()
В Аризоне сестра погибшего показала в суде видео, где ИИ-аватар брата прощает убийцу. ![Растроганный судья с рукой на груди за судейским столом]()
Судья дал максимальные 10,5 года и сказал, что ему «понравилось это видео». ![Три судьи апелляционного суда изучают документы]()
Апелляционный суд счёл приговор несправедливым: видео «не отражает реальных событий». ![Женщина читает своё заявление с листов за трибуной, планшет выключен]()
Срок назначат заново, а свой текст сестра прочитает сама, без видео. -
Журналист выпустил ИИ-песню от имени чужой группы
![Журналист в наушниках с хитрой улыбкой работает за ноутбуком]()
Журналист 404 Media сгенерировал песню в Udio по простому запросу. ![Трое музыкантов панк-группы в шоке смотрят в телефон]()
Трек вышел на подтверждённой странице панк-группы Lathe of Heaven в Spotify без ведома музыкантов. ![Журналист удивлённо разводит руками, вокруг висят значки музыкальных сервисов]()
Песня попала и в Apple Music, Tidal и Amazon Music — через давнюю лазейку в дистрибуции. ![Довольный мошенник ловит монеты, сыплющиеся из наушников, слушательница расстроена]()
Так мошенники зарабатывают на чужой славе. Площадки и дистрибьюторы ответственность не берут. -
Нейросеть научилась играть в «Точки» и обыгрывает автора
![Разработчик держит тетрадь в клетку с партией в точки]()
Разработчик учил нейросеть игре в «Точки» из школьной тетради — по примеру AlphaZero. ![Разработчик ночью смотрит на два монитора с партиями в точки]()
Сеть играла сама с собой: 30 поколений за полтора месяца, однажды девять пришлось выбросить. ![Разработчик радостно подпрыгивает перед монитором с выигранной партией]()
Ученик обыграл учителя, только когда поиск подняли с 800 до 1600 симуляций на ход. ![Разработчик смеётся, проиграв нейросети партию в точки]()
Теперь сложный уровень игры Just Dots стабильно обыгрывает автора на поле 20×20.
























